L’erreur sitemap « Impossible de récupérer » fait partie des messages de Search Console qui affolent le plus vite un propriétaire de site. Le fichier s’ouvre sans problème dans le navigateur, il est bien déclaré dans le robots.txt, il passe tous les validateurs, et pourtant Google affiche qu’il n’a pas pu le lire. Dans l’épisode 114 de son podcast Search Off the Record, publié le 1er octobre 2026, Google a enfin expliqué ce qui se cache derrière ce message. Et la réponse a de quoi surprendre, parce qu’elle ne parle pas toujours de technique.
En bref
Martin Splitt et John Mueller, de l’équipe Search Relations de Google, ont consacré un épisode de leur podcast aux sitemaps, publié le 1er octobre 2026.
Selon John Mueller, le message « Impossible de récupérer » couvre deux situations : un manque de temps pour explorer le site, ou un faible besoin de Google de l’explorer.
Ce besoin d’exploration dépend très souvent de la qualité perçue du site, et Google peut alors ignorer un sitemap parfaitement valide.
Avant de toucher au fichier, il faut vérifier dans Search Console si les pages du site sont indexées malgré l’erreur.
Obtenir le résumé de cet article par une IA
Ce que Google dit de l’erreur sitemap « Impossible de récupérer »
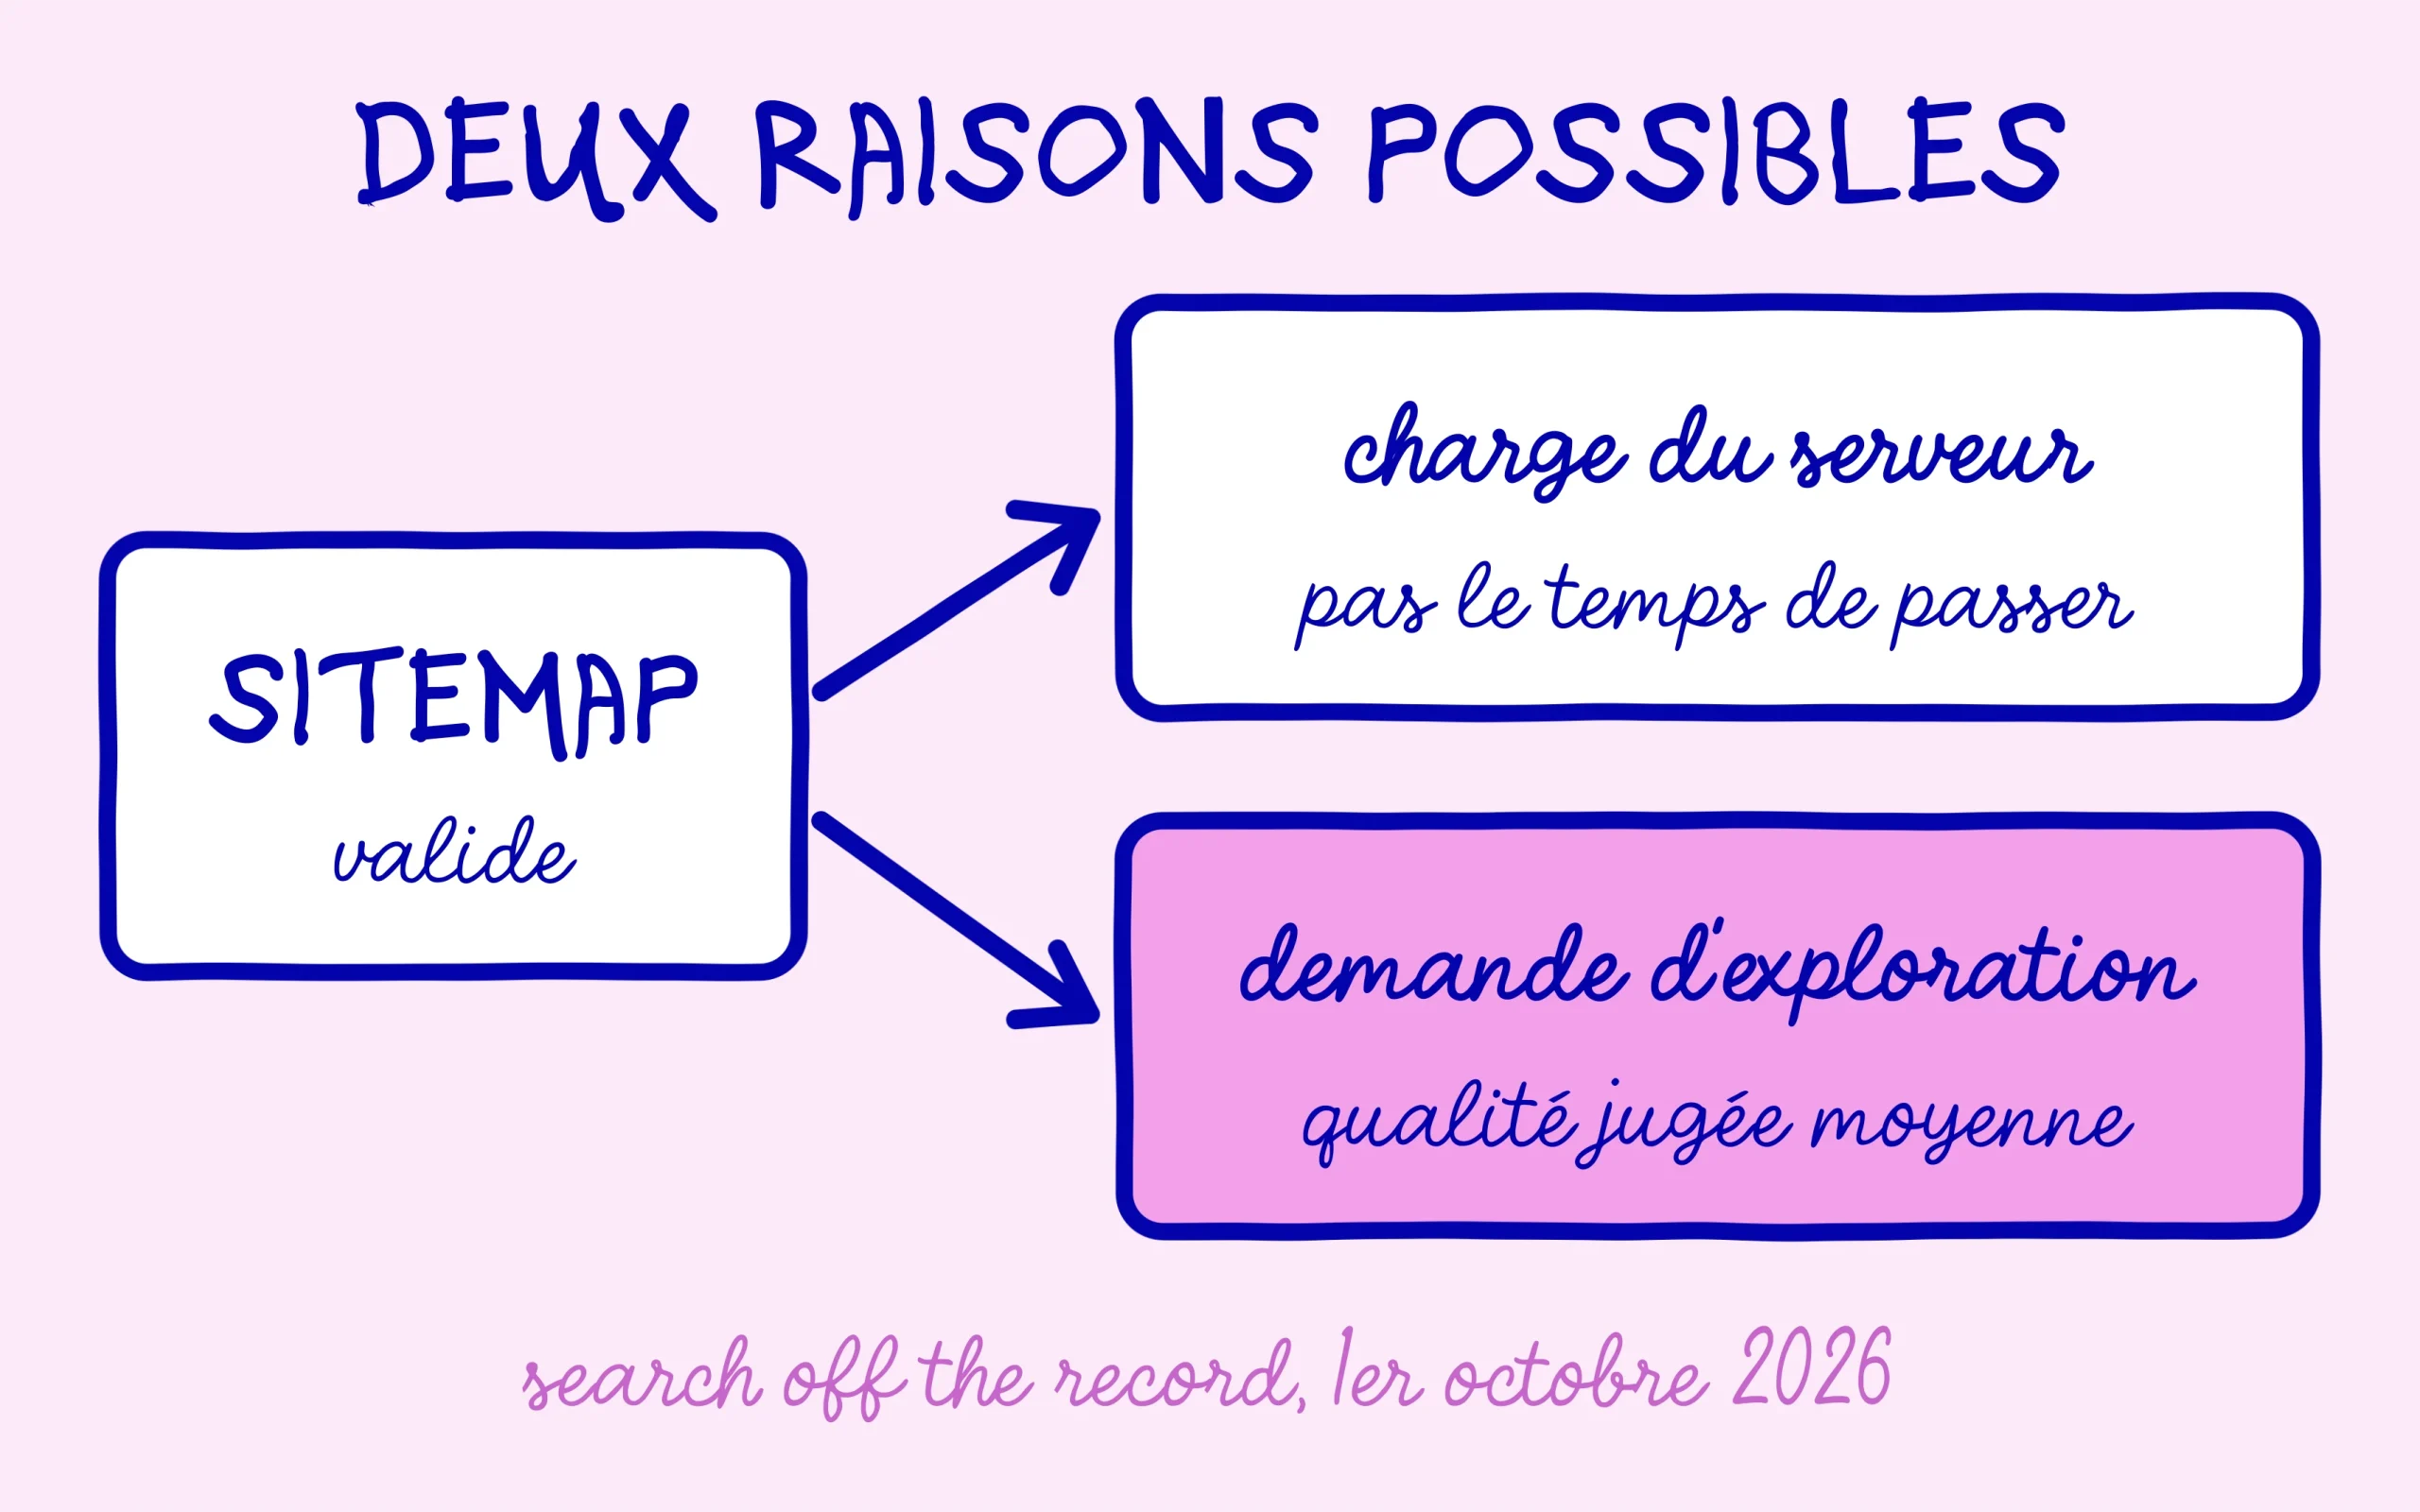
La question a été posée par Martin Splitt lui-même, dans l’épisode « Do sitemaps still matter? » de Search Off the Record. Il décrit exactement le cas qui remplit les forums : un sitemap valide, accessible publiquement, déclaré dans le robots.txt, et une Search Console qui affiche quand même l’erreur sitemap. John Mueller répond que Google voit ce cas « très souvent » sur les forums d’aide, et qu’il s’explique principalement de deux façons.
La première tient à la charge d’exploration. Google limite le volume de pages qu’il explore sur chaque site, et il peut arriver que ses robots n’aient tout simplement pas eu le temps d’aller chercher le fichier, parce qu’ils étaient occupés ailleurs. Dans ce cas, Search Console affiche le même message que pour un vrai problème d’accès.
La seconde est plus délicate à entendre. Mueller parle de la demande d’exploration, c’est-à-dire de l’envie qu’a Google d’explorer un site. Quand ses systèmes estiment qu’ils ont déjà assez de pages d’un site, ils sautent le sitemap. Et cette demande d’exploration, explique-t-il, repose très souvent sur la qualité perçue du site. Une erreur sitemap peut donc signaler un site que Google juge moyen.
La porte reste ouverte, précise Mueller : si la qualité du site s’améliore nettement avec le temps, Google finira par utiliser ce sitemap. La page d’aide de Google sur le rapport Sitemaps de Search Console liste de son côté les causes techniques classiques du statut « Impossible de récupérer le sitemap » : blocage par le robots.txt, erreur 404, action manuelle ou serveur indisponible. Les deux lectures se complètent, et le bon diagnostic consiste à éliminer d’abord la technique.
Quand le message signale un problème de qualité
Face à une erreur sitemap, le réflexe naturel d’un débutant est de croire que le fichier est cassé, de le régénérer, de le soumettre à nouveau, puis de recommencer le lendemain. Si la cause vient de la demande d’exploration, aucune de ces manipulations ne change quoi que ce soit. Le fichier n’a jamais été le problème, et le resoumettre ne donne pas à Google une raison de plus de venir.
C’est la même logique que celle décrite dans l’article sur le sitemap qui ne fait pas revenir Google plus souvent. Un sitemap indique à Google où se trouvent les pages, et le nombre de visites accordées au site se décide ailleurs. Ce rythme dépend de ce que Google pense du contenu, et c’est là que se trouve le vrai levier.
L’épisode apporte aussi quelques précisions utiles sur le fichier lui-même. Google a abandonné depuis longtemps les champs de priorité et de fréquence de mise à jour, que tout le monde réglait au maximum. Il continue en revanche à lire la date de dernière modification, à condition que ces dates paraissent crédibles : un site qui affiche la date du jour sur toutes ses URL voit Google se rabattre sur les URL elles-mêmes. Les limites restent de 50 000 URL et 50 Mo non compressés par fichier.
Mueller rappelle aussi un rôle souvent oublié du fichier : aider Google à choisir la bonne version d’une page. Quand plusieurs adresses affichent un contenu très proche, celle qui figure dans le sitemap a un peu plus de chances d’être retenue comme version principale. D’où l’intérêt de n’y lister que les adresses définitives, sans paramètres de suivi ni dates ajoutées dans l’URL. Une erreur sitemap qui dure prive donc aussi Google de cet indice, ce qui donne une raison de plus de la traiter sérieusement plutôt que de l’ignorer.
Faut-il encore un sitemap sur un petit site ? Mueller reconnaît que Google peut explorer un site de quelques pages sans lui. Il recommande malgré tout de le laisser activé, parce que la plupart des CMS le génèrent par défaut et qu’il ne fait aucun tort, même sur un site qui restera petit. Sur WordPress, le tutoriel pour créer un sitemap XML en cinq minutes reste valable tel quel.
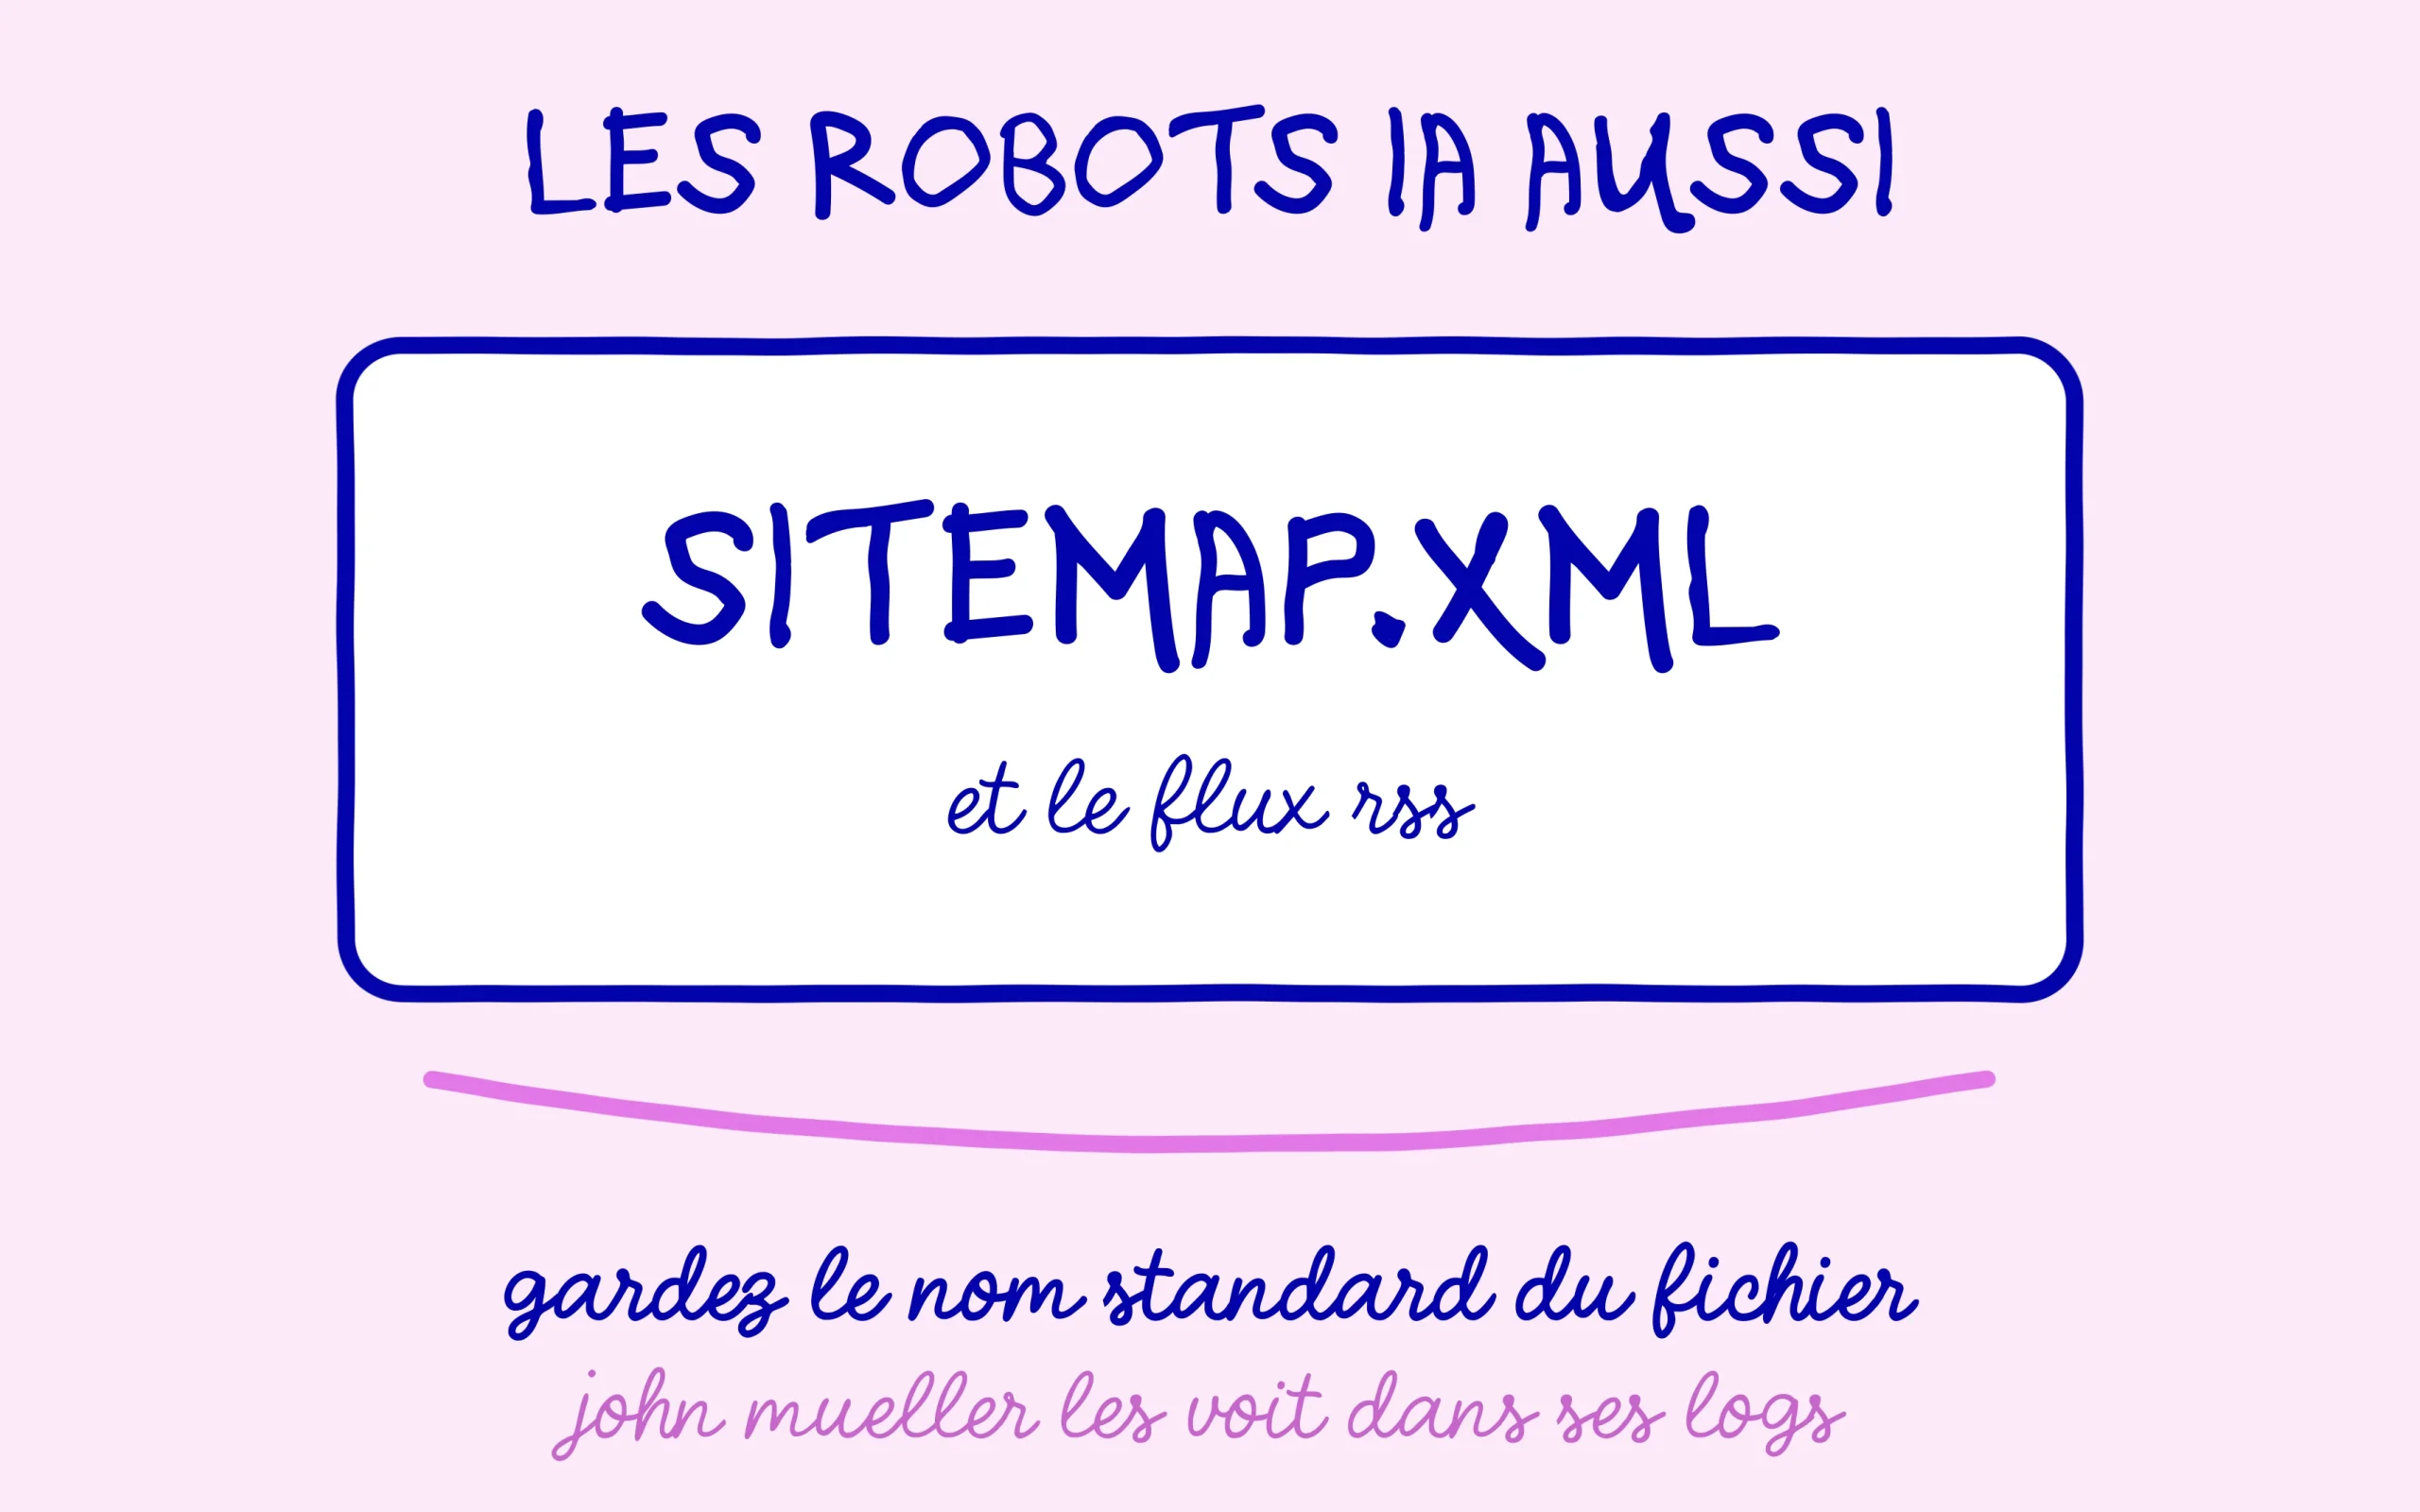
Un dernier passage concerne directement la visibilité dans les IA. Mueller explique avoir vu dans les journaux de son serveur des robots d’IA lire son fichier sitemap et son flux RSS. Ces robots n’ont pas d’équivalent de Search Console pour qu’on leur soumette un fichier, donc il conseille de garder le nom standard, sitemap.xml, ou de s’appuyer sur le flux RSS que la plupart des sites publient déjà. Un sitemap rebaptisé d’un nom exotique reste invisible pour eux.
Découvrir l’agence SEO Noobies
Le diagnostic à faire avant de toucher au fichier
Première étape, la vérification technique, parce qu’elle est rapide. Ouvrir l’adresse du sitemap dans une fenêtre de navigation privée confirme qu’il est accessible sans connexion. Vérifier ensuite que le robots.txt ne bloque pas le fichier et que l’adresse déclarée dans Search Console est exactement la même que celle du site, avec ou sans « www », en https. Si l’une de ces étapes coince, la cause est trouvée.
Deuxième étape, regarder les pages plutôt que le fichier. Le rapport d’indexation des pages et l’outil d’inspection d’URL montrent si les pages du site sont indexées malgré l’erreur sitemap. Si c’est le cas, Google trouve les pages par d’autres chemins, les liens internes notamment, et l’erreur a peu de conséquences concrètes. Le guide pour vérifier l’indexation de votre site dans Google détaille la marche à suivre.
Troisième étape, si tout est propre techniquement et que beaucoup de pages restent hors de l’index, la piste de la qualité devient la plus probable. Le travail porte alors sur le contenu : regrouper les pages trop minces, enrichir celles qui répondent mal à la question posée, supprimer ou désindexer ce qui n’apporte rien au lecteur. Le sitemap redeviendra utile quand Google aura envie de revenir.
Rien n’oblige à attendre la fin de ce chantier pour garder le fichier en place. Mieux vaut le laisser déclaré, continuer à publier régulièrement, et revenir sur le rapport Sitemaps toutes les deux ou trois semaines. Un statut qui passe à « Opération effectuée » sans qu’on ait touché au fichier est souvent le premier signe que Google commence à regarder le site d’un autre œil.
Continuez de progresser sur SEO Noobies.