Un phénomène discret commence à remonter dans les discussions entre praticiens : la recherche IA fait ressortir des contenus que tout le monde croyait enterrés. Un article critique publié il y a dix ans, une page d’avis périmée, un billet de blog qui décrit une version de votre activité qui n’existe plus, tout cela peut réapparaître dans une réponse de ChatGPT, de Perplexity ou d’un AI Overview de Google. Le mécanisme est différent de ce qu’on connaissait avec le référencement classique, où un vieux contenu finissait par glisser hors des premières pages et par disparaître des radars. Ici, l’ancienneté ne protège plus. Voilà pourquoi ce sujet mérite l’attention de n’importe qui gère un site, une marque ou même un simple nom professionnel.
En bref
Les moteurs de réponse IA citent d’anciens articles jugés fiables même quand ils ne rankent plus sur Google depuis des années.
Un contenu négatif ou périmé peut ainsi retrouver une visibilité massive dans les réponses générées, sans aucun signal d’alerte côté trafic.
Les articles de presse portent des signaux d’autorité forts que les systèmes IA continuent de considérer comme dignes de confiance, quelle que soit leur date.
La parade consiste à surveiller sa marque sur les plateformes IA chaque mois et à publier du contenu frais que les moteurs préféreront citer.
Résumer cet article avec une IA
ChatGPTPourquoi la recherche IA déterre ce que Google avait enterré
Le référencement classique a une propriété rassurante : le temps fait son travail. Une page qui ne reçoit plus de liens, plus de clics et plus de mises à jour descend progressivement dans les profondeurs des résultats, et le tort qu’elle pouvait causer s’éteint avec elle. La recherche IA casse cette mécanique. Un système comme ChatGPT ou Perplexity ne classe pas des pages, il sélectionne des sources qu’il considère fiables pour construire une réponse. Et cette sélection repose largement sur des signaux d’autorité qui ne s’usent pas avec le temps.
Concrètement, un article de presse garde son statut de source de confiance des années après sa publication. Le média qui l’a publié conserve son autorité de domaine, la page reste indexée, et le système IA la traite comme un document crédible même si l’information qu’elle contient est périmée depuis longtemps. Un article négatif vieux de quinze ans peut déclencher un problème de réputation aujourd’hui, simplement parce qu’une IA le juge citable. La logique rejoint ce qui avait été observé quand Google avait clarifié qu’il ne fallait pas de site séparé pour être lu par les IA : les moteurs génératifs travaillent sur le même web que tout le monde, avec leurs propres critères de sélection.
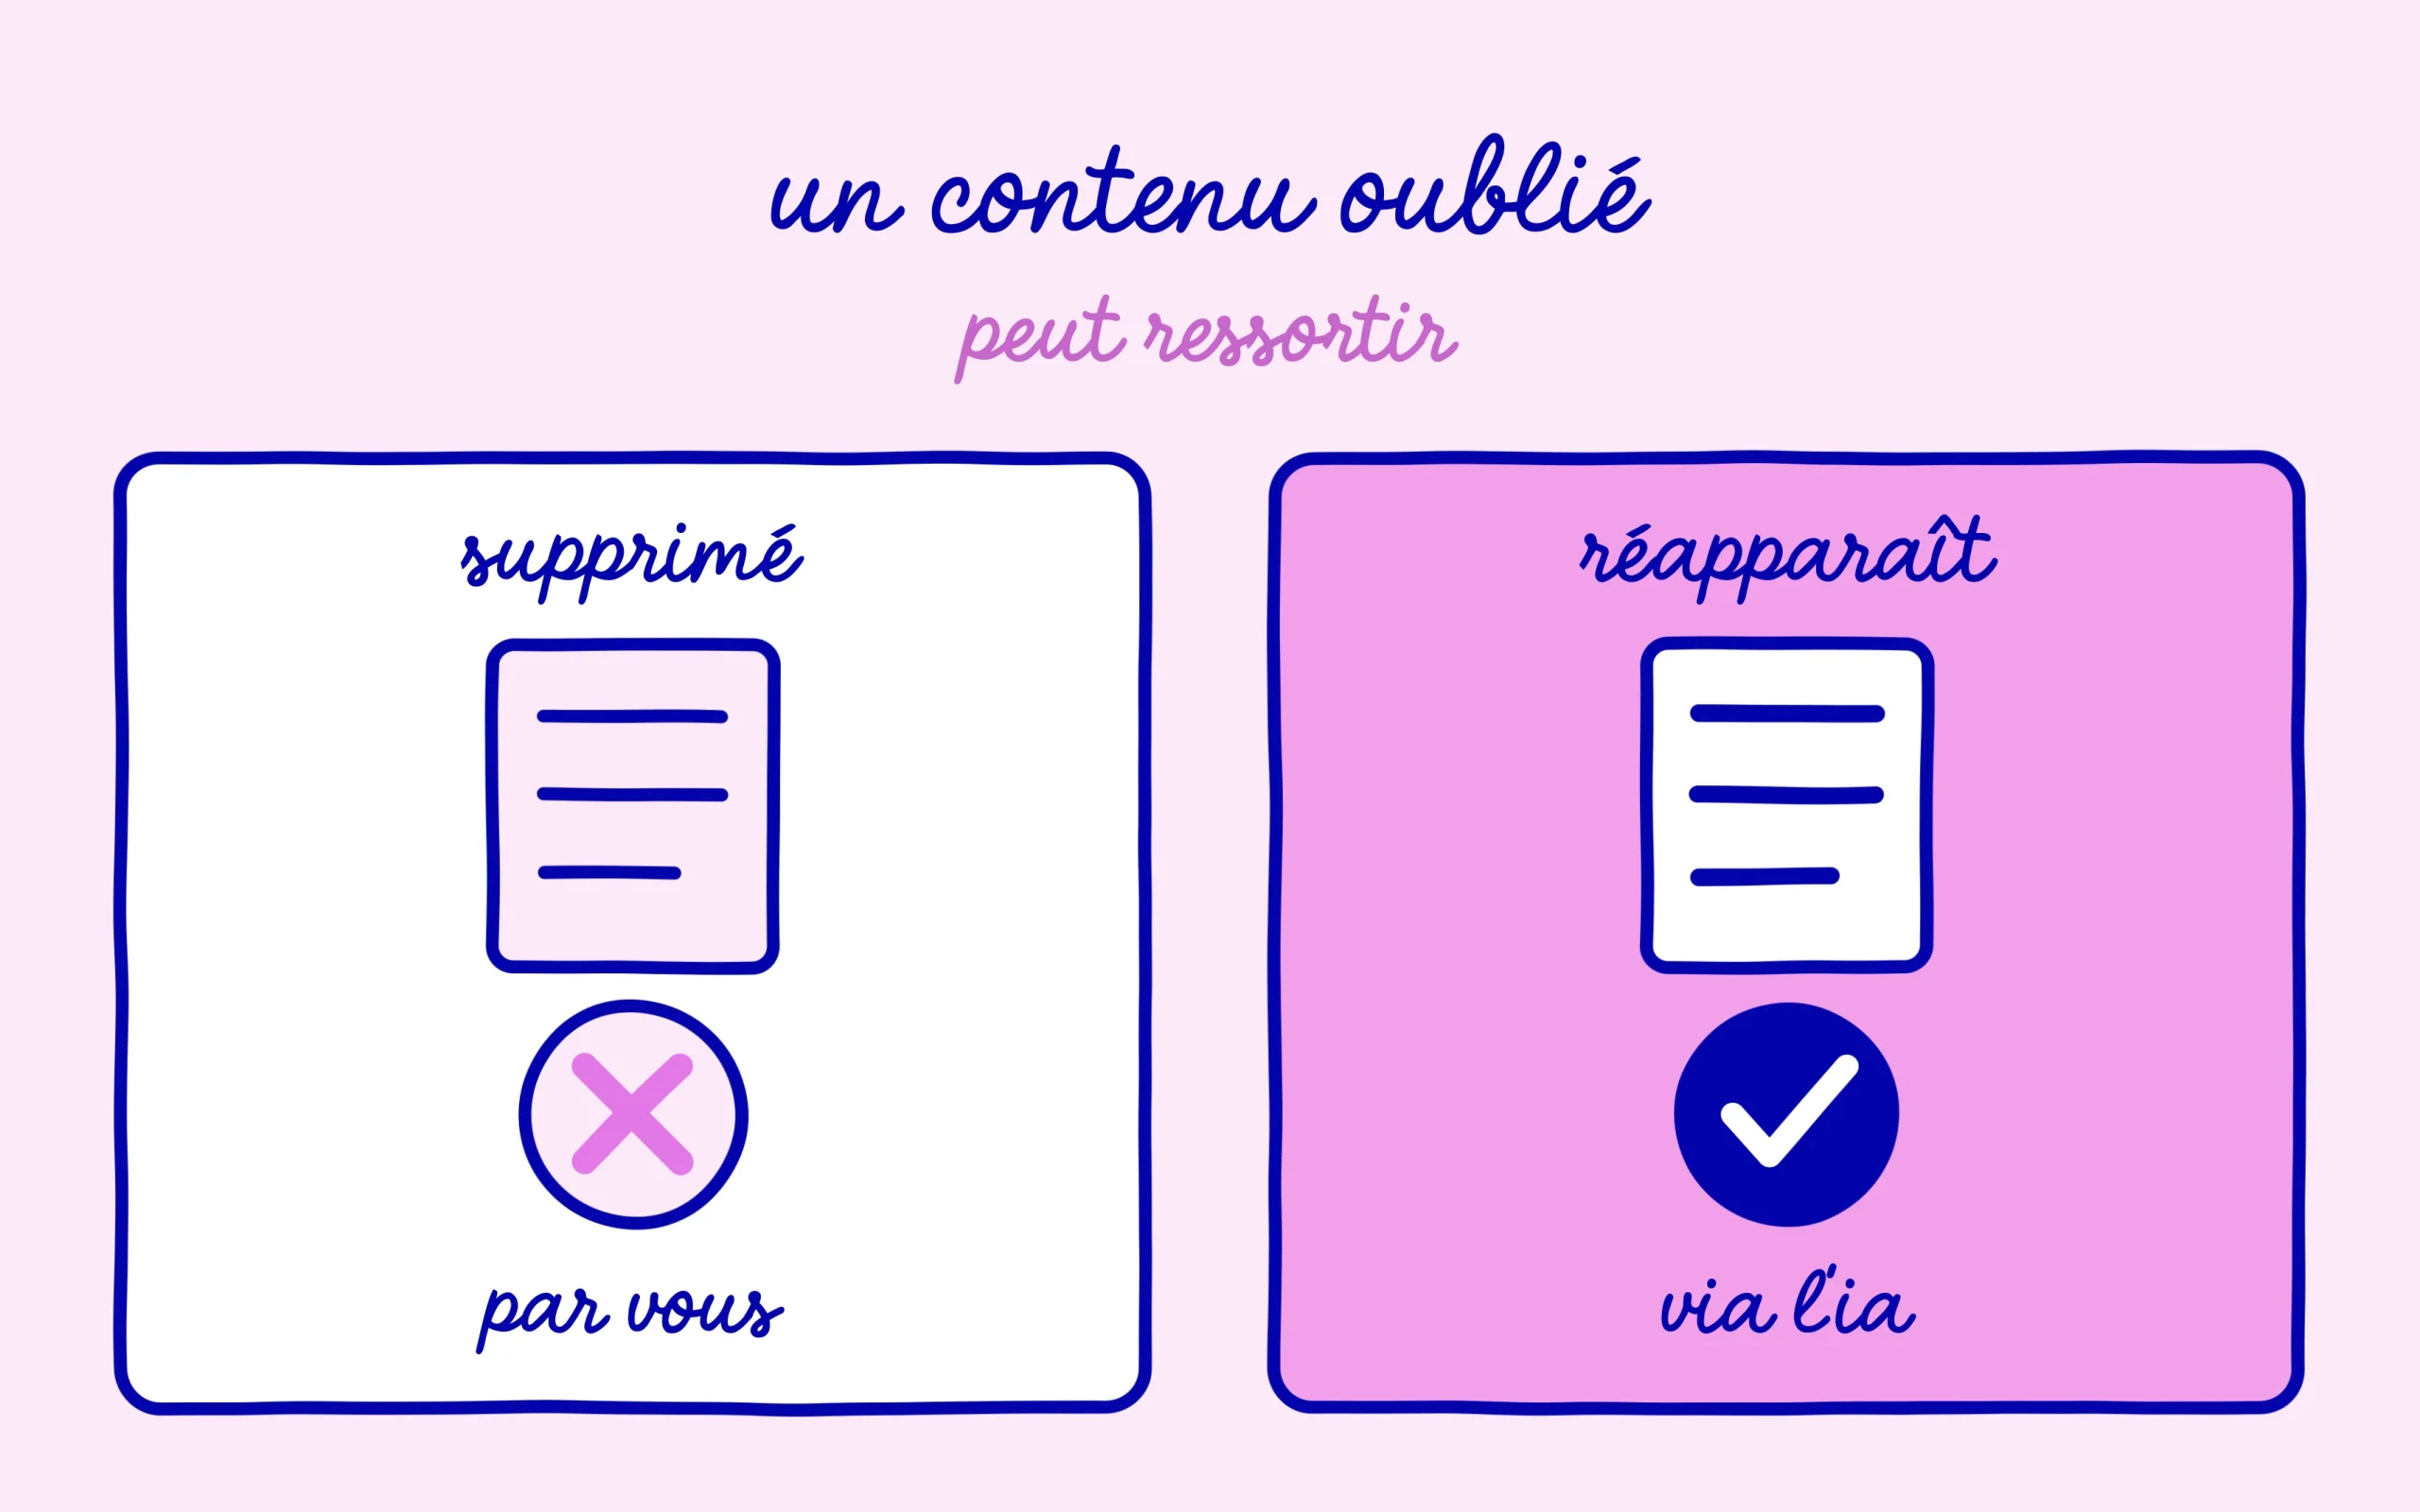
Un cas concret circule dans le secteur : une chaîne d’épiceries du Midwest américain avait connu un problème de service client au milieu des années 2010, couvert à l’époque par un article de presse locale. Des années plus tard, les AI Overviews de Google ont recommencé à citer cet article de façon répétée dans les réponses concernant l’enseigne. La page avait pourtant disparu des résultats de recherche classiques depuis longtemps. Le contenu n’était pas redevenu pertinent, il était juste resté disponible et estampillé fiable. Et ce genre de résurrection ne prévient pas : l’enseigne n’a rien changé à son site, rien publié de nouveau, la bascule s’est faite entièrement du côté du moteur de réponse.
Ce que ça change quand on débute et qu’on a peu de contenu
Pour un site jeune ou une petite activité, le sujet peut sembler lointain. Il ne l’est pas, pour une raison simple : moins il existe de contenu à votre sujet, plus chaque document disponible pèse lourd dans ce que la recherche IA retient de vous. Une marque installée avec des centaines d’articles récents dilue naturellement une vieille page critique. Un débutant avec trois mentions en ligne n’a aucun contrepoids, et la recherche IA composera sa réponse avec ce qu’elle trouve, même si ce qu’elle trouve date.
Le déplacement est le même que celui documenté sur la montée des recherches Google sans clic : la visibilité se joue de plus en plus dans la réponse elle-même, avant tout clic vers un site. Or personne ne consulte spontanément ce que la recherche IA raconte de sa propre marque. Le trafic du site ne bouge pas, les positions Google restent stables, et pendant ce temps une réponse générée peut resservir une information fausse ou datée à chaque requête sur votre nom. L’angle mort est total tant qu’on ne va pas vérifier soi-même.
Toutefois, il faut garder la mesure. La plupart des sites débutants n’ont tout simplement pas de contenu négatif ancien à leur sujet, et le scénario le plus courant reste celui du contenu périmé plutôt que du contenu hostile : une ancienne offre, un ancien positionnement, une page produit retirée. C’est moins dramatique qu’une crise de réputation, mais une IA qui décrit votre activité avec trois ans de retard fait perdre des clients aussi sûrement qu’un avis négatif.
Surveiller, publier, corriger : la parade en trois gestes
La première action est un réflexe de surveillance mensuel. Interroger les principales plateformes IA sur votre marque, votre nom ou votre produit, et noter ce qui est cité en source. Des outils comme Otterly.ai, Mangools ou Ahrefs Brand Radar se spécialisent dans ce suivi des citations et du sentiment dans les réponses génératives. Pour un débutant, une simple vérification manuelle chaque mois sur ChatGPT, Perplexity et Google suffit déjà à repérer un problème avant qu’il ne s’installe.
La deuxième action consiste à occuper le terrain avec du contenu que les IA préféreront citer. Publier des données originales, des analyses documentées, du contenu de fond avec des faits vérifiables, et diversifier les sources crédibles qui parlent de vous. La logique est préventive : plus l’écosystème de contenu frais autour de votre marque est dense, moins un vieux document isolé a de chances d’être sélectionné comme source. Ce travail rejoint la préparation à l’arrivée des AI Overviews en France (déployés depuis le 22 juillet 2026), qui va étendre ce mécanisme de citation à tout le marché francophone.
La troisième action traite les cas les plus gênants à la source. Quand un contenu est factuellement faux ou obsolète, contacter l’éditeur pour demander une mise à jour ou un retrait reste la voie la plus directe, et des services comme removenews.ai se sont montés pour générer ces demandes de retrait personnalisées auprès des éditeurs. Les outils de gestion de réputation classiques gardent par ailleurs leur utilité en parallèle. Le geste global à retenir tient en une phrase : on passe de la suppression du négatif à l’influence des sources que les systèmes IA utilisent pour répondre. C’est un travail continu, pas une opération ponctuelle, et ceux qui le commencent maintenant prennent une longueur d’avance sur un problème que la majorité découvrira trop tard.