La recherche IA repose aujourd’hui sur une mécanique en deux temps que presque personne n’explique aux débutants : une première étape ratisse large et remonte quelques centaines de pages, une seconde les relit une par une pour décider de l’ordre final. Des chercheurs de Google DeepMind, de l’université du Massachusetts à Amherst et de celle du Texas à Austin proposent de remplacer cet enchaînement par un seul modèle de langage. Le papier s’appelle Autoregressive Ranking et il est public depuis quelques jours. Rien de tout cela ne tourne dans Google aujourd’hui, et c’est justement pour ça qu’il vaut la peine de le regarder maintenant plutôt que le jour où ça basculera.
En bref
Des chercheurs de Google DeepMind et de deux universités américaines proposent un système de classement baptisé Autoregressive Ranking, ou ARR.
Il remplace les deux étapes qui structurent la recherche IA aujourd’hui, un tri rapide puis un tri précis, par un modèle de langage unique produisant directement une liste ordonnée.
Dans les tests publiés, ARR atteint la qualité de l’étape précise tout en évitant son coût de calcul, avec un résultat en retrait sur la recherche de produits.
Aucun déploiement n’est annoncé dans Google Search, il s’agit pour l’instant d’un travail de recherche publié sur arXiv.
Résumer cet article avec une IA
ChatGPTComment la recherche IA classe les pages aujourd’hui
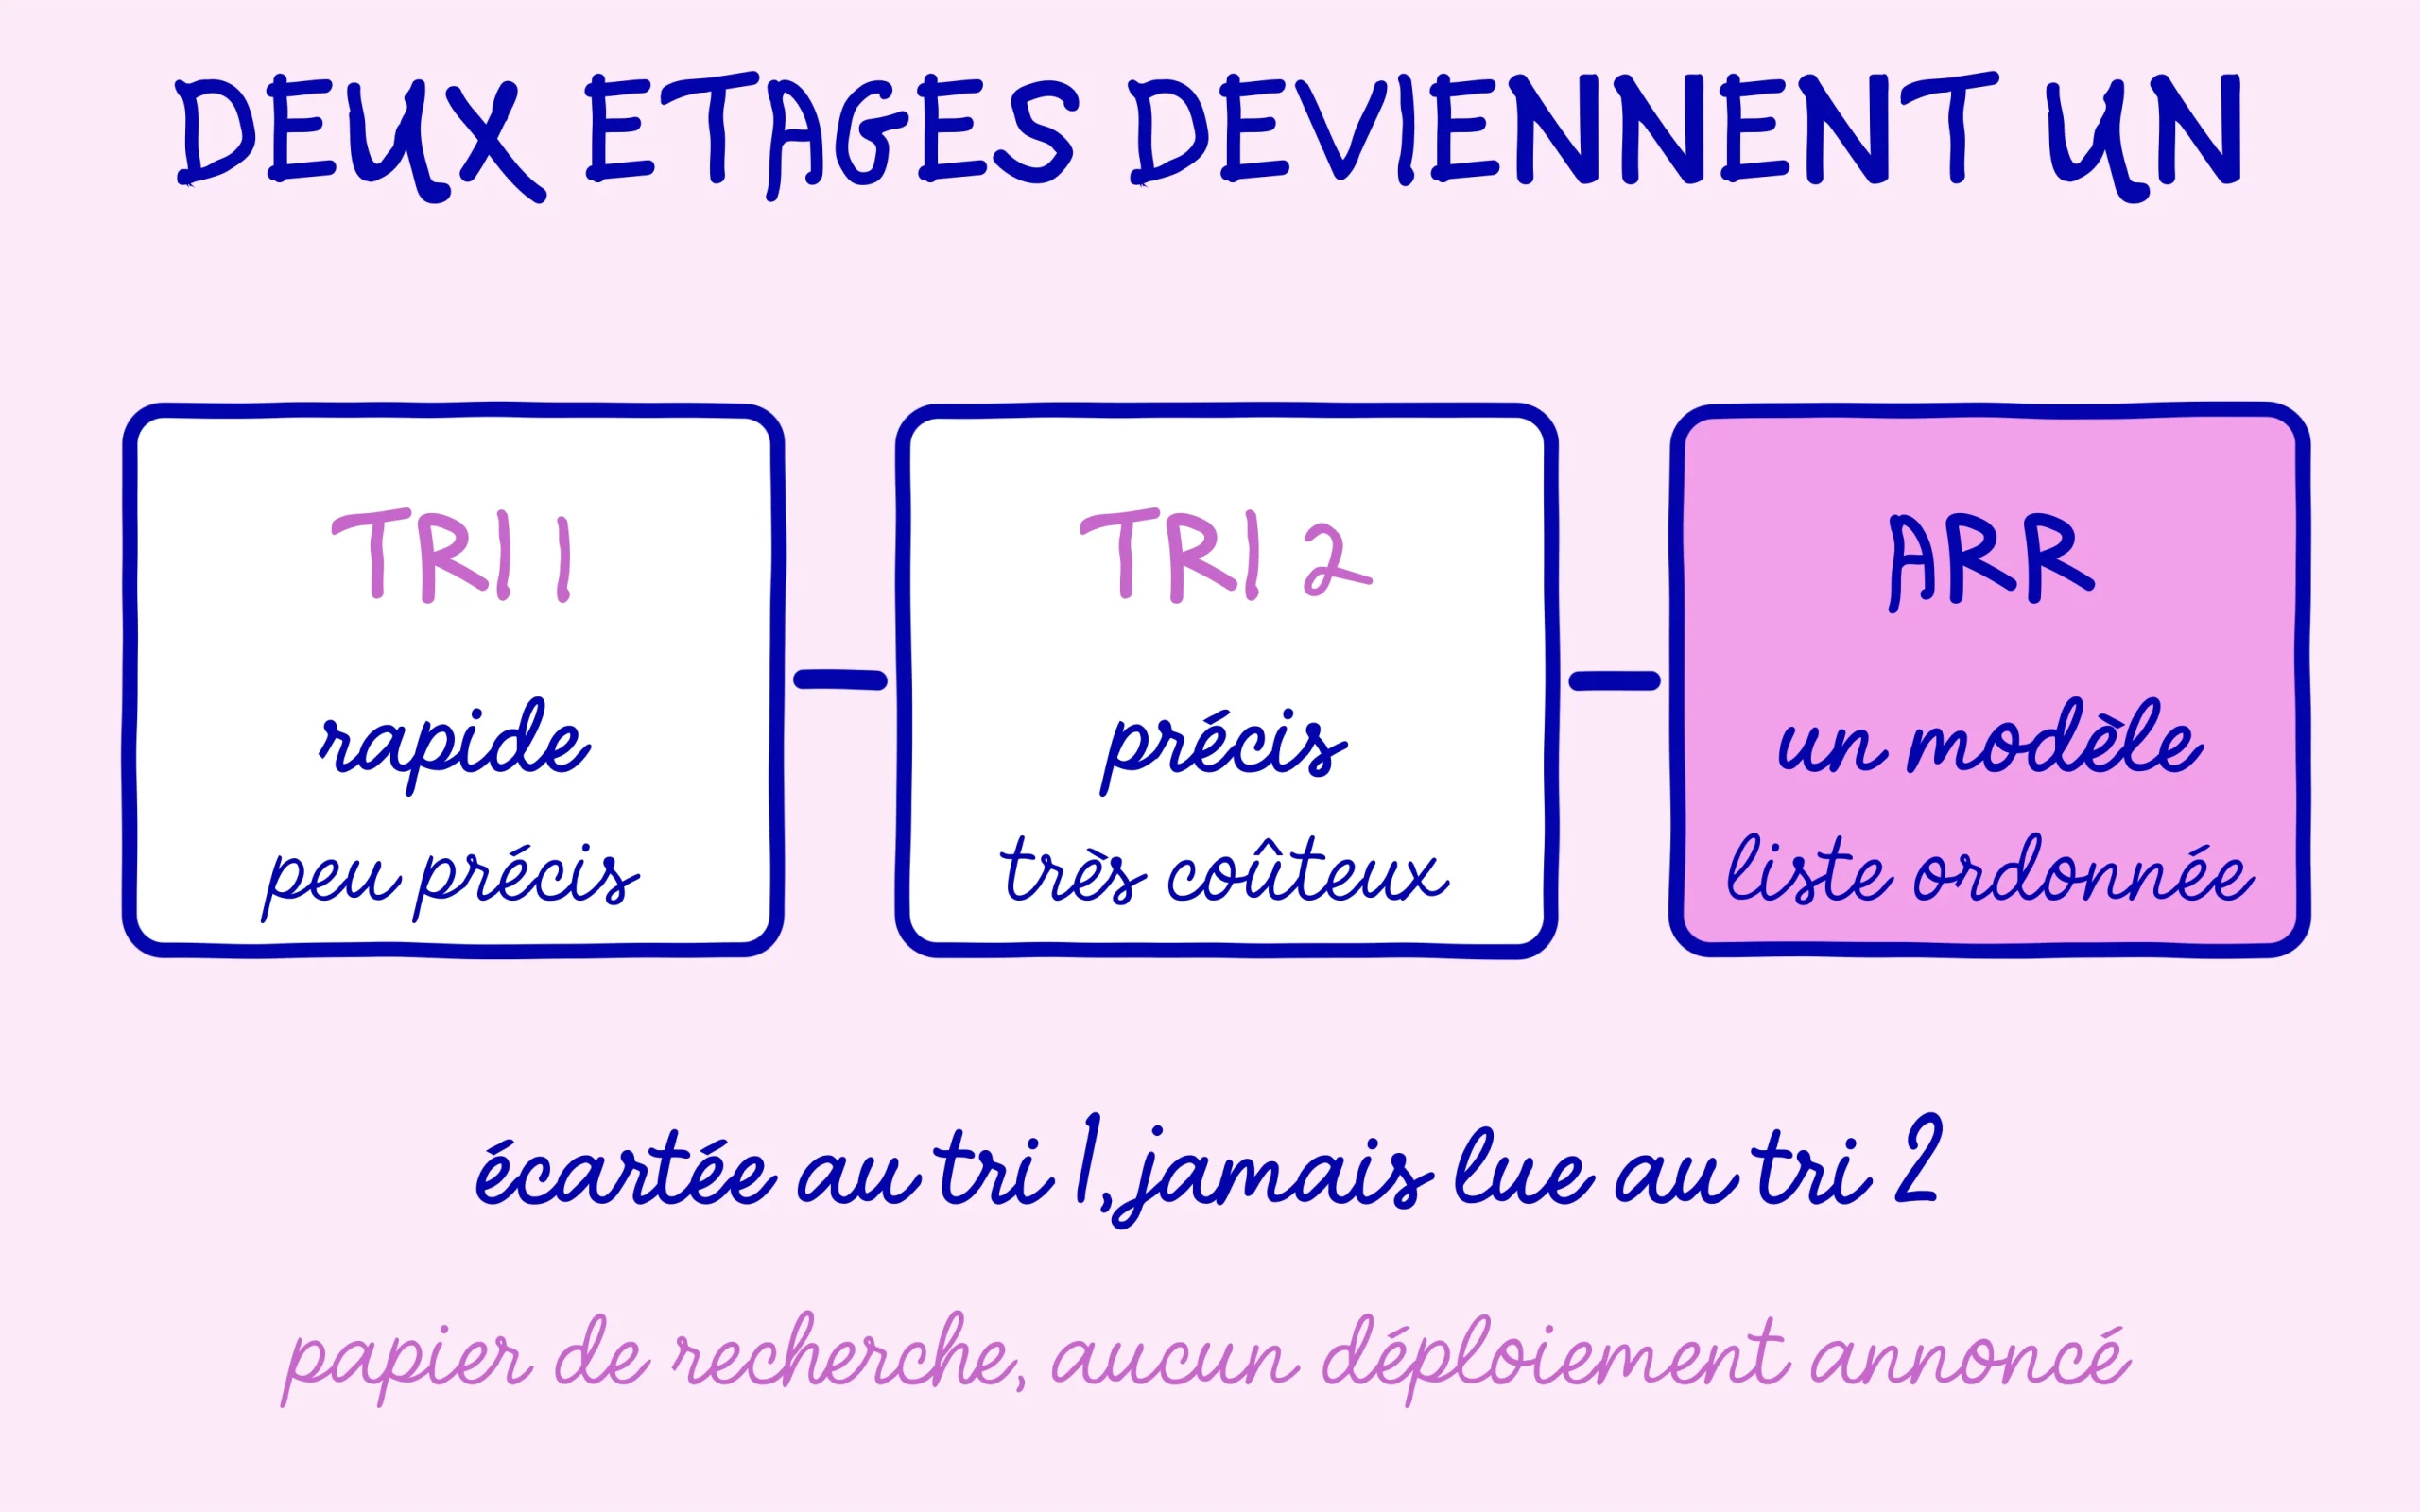
Le fonctionnement actuel tient en deux étages qui se complètent parce qu’aucun ne sait tout faire. Le premier s’appuie sur ce qu’on appelle un encodeur double. Il transforme votre page en une série de nombres, fait la même chose avec la requête, et compare les deux. L’opération est très rapide, ce qui permet de balayer des millions de documents, mais elle perd en finesse puisque la page et la question ne se rencontrent jamais vraiment.
Le second étage corrige ce défaut. L’encodeur croisé prend la requête et une page, les lit ensemble, et évalue leur correspondance avec une précision nettement supérieure. Le prix à payer est le temps de calcul, considérable, ce qui interdit de l’appliquer à tout l’index. On l’utilise donc uniquement sur la courte liste remontée par le premier étage, en général quelques dizaines ou quelques centaines de documents.
Cette architecture porte une conséquence que les éditeurs de sites sous-estiment souvent. Une page écartée au premier étage ne sera jamais relue par le second, quelle que soit sa qualité réelle. Le tri grossier décide de qui a le droit d’être jugé finement. C’est une des raisons pour lesquelles les signaux basiques comme la clarté du sujet traité comptent toujours autant, bien avant les finesses de rédaction.
Un mot de vocabulaire au passage, parce que les termes anglais reviennent partout dans les publications du domaine. Un encodeur double se dit dual encoder, un encodeur croisé cross encoder. Ces deux briques structurent la quasi-totalité des moteurs de recherche modernes ainsi que des systèmes qui alimentent les réponses génératives. Elles se retrouvent aussi bien derrière une page de résultats classique que derrière une réponse de ChatGPT appuyée sur des sources web.
Pour se représenter l’ensemble sans jargon, l’image d’un concours de recrutement fonctionne assez bien. Une première lecture très rapide des candidatures élimine la masse sur des critères simples, puis un jury lit attentivement les dossiers retenus. Le second jury produit une décision de meilleure qualité, seulement il ne peut pas lire dix mille dossiers.
Précisons un point qui prête souvent à confusion chez les débutants. Cette mécanique de classement en deux temps ne se limite pas aux résultats classiques : elle alimente aussi les blocs de réponse rédigés par les modèles. Quand une réponse générée cite trois sources, ces trois sources ont d’abord été sélectionnées puis ordonnées par une chaîne de ce type. La recherche IA ne fabrique pas ses sources à partir de rien, elle pioche dans un classement construit en amont, et le fonctionnement détaillé des AI Overviews et de leurs sources montre bien cette continuité avec le référencement classique.
Ce que propose le modèle Autoregressive Ranking
La proposition des chercheurs consiste à confier les deux tâches à un seul modèle de langage, entraîné à produire directement une liste ordonnée de documents. Le système porte le nom d’Autoregressive Ranking, abrégé en ARR, et la méthode d’entraînement associée s’appelle SToICaL. Cette méthode pondère chaque document selon sa pertinence et concentre la probabilité vers les positions hautes du classement, de façon à ce que le modèle apprenne à soigner tout le haut de la liste.
L’intérêt technique annoncé porte sur la capacité à traiter un nombre quelconque de documents sans faire exploser les ressources. Un encodeur double voit ses besoins croître à mesure qu’on augmente le nombre de documents comparés, ce qui borne sa précision en pratique. ARR revendique de tenir cette charge à dimensions constantes, ce qui expliquerait qu’il atteigne dans les tests une qualité comparable à celle de l’encodeur croisé.
Les résultats publiés méritent d’être lus avec leurs limites, que les auteurs ne cachent pas. Sur les expériences menées à partir de la base lexicale WordNet, ARR fait nettement mieux que l’encodeur double et se situe au niveau de l’encodeur croisé. L’entraînement SToICaL améliore sensiblement la qualité au-delà du seul premier résultat, ce qui compte pour tout ce qui ressemble à une liste. En revanche, sur des tests de recherche de produits, une des variantes dégrade le tout premier résultat malgré des gains ailleurs.
Cette réserve sur le commerce a son importance pour qui vend en ligne. La première position d’une liste de produits concentre une part énorme des clics, et un système qui améliore la liste dans son ensemble tout en dégradant son sommet ne conviendrait pas en l’état à un moteur marchand. Elle illustre surtout un principe utile à retenir : un modèle de classement n’est jamais bon ou mauvais dans l’absolu, il l’est pour un type de requête donné.
Le travail complet est consultable librement, et le lire de près reste le meilleur antidote aux résumés approximatifs qui vont circuler. Il est publié sous le titre Autoregressive Ranking: Bridging the Gap Between Dual and Cross Encoders sur arXiv. La formulation du titre dit bien ce que les auteurs cherchent : combler l’écart entre les deux familles d’encodeurs plutôt que de les opposer.
Ce que ça change concrètement pour un site débutant
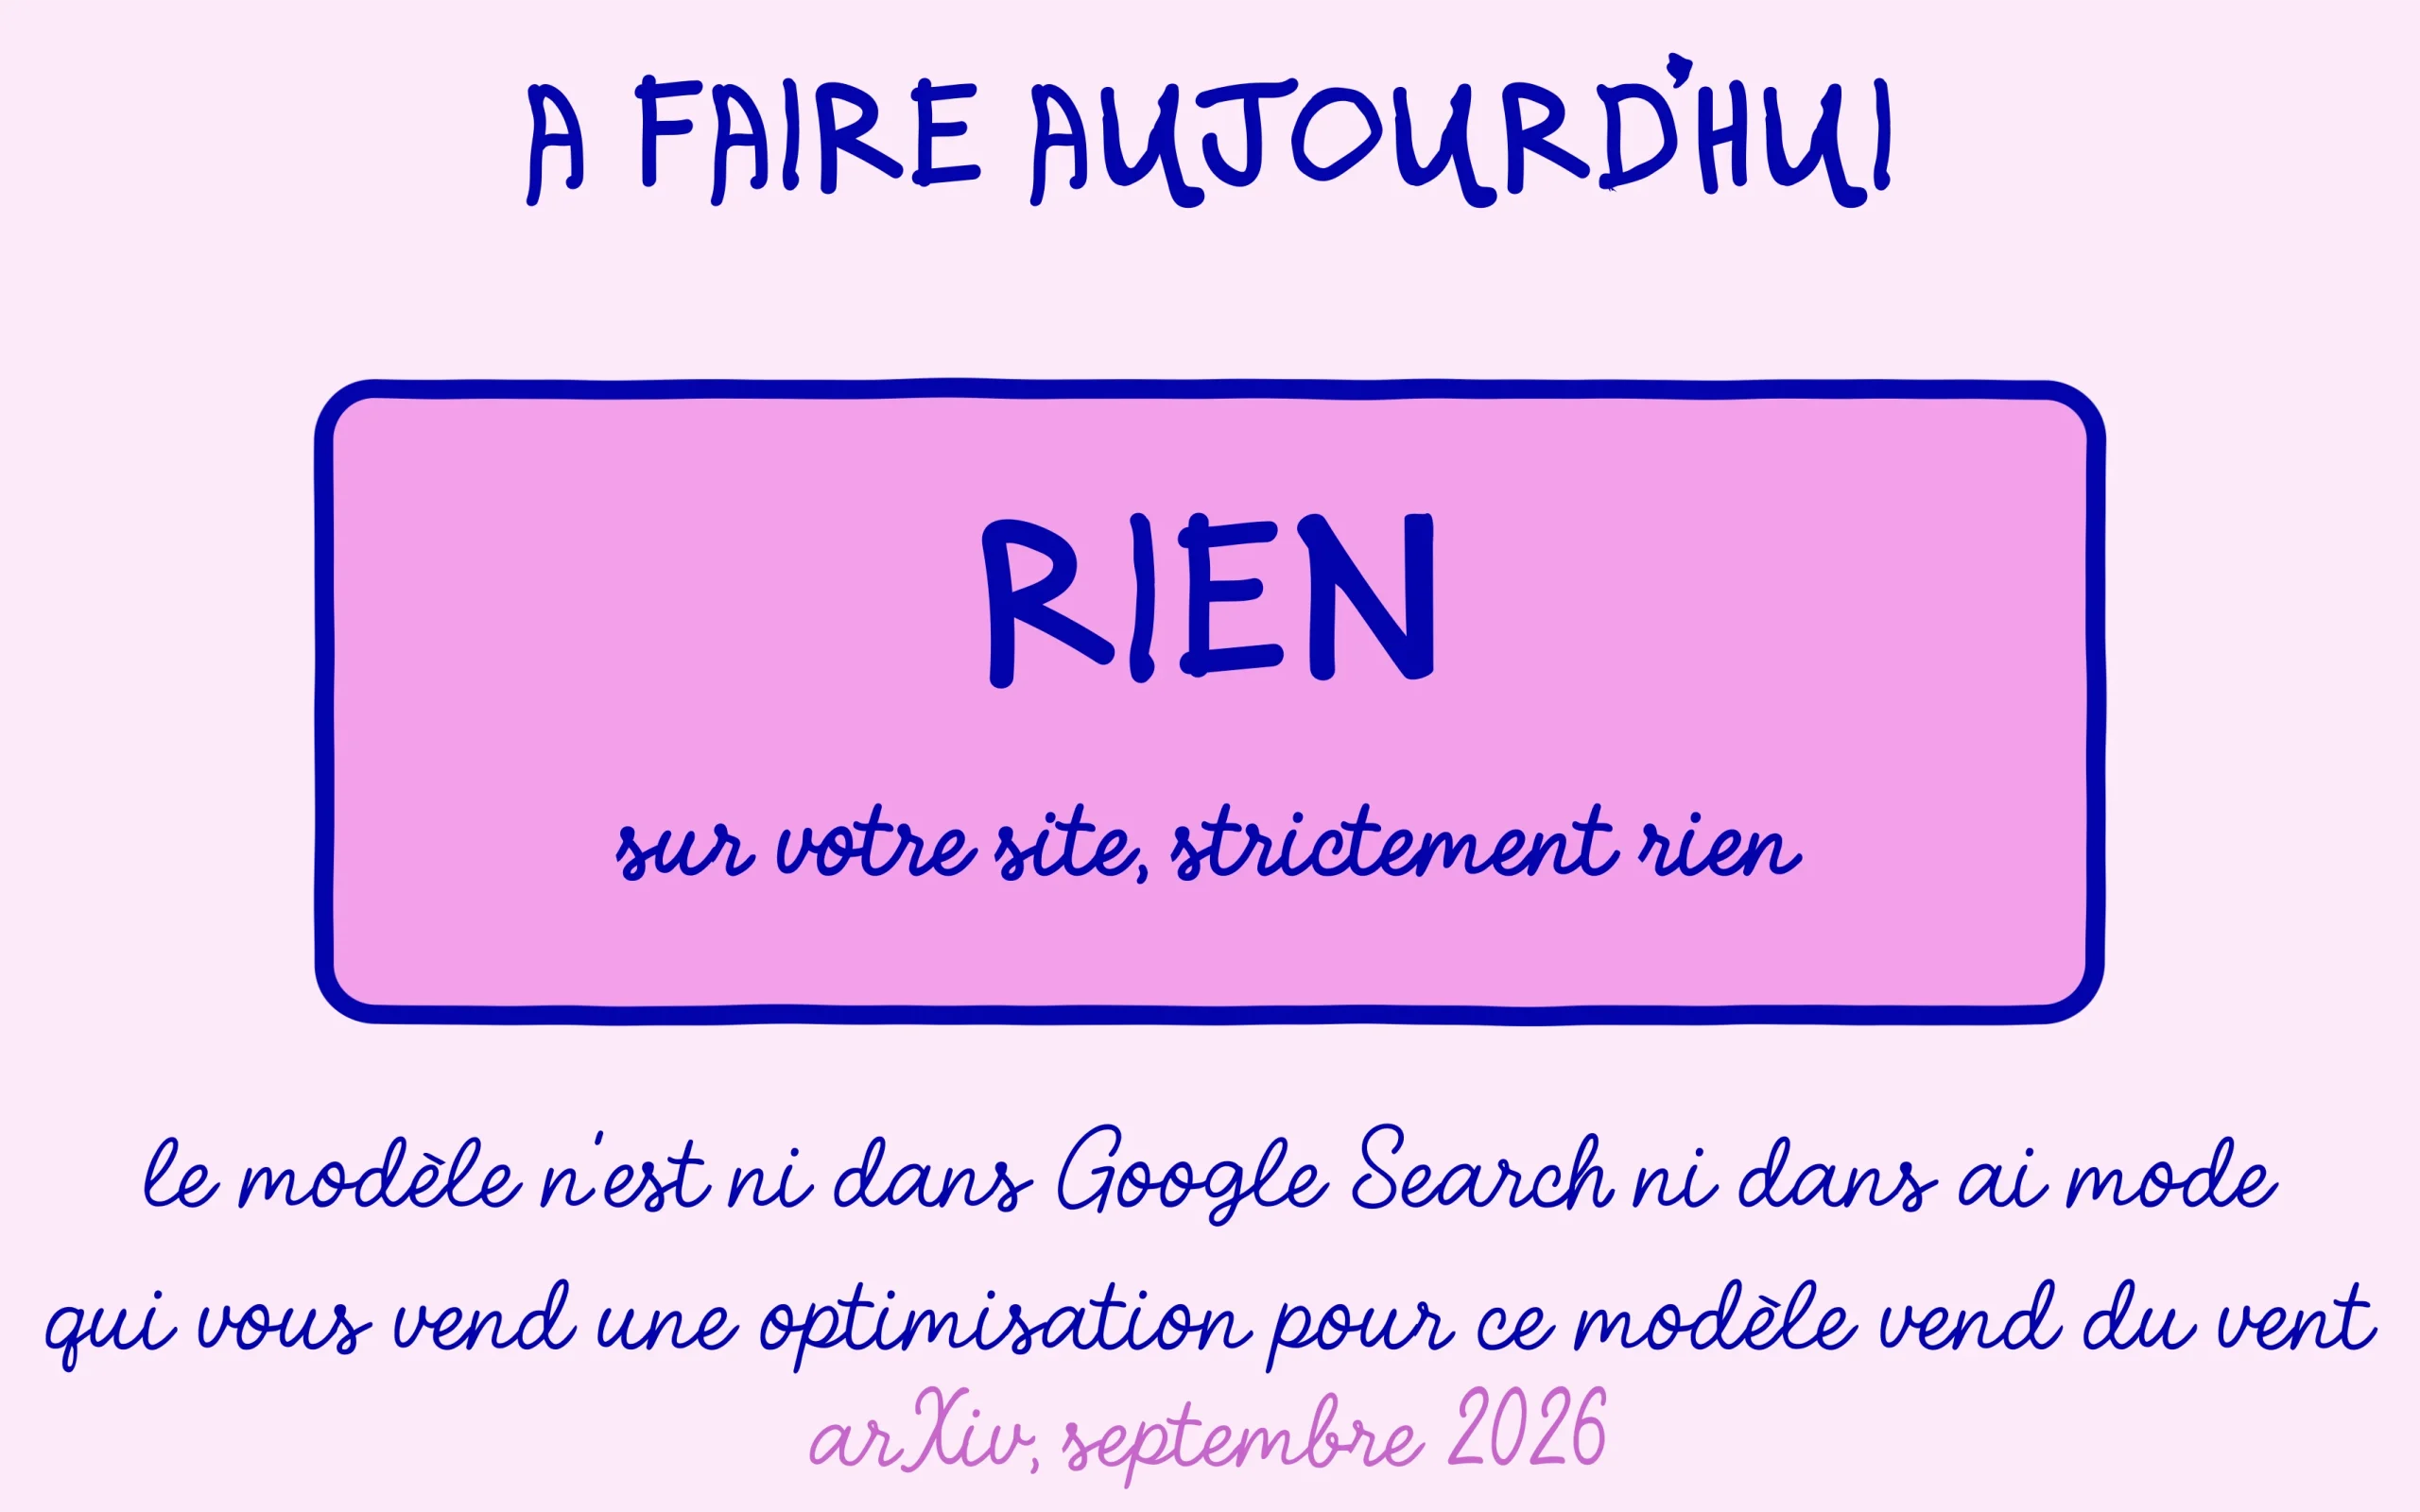
Commençons par le plus important, et il tient en une ligne. Aucune action n’est à mener sur votre site à cause de ce papier. Il s’agit d’une publication de recherche, sans le moindre signe d’un déploiement dans Google Search, dans AI Mode ou dans les AI Overviews. Toute personne qui vous vendrait une prestation d’optimisation pour ARR dans les mois qui viennent vendrait du vent.
Cela dit, la direction que prennent ces travaux mérite l’attention. Les systèmes de classement s’appuient de plus en plus sur des modèles qui lisent réellement le contenu, au lieu de le réduire à une empreinte numérique comparée à une autre. Une page dont le propos est clair, dont la réponse arrive tôt et dont le sujet est traité entièrement s’accommode bien de cette direction. Ce sont exactement les qualités que valorise déjà la manière de structurer une page pour être reprise dans une réponse générée.
La deuxième lecture est plus stratégique et tourne autour du coût de calcul. Si un modèle unique parvient à faire le travail des deux étages sans exploser les ressources, alors le tri fin devient applicable à beaucoup plus de documents qu’aujourd’hui. Un site modeste, actuellement éliminé au premier tour sur des critères grossiers, aurait davantage de chances d’être réellement lu. C’est une hypothèse, pas une promesse, et elle dépend entièrement de ce que les moteurs de recherche IA décideront d’industrialiser.
Cette hypothèse mérite d’être tempérée par une observation de terrain. Élargir le tri fin ne profite pas mécaniquement aux petits sites : un jury qui lit davantage de dossiers lit aussi ceux des concurrents bien financés, avec leurs contenus étoffés et leurs équipes dédiées. Un tri plus fin récompense la qualité réelle du traitement plutôt que le volume de signaux accumulés, ce qui rebat les cartes sans garantir à personne de gagner la main.
Un rappel de bon sens s’impose sur le rythme auquel la recherche devient du produit. Beaucoup de papiers de ce type ne sortent jamais du laboratoire, et ceux qui en sortent mettent souvent plusieurs années, sous une forme assez éloignée de la publication d’origine. BlockRank, un autre travail de DeepMind sur le classement dans les modèles de langage, n’est toujours pas utilisé dans les produits Google à ce jour.
La conclusion pratique est donc d’une banalité assumée, et c’est très bien ainsi. Continuez à traiter vos sujets à fond, à répondre tôt dans la page, à surveiller vos requêtes dans la Search Console. Ces fondamentaux résistent aux changements d’architecture parce qu’ils décrivent ce que tout système de recherche IA cherche à mesurer, quelle que soit sa plomberie interne. Pour situer ce que les professionnels estiment aujourd’hui déterminant, l’enquête 2026 sur les facteurs de classement donne un point de comparaison utile.
Continuez de progresser sur SEO Noobies.