Il y a une confusion tenace chez les débutants, et une affaire récente vient de la remettre en pleine lumière : croire qu’interdire une page dans le fichier robots.txt suffit à la faire disparaître de Google, alors que seule une balise noindex fait vraiment ce travail. L’histoire est partie de conversations partagées depuis un outil d’IA qui se sont retrouvées visibles dans les résultats de recherche, à la surprise de leurs auteurs. En creusant, on tombe sur un mécanisme que beaucoup de créateurs de sites ignorent encore. La plupart des articles traitent le sujet sous l’angle du fait divers, mais il y a une leçon très concrète à en tirer quand on gère son propre site. Voilà ce qui se passe réellement et comment éviter le piège.
En bref
Bloquer une page dans le robots.txt empêche Google de l’explorer, mais ne la retire pas forcément des résultats de recherche.
Si d’autres sites pointent vers cette page, elle peut rester indexée, car Google ne voit jamais la consigne cachée à l’intérieur.
Pour retirer une page de Google, il faut une balise noindex lisible par le robot, donc une page qui reste accessible au crawl.
Le bon réflexe débutant : réserver le robots.txt à ce qu’on ne veut pas faire explorer, et le noindex à ce qu’on ne veut pas voir indexé.
Résumer cet article avec une IA
ChatGPTPourquoi une page bloquée dans robots.txt reste visible sur Google
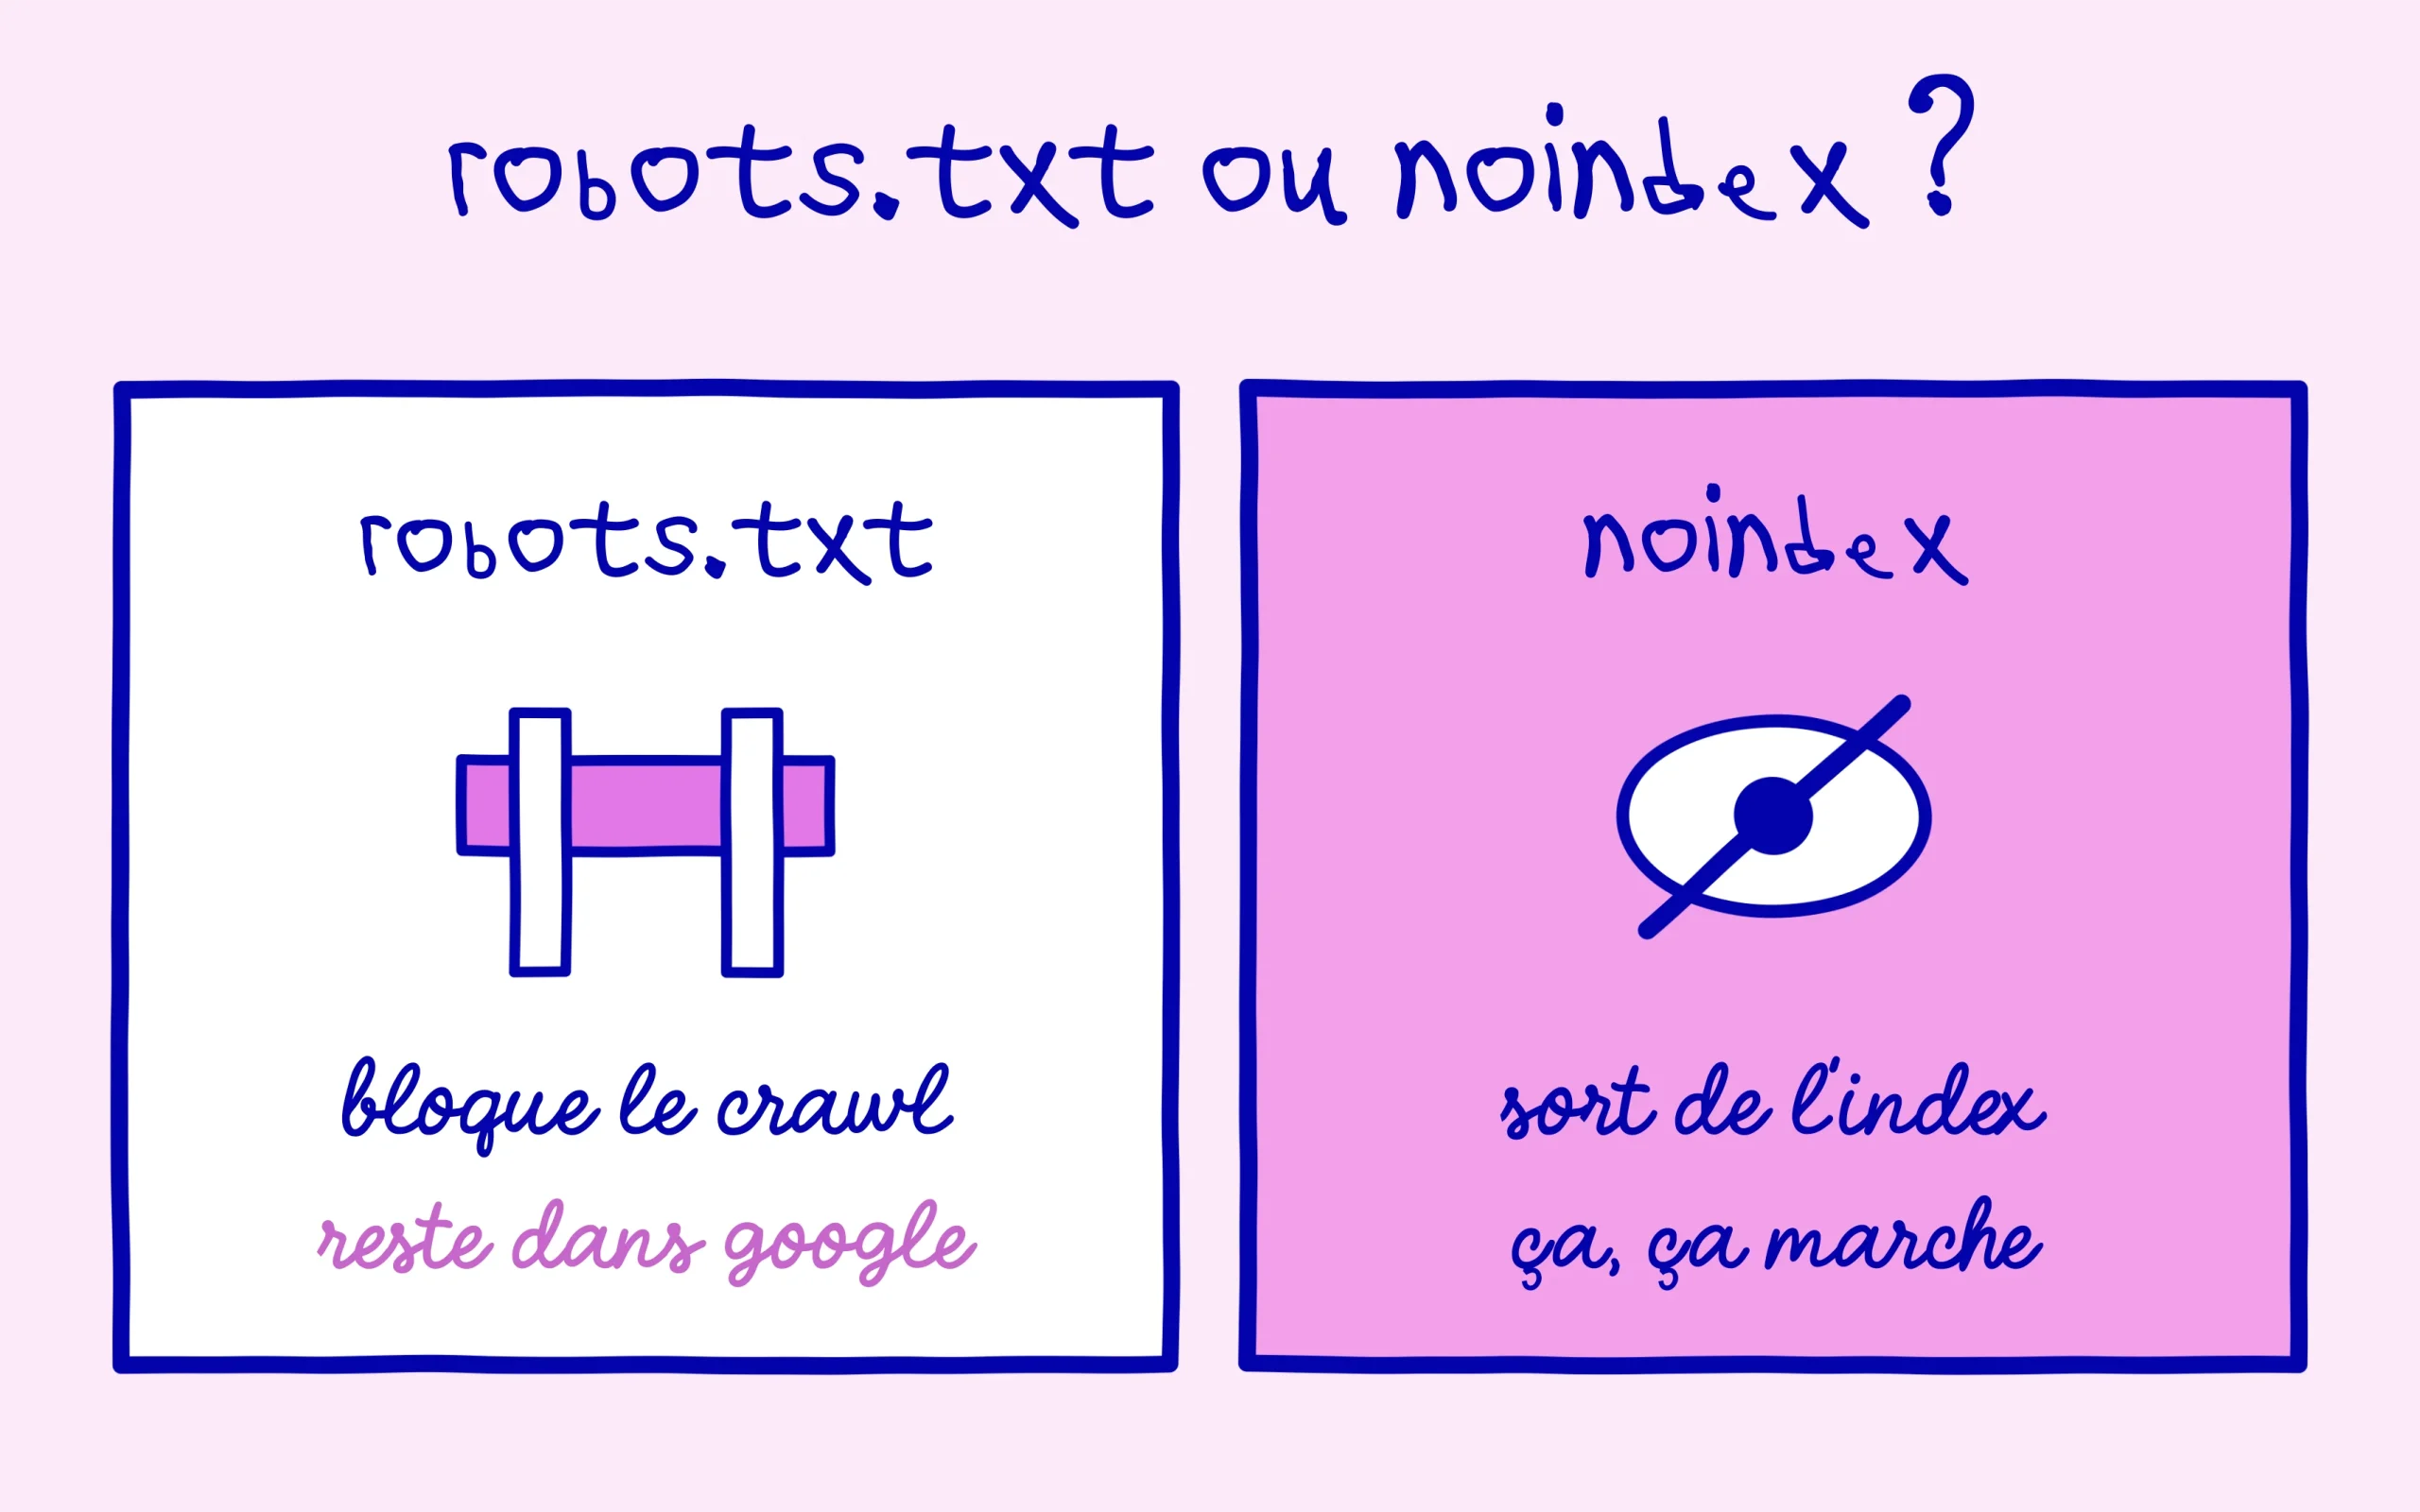
Commençons par le point qui coince. Le fichier robots.txt sert à dire aux robots des moteurs quelles parties d’un site ils peuvent explorer. Quand vous y écrivez une règle de blocage sur une page, vous demandez à Google de ne pas venir la lire. Sauf que ne pas lire une page n’est pas la même chose que ne pas l’afficher. Google peut très bien connaître l’existence de cette adresse par d’autres chemins, notamment quand un autre site fait un lien vers elle, et décider de la montrer dans ses résultats même sans l’avoir explorée. La documentation officielle de Google sur le blocage de l’indexation le dit noir sur blanc : une page bloquée au crawl peut continuer d’apparaître si d’autres pages pointent vers elle.
Là où ça devient contre-intuitif, c’est que le blocage se retourne contre vous. En interdisant l’accès à la page, vous empêchez aussi Google de voir la consigne noindex que vous auriez pu placer dedans. Le robot ne franchit pas la porte, donc il ne lit jamais le panneau qui dit de ne pas indexer accroché derrière. La page reste candidate à l’affichage, et vous avez perdu le seul moyen de la faire sortir proprement. On a déjà vu ce genre de malentendu quand Google a ignoré une directive robots.txt ajoutée automatiquement à des pages, preuve que ce fichier ne décide pas de tout.
Un détail qui compte quand on débute : le robots.txt gère l’exploration, pas l’indexation. Ce sont deux leviers différents, avec deux effets différents, et les confondre mène exactement au problème qu’on cherchait à éviter. Bloquer au crawl n’efface jamais une page des résultats de Google. Gardez cette phrase en tête, elle vous évitera pas mal de mauvaises surprises sur vos propres pages.
Ce que l’affaire des conversations d’IA indexées révèle
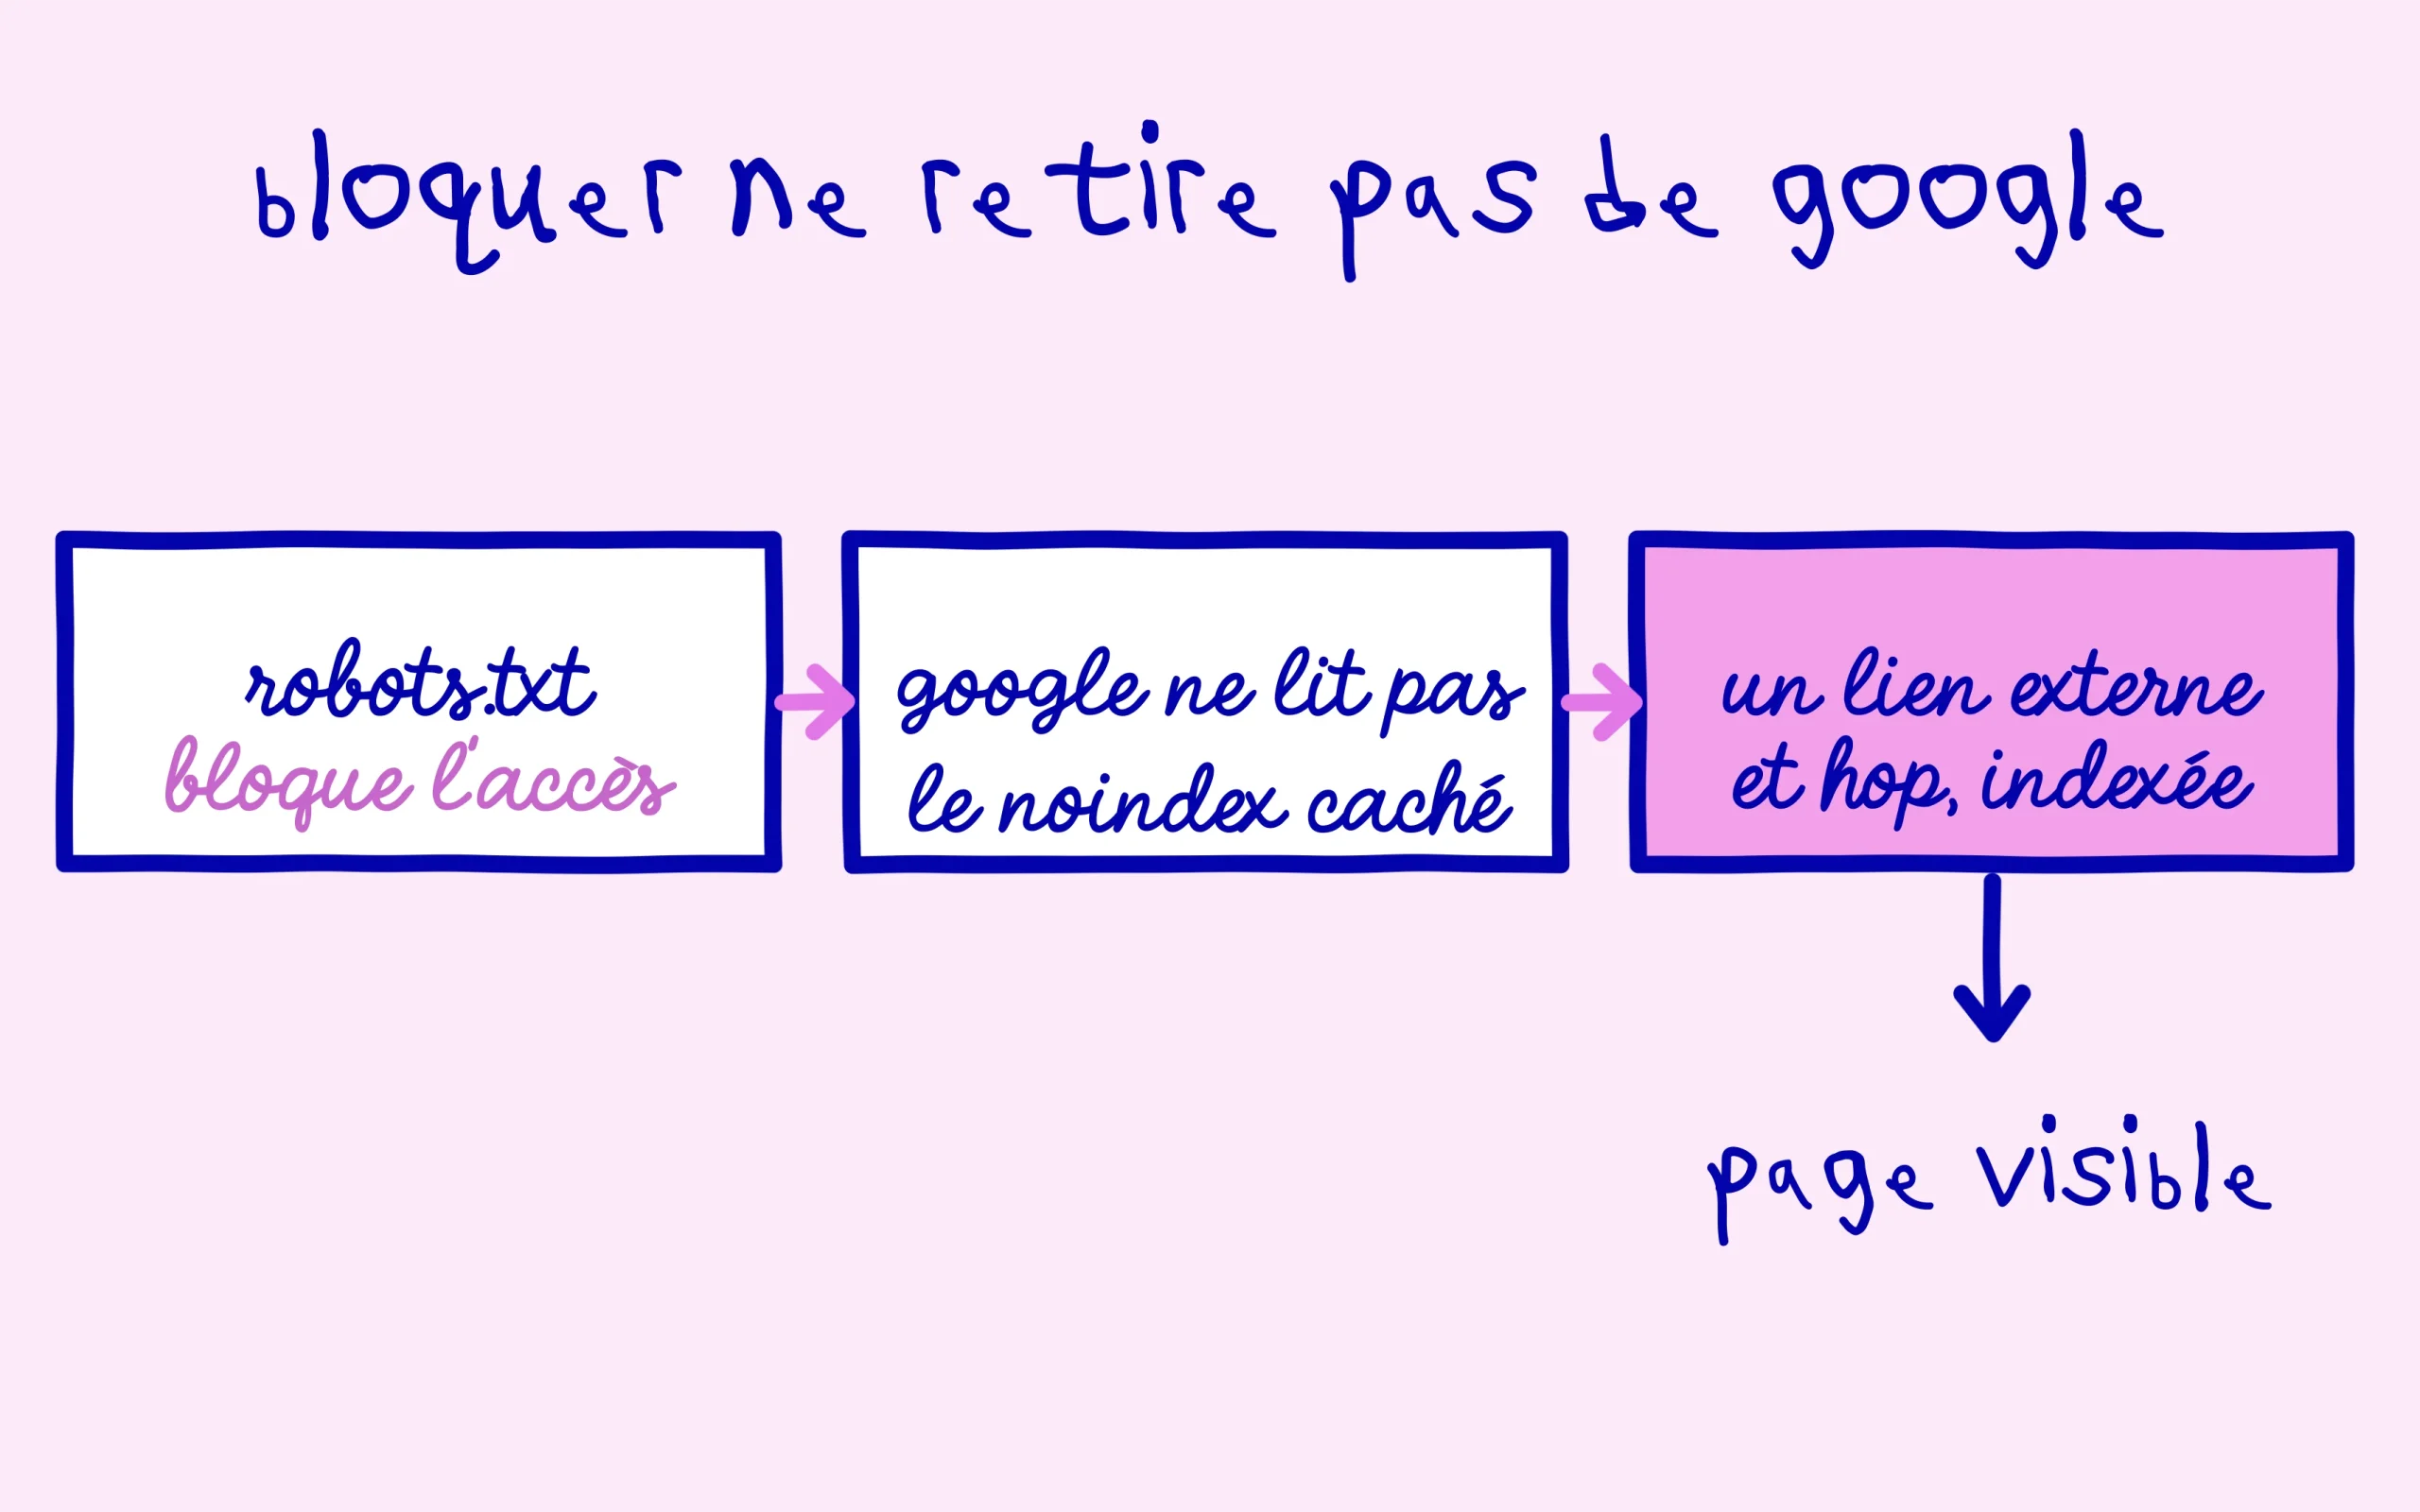
L’affaire qui a relancé le sujet est parlante. Des conversations partagées depuis un outil d’IA se sont retrouvées accessibles dans Google, alors que l’entreprise pensait les avoir mises à l’abri. En regardant la configuration, un consultant a mis le doigt sur la contradiction : les pages concernées étaient à la fois bloquées dans le robots.txt et censées porter une consigne de non-indexation. Comme le blocage empêchait Google de lire cette consigne, les pages sont restées indexables. L’analyse technique détaillée de ce couac de configuration montre bien l’enchaînement, étape par étape.
Ce qui est intéressant, c’est le contraste avec une autre partie du même site, correctement réglée. Là, les pages n’étaient pas bloquées dans le robots.txt, mais portaient une vraie balise noindex visible par le robot. Google pouvait donc les explorer, lire la consigne, et les tenir hors de son index. Deux réglages, deux résultats opposés, sur le même nom de domaine. Voilà la démonstration grandeur nature de la règle, sur un cas réel plutôt que sur un exemple de manuel.
La leçon dépasse largement le cas d’un outil d’IA. Beaucoup de débutants pensent protéger une page sensible en la glissant dans le robots.txt, puis s’étonnent de la voir remonter dans une recherche. C’est un peu le même terrain que celui des alertes qu’on croit graves alors qu’elles ne le sont pas, où Google relativise beaucoup de signaux de la Search Console. Une page qu’on veut vraiment cacher se traite avec un noindex, pas avec un blocage.
Le réflexe noindex à adopter quand on débute
Concrètement, voici comment s’y prendre. Si vous voulez qu’une page n’apparaisse pas dans Google, laissez le robot y accéder et ajoutez-lui une balise meta robots en noindex, ou l’en-tête équivalent côté serveur si vous savez y toucher. La page reste explorable, Google lit la consigne, et il la retire de son index au prochain passage. C’est la méthode que Google recommande officiellement, et la seule qui fonctionne vraiment de bout en bout.
Réservez alors le robots.txt à son vrai rôle : éviter de faire explorer des zones inutiles, comme des pages techniques, des filtres de boutique ou des espaces de test, sans chercher à les désindexer par ce biais. Si une de ces pages traîne déjà dans Google, ne la bloquez surtout pas dans le robots.txt en espérant la faire disparaître. Faites l’inverse : laissez l’accès ouvert et posez un noindex, le temps que Google la retire de lui-même. Pour tout ce qui touche à l’indexation d’un jeune site, mieux vaut suivre les conseils d’indexation que Google donne aux petits sites plutôt que bricoler au jugé.
Un dernier point avant de vous lancer. Vérifiez toujours qu’une même page ne cumule pas un blocage robots.txt et un noindex, parce que les deux consignes s’annulent au plus mauvais moment. Un contrôle rapide de l’URL dans la Search Console vous dira si Google voit bien votre page comme vous le souhaitez. Le bon duo, c’est robots.txt pour l’exploration et noindex pour l’indexation, chacun à sa place, et vous reprenez la main sur ce qui apparaît ou non à votre nom.
Continuez de progresser sur SEO Noobies.
[…] de la lire. La documentation insiste sur ce prérequis, et nous avions détaillé ailleurs pourquoi un blocage au robots.txt ne remplace jamais un noindex. Utilisez l’outil d’inspection d’URL et son test en direct pour confirmer que la […]