Une page non indexée qui traîne dans la Search Console avec la mention « Détectée, actuellement non indexée », c’est l’une des premières frustrations que rencontre un site qui démarre. Google connaît l’adresse, il l’affiche noir sur blanc dans son rapport, et pourtant la page reste absente des résultats de recherche. Beaucoup de gens en concluent qu’ils ont commis une erreur technique quelque part et passent des heures à chercher un réglage cassé. Dans la plupart des cas, il n’y a rien de cassé du tout. Voilà ce que ce statut signifie exactement, comment le distinguer de son cousin qui lui ressemble beaucoup, et la marche à suivre quand la situation dure.
En bref
« Détectée, actuellement non indexée » signifie que Google a repéré l’adresse de votre page mais n’est pas encore venu la lire.
Google explique ce report par la charge qu’une exploration ferait peser sur votre serveur. Aucun réglage n’est à corriger dans l’immédiat.
Le statut voisin, « Explorée, actuellement non indexée », décrit une situation différente : Google est venu lire la page et ne l’a pas retenue.
Le vrai levier sur un jeune site est de rendre la page atteignable et manifestement utile, pas de multiplier les demandes d’indexation.
Résumer cet article avec une IA
ChatGPTCe que veut dire une page non indexée mais bien détectée
Le rapport « Indexation des pages » de la Search Console classe chaque adresse connue de Google dans une catégorie. Quand une page non indexée apparaît sous le libellé « Détectée, actuellement non indexée », la documentation de Google est explicite : la page a été détectée mais n’a pas encore été explorée, et l’exploration a généralement été reportée parce que le site risquait d’être surchargé. La formulation officielle est consultable dans l’aide de la Search Console sur le rapport d’indexation des pages.
Traduit en langage courant, Google vous dit qu’il a l’adresse dans sa liste de choses à faire et qu’il n’a pas encore trouvé le bon moment pour venir. Il l’a apprise quelque part, par votre sitemap, par un lien depuis une autre page de votre site, ou par un lien posé ailleurs sur le web. Mais entre connaître une adresse et aller lire ce qu’il y a derrière, il y a une file d’attente, et cette file d’attente n’est pas infinie. Un moteur qui explore le web entier répartit ses passages selon ce qu’il estime pouvoir se permettre sur chaque site.
Ce qui compte à ce stade, c’est de comprendre que rien n’est bloqué techniquement dans ce statut. Une page interdite par un noindex ou par le fichier robots.txt apparaît dans d’autres catégories du rapport, avec des libellés qui nomment explicitement le blocage. Ici, aucune barrière n’a été posée, la visite a simplement été remise à plus tard. Sur un site récent, voir plusieurs dizaines de pages dans cet état pendant quelques semaines est un scénario ordinaire, pas un signal d’alarme.
Détectée ou explorée, deux statuts qu’on confond tout le temps
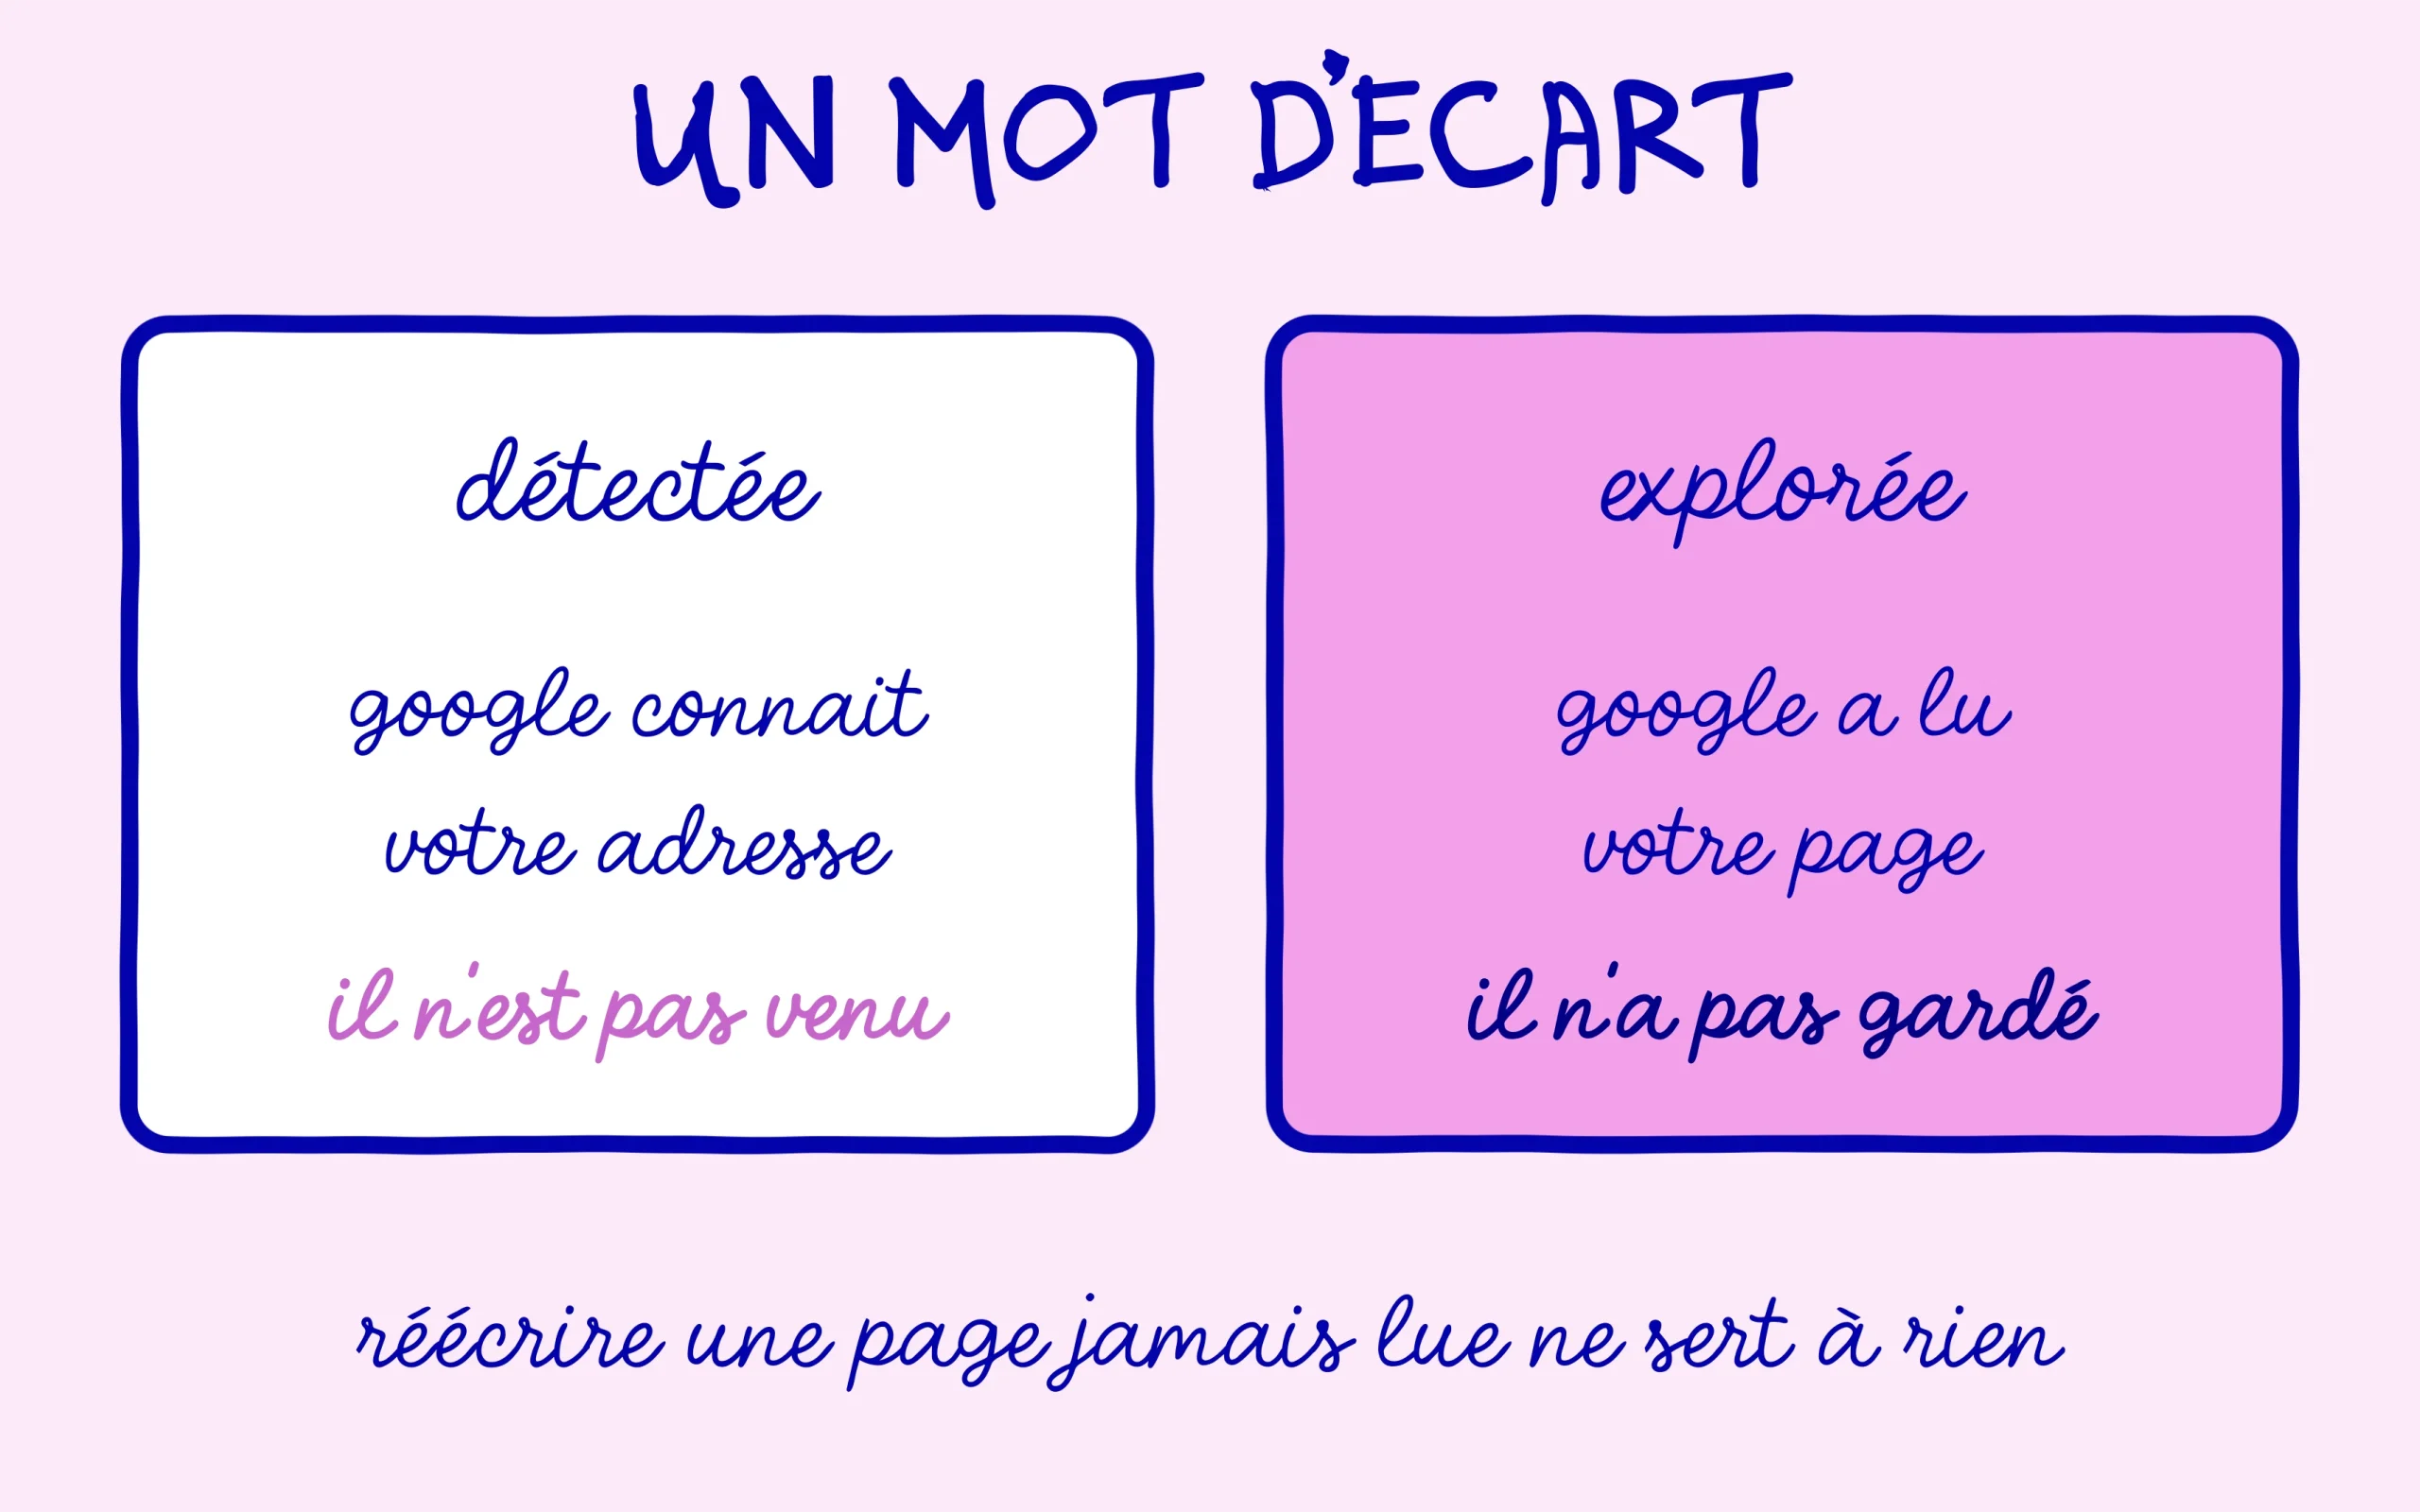
Juste à côté dans le rapport, un autre libellé ressemble beaucoup au premier : « Explorée, actuellement non indexée ». La différence tient en un mot, et elle change complètement le diagnostic. Google précise que dans ce second cas, la page a été explorée mais pas indexée, qu’elle le sera peut-être à l’avenir, et qu’il n’est pas nécessaire de renvoyer l’URL pour exploration.
Détectée, Google n’est pas encore venu. Explorée, il est venu, il a lu, et il a choisi de ne pas ajouter la page à son index. Le second statut porte donc un jugement implicite sur le contenu lui-même, alors que le premier ne dit rien de sa qualité. Confondre les deux mène à des corrections inutiles : réécrire entièrement une page non indexée qui n’a jamais été lue ne sert strictement à rien, puisque Google n’a pas encore eu accès à la version d’origine.
Le réflexe correct consiste donc à ouvrir le rapport et à lire le libellé exact avant toute chose. Notre guide sur la vérification de l’indexation de votre site dans Google détaille la manipulation pas à pas si vous n’avez jamais mis les pieds dans cet écran. Et pour comprendre ce que Google attend réellement d’une page avant de l’accepter dans son index, notre chapitre sur l’indexation et les raisons pour lesquelles Google refuse parfois vos pages pose le cadre général.
Les causes les plus fréquentes sur un site qui démarre
Première cause, la plus banale : le temps. Un site publié il y a trois semaines n’a pas d’historique, donc Google n’a aucune raison de lui consacrer beaucoup de passages. Les visites s’espacent, la file d’attente s’allonge, et les pages les plus récentes attendent leur tour. Ce délai se réduit naturellement à mesure que le site vit et publie régulièrement.
Vient ensuite un facteur largement sous-estimé, celui de la page orpheline ou presque. Une adresse qui n’existe que dans le sitemap, sans aucun lien depuis le reste du site, envoie un signal faible. Google la connaît, mais rien dans la structure de votre site ne lui indique qu’elle compte. À l’inverse, une page atteignable en deux clics depuis l’accueil, citée depuis un article connexe, remonte mécaniquement dans l’ordre des priorités. C’est le levier le plus accessible quand on débute, et le moins coûteux.
Plus technique, la lenteur du serveur entretient elle aussi la file d’attente. Puisque Google justifie le report par le risque de surcharge, un hébergement qui met plusieurs secondes à répondre entretient directement le problème. Le moteur ralentit ses passages pour ne pas dégrader votre site, et vos pages attendent d’autant plus longtemps. Un temps de réponse serveur correct profite donc à l’exploration autant qu’à vos visiteurs.
Le volume de pages sans intérêt est la cause la plus délicate à entendre. Un site qui génère des centaines d’adresses vides, des pages d’archives par étiquette, des variantes de filtres, des pages de pagination sans contenu propre, dilue l’attention du moteur sur des adresses qui n’apportent rien. Chaque page inutile allonge la file d’attente des autres. Faire le ménage dans ces adresses, en les retirant du sitemap ou en les passant en noindex, redonne de l’oxygène aux pages qui comptent vraiment.
Reste une hypothèse à écarter méthodiquement avant de s’inquiéter du reste : la page non indexée est peut-être un doublon aux yeux de Google. Deux adresses qui affichent un contenu très proche, une version avec et sans barre oblique finale, une fiche déclinée en plusieurs variantes, et le moteur choisit d’en traiter une seule. Le rapport le signale alors dans une catégorie dédiée aux pages en double, mais le cas limite existe quand la ressemblance est partielle. Comparez honnêtement vos pages entre elles : si deux d’entre elles répondent à la même question avec les mêmes arguments, la bonne décision consiste à les fusionner plutôt qu’à réclamer l’indexation des deux.
La marche à suivre quand la situation s’éternise
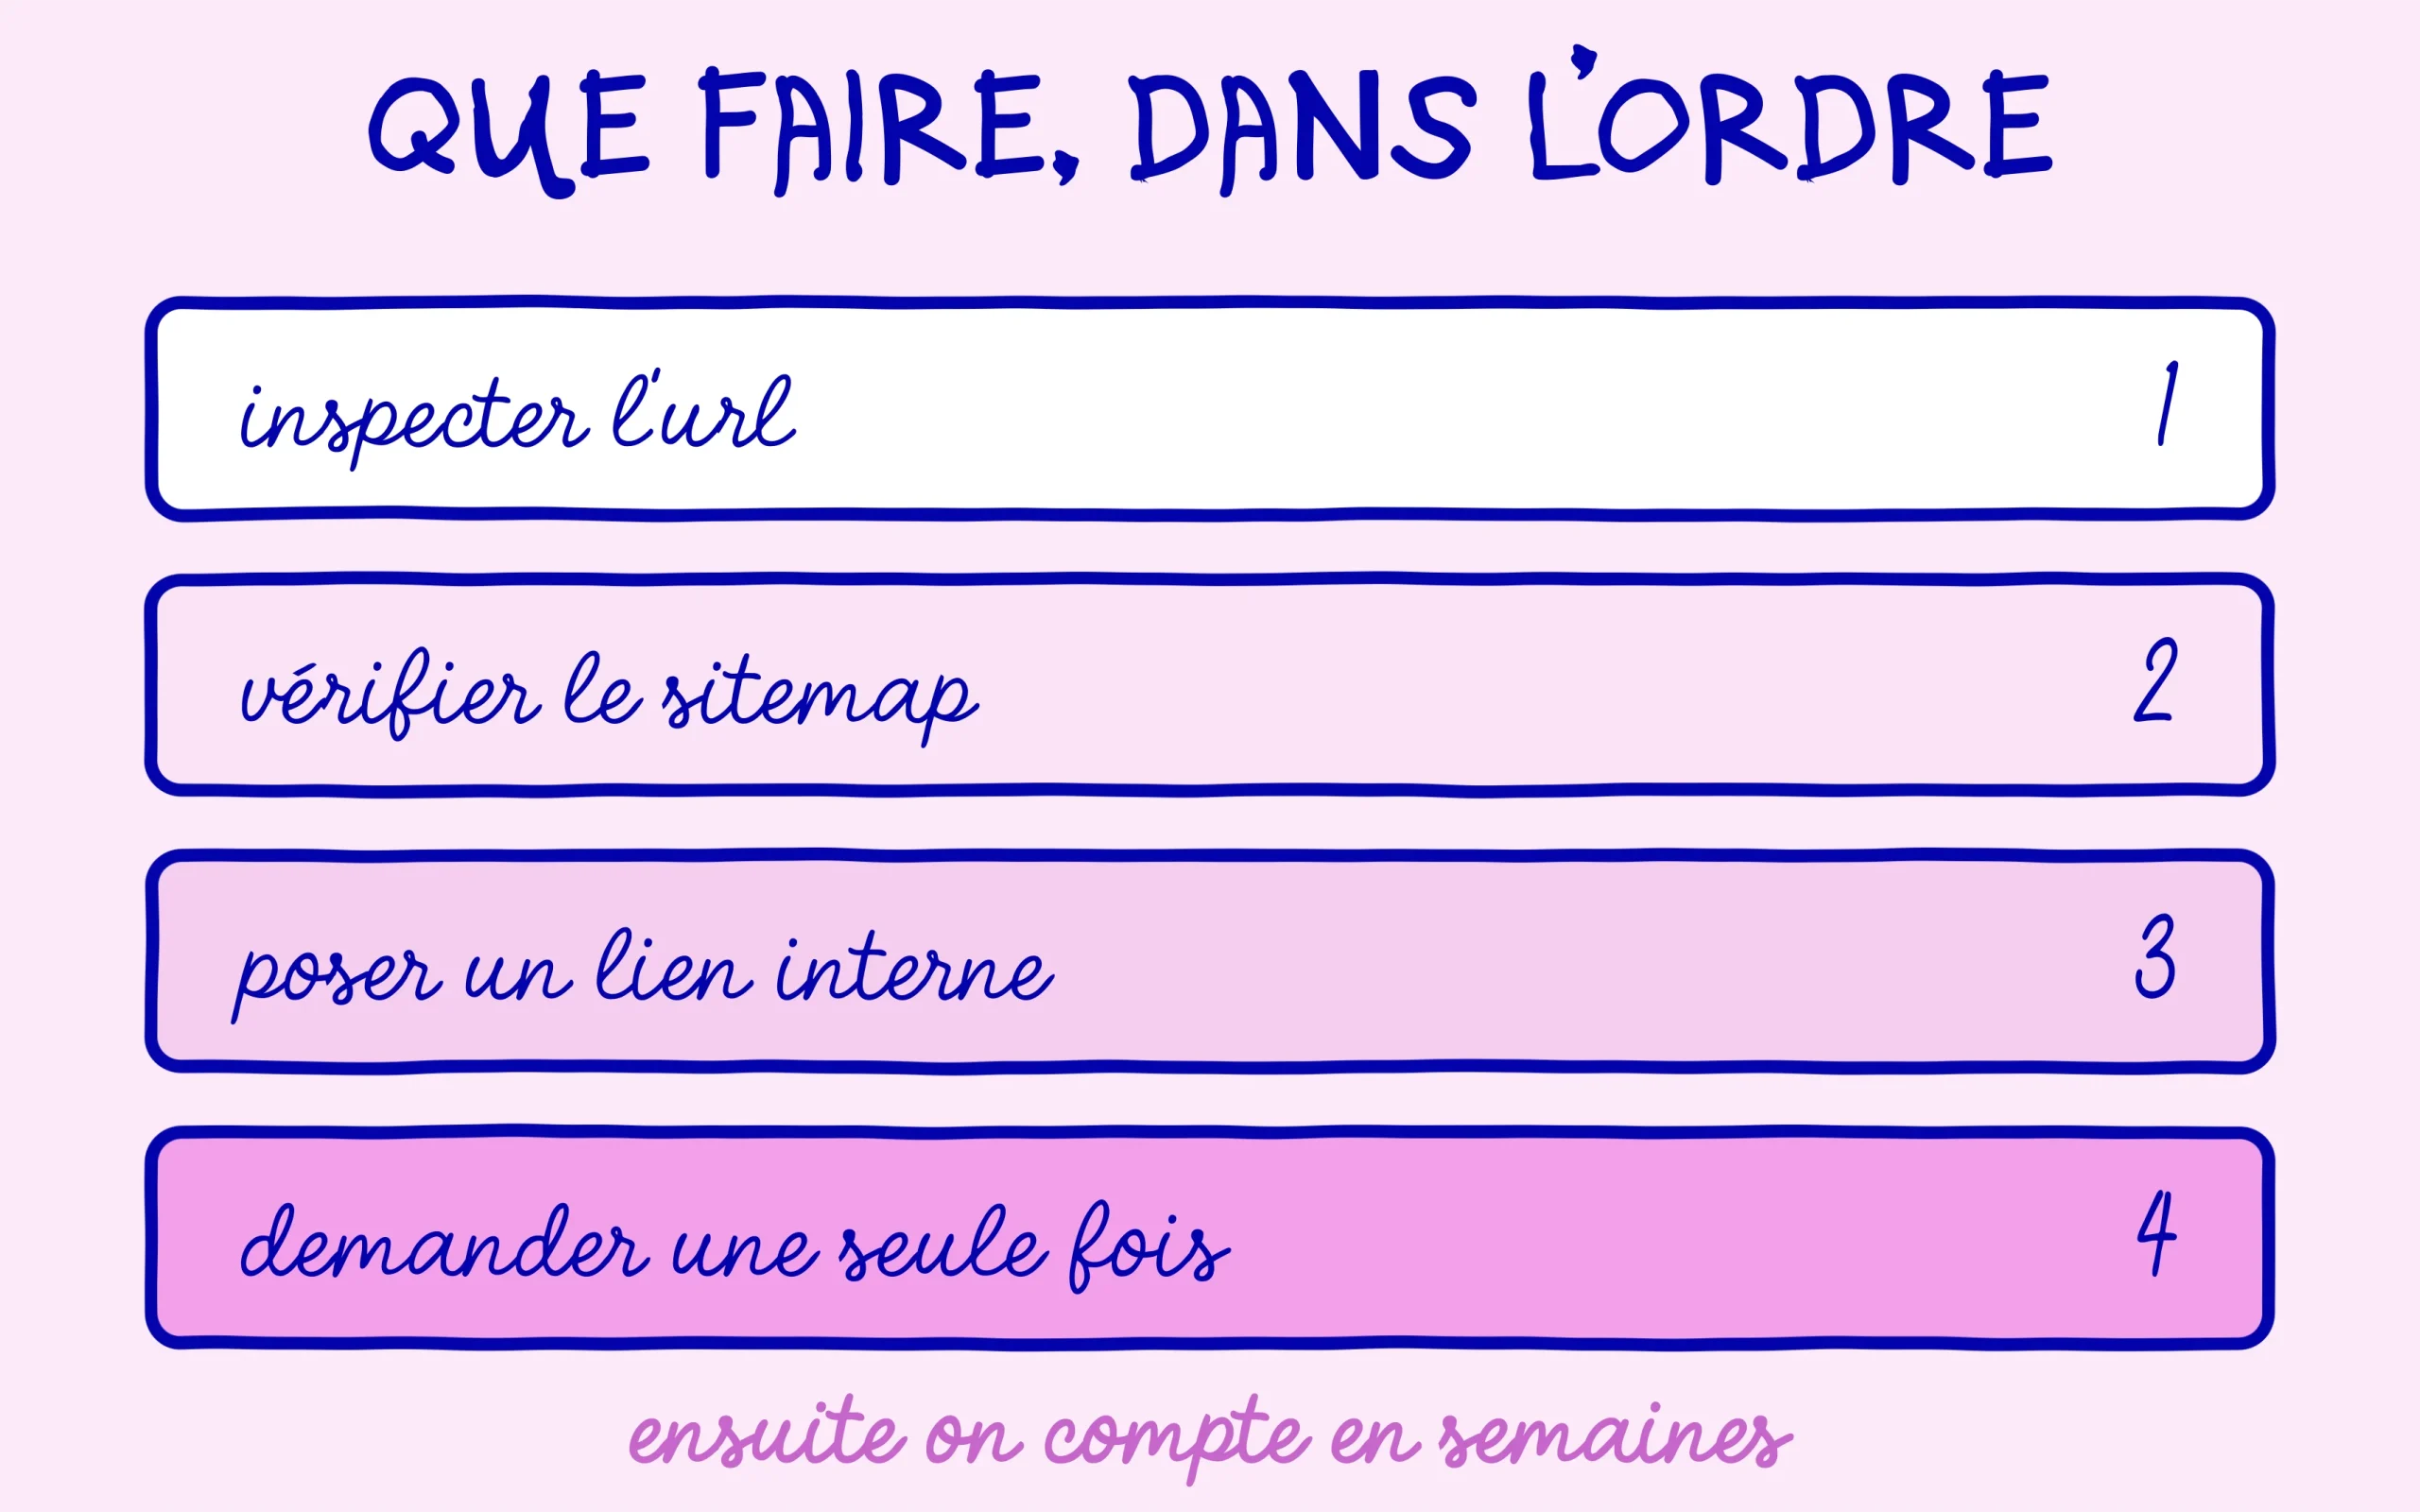
Commencez par l’outil d’inspection d’URL de la Search Console. Collez l’adresse concernée dans le champ en haut de l’écran, puis lisez ce que Google renvoie. Vous saurez précisément s’il connaît la page, quand il l’a vue pour la dernière fois, et si un blocage existe. C’est le seul diagnostic fiable, tout le reste relève de la supposition.
Vérifiez ensuite que la page figure bien dans votre sitemap et que ce sitemap est soumis. Sur WordPress, les extensions de référencement gèrent ce fichier automatiquement, et Rank Math en version gratuite permet de contrôler quels types de contenus y figurent. Si vous partez de zéro sur ce point, notre tutoriel sur la création et la soumission d’un sitemap XML sur WordPress couvre toute la manipulation.
Puis ajoutez au moins un lien interne vers la page concernée depuis un contenu déjà indexé et thématiquement proche. Cette action est la plus efficace du lot et personne ne la fait assez. Une page citée depuis un article que Google visite régulièrement se retrouve dans son chemin de passage, sans qu’il faille lui demander quoi que ce soit. Profitez-en pour vérifier que l’ancre décrit vraiment le contenu de la cible.
Vous pouvez alors demander l’indexation depuis l’outil d’inspection, une fois, et passer à autre chose. Répéter la demande tous les deux jours ne fait pas avancer les choses et vous fera perdre du temps pour rien. Comptez ensuite en semaines, pas en heures. Toutefois, si des pages restent dans cet état plusieurs mois alors que le reste du site s’indexe normalement, il faut regarder du côté des causes de fond listées plus haut, notamment le volume d’adresses inutiles et le temps de réponse du serveur.
Dernier point, et c’est celui qui évite le plus de nuits blanches : ce rapport n’est pas une note attribuée à votre site. Une page non indexée à l’instant T peut basculer dans l’index la semaine suivante sans que vous ayez touché à quoi que ce soit. Prenez l’habitude de relever l’état de vos pages à date fixe, une fois par mois par exemple, plutôt que de rafraîchir l’écran tous les matins. La Search Console récompense la lecture de tendance beaucoup plus que la surveillance quotidienne, et notre présentation de la Search Console et de ce qu’elle mesure réellement explique comment lire ces courbes sans se faire peur.
Continuez de progresser sur SEO Noobies.
Article contenant des liens affiliés : si vous souscrivez à un outil depuis un de ces liens, SEO Noobies perçoit une commission sans surcoût pour vous.
[…] pour un sujet ponctuel, encombre sans rien rapporter. C’est le même raisonnement que pour les pages détectées mais non indexées par Google, à ceci près qu’ici, c’est vous qui […]
[…] là que le panneau doit être posé. Sans lui, cette adresse rejoindra la longue liste des pages détectées mais jamais indexées avant de sortir […]
[…] Trois motifs reviennent constamment. « Exclue par la balise noindex » signale qu’une consigne sur la page elle-même demande à Google de l’ignorer, ce qui renvoie à la case WordPress ou à un réglage d’extension SEO. « Bloquée par le fichier robots.txt » pointe le deuxième cas décrit plus haut. « Détectée, actuellement non indexée » veut dire que Google connaît l’URL, qu’il n’est pas encore passé dessus, et qu’il ne s’en fait pas une priorité, un cas que nous avons détaillé dans l’article sur ce que Google entend par page détectée mais non indexée. […]