Si vous avez activé une option de blocage des robots IA dans Cloudflare ces derniers mois, il y a une vérification à faire assez vite sur votre site. Un cas remonté début août montre que certains réglages destinés à empêcher l’entraînement des modèles renvoient aussi une erreur 403 à Googlebot et à Bingbot, autrement dit aux robots qui servent à vous référencer. Le problème n’a rien d’un bug isolé, il vient d’une logique de classement des robots qui va changer officiellement le 15 septembre 2026. Beaucoup de sites ont coché ces cases par réflexe défensif sans mesurer ce qu’elles couvraient réellement. Voilà ce qui se passe techniquement, ce qui bascule à la rentrée, et les réglages à ouvrir dès maintenant pour ne pas disparaître de Google sans s’en rendre compte.
En bref
Des sites protégés par Cloudflare ont vu Googlebot et Bingbot recevoir une erreur 403 après activation d’une option de blocage de l’entraînement IA.
La cause vient du classement des robots : Googlebot et Bingbot sont considérés comme des robots à double usage, recherche et entraînement à la fois.
Le 15 septembre 2026, de nouveaux réglages par défaut s’appliquent et les robots multi-usages seront bloqués chez tous ceux qui ont demandé à bloquer l’entraînement.
Il est possible de désactiver ce comportement dès maintenant dans les réglages de sécurité, sans attendre la date butoir.
Résumer cet article avec une IA
ChatGPTPourquoi Cloudflare renvoie une erreur 403 à Googlebot
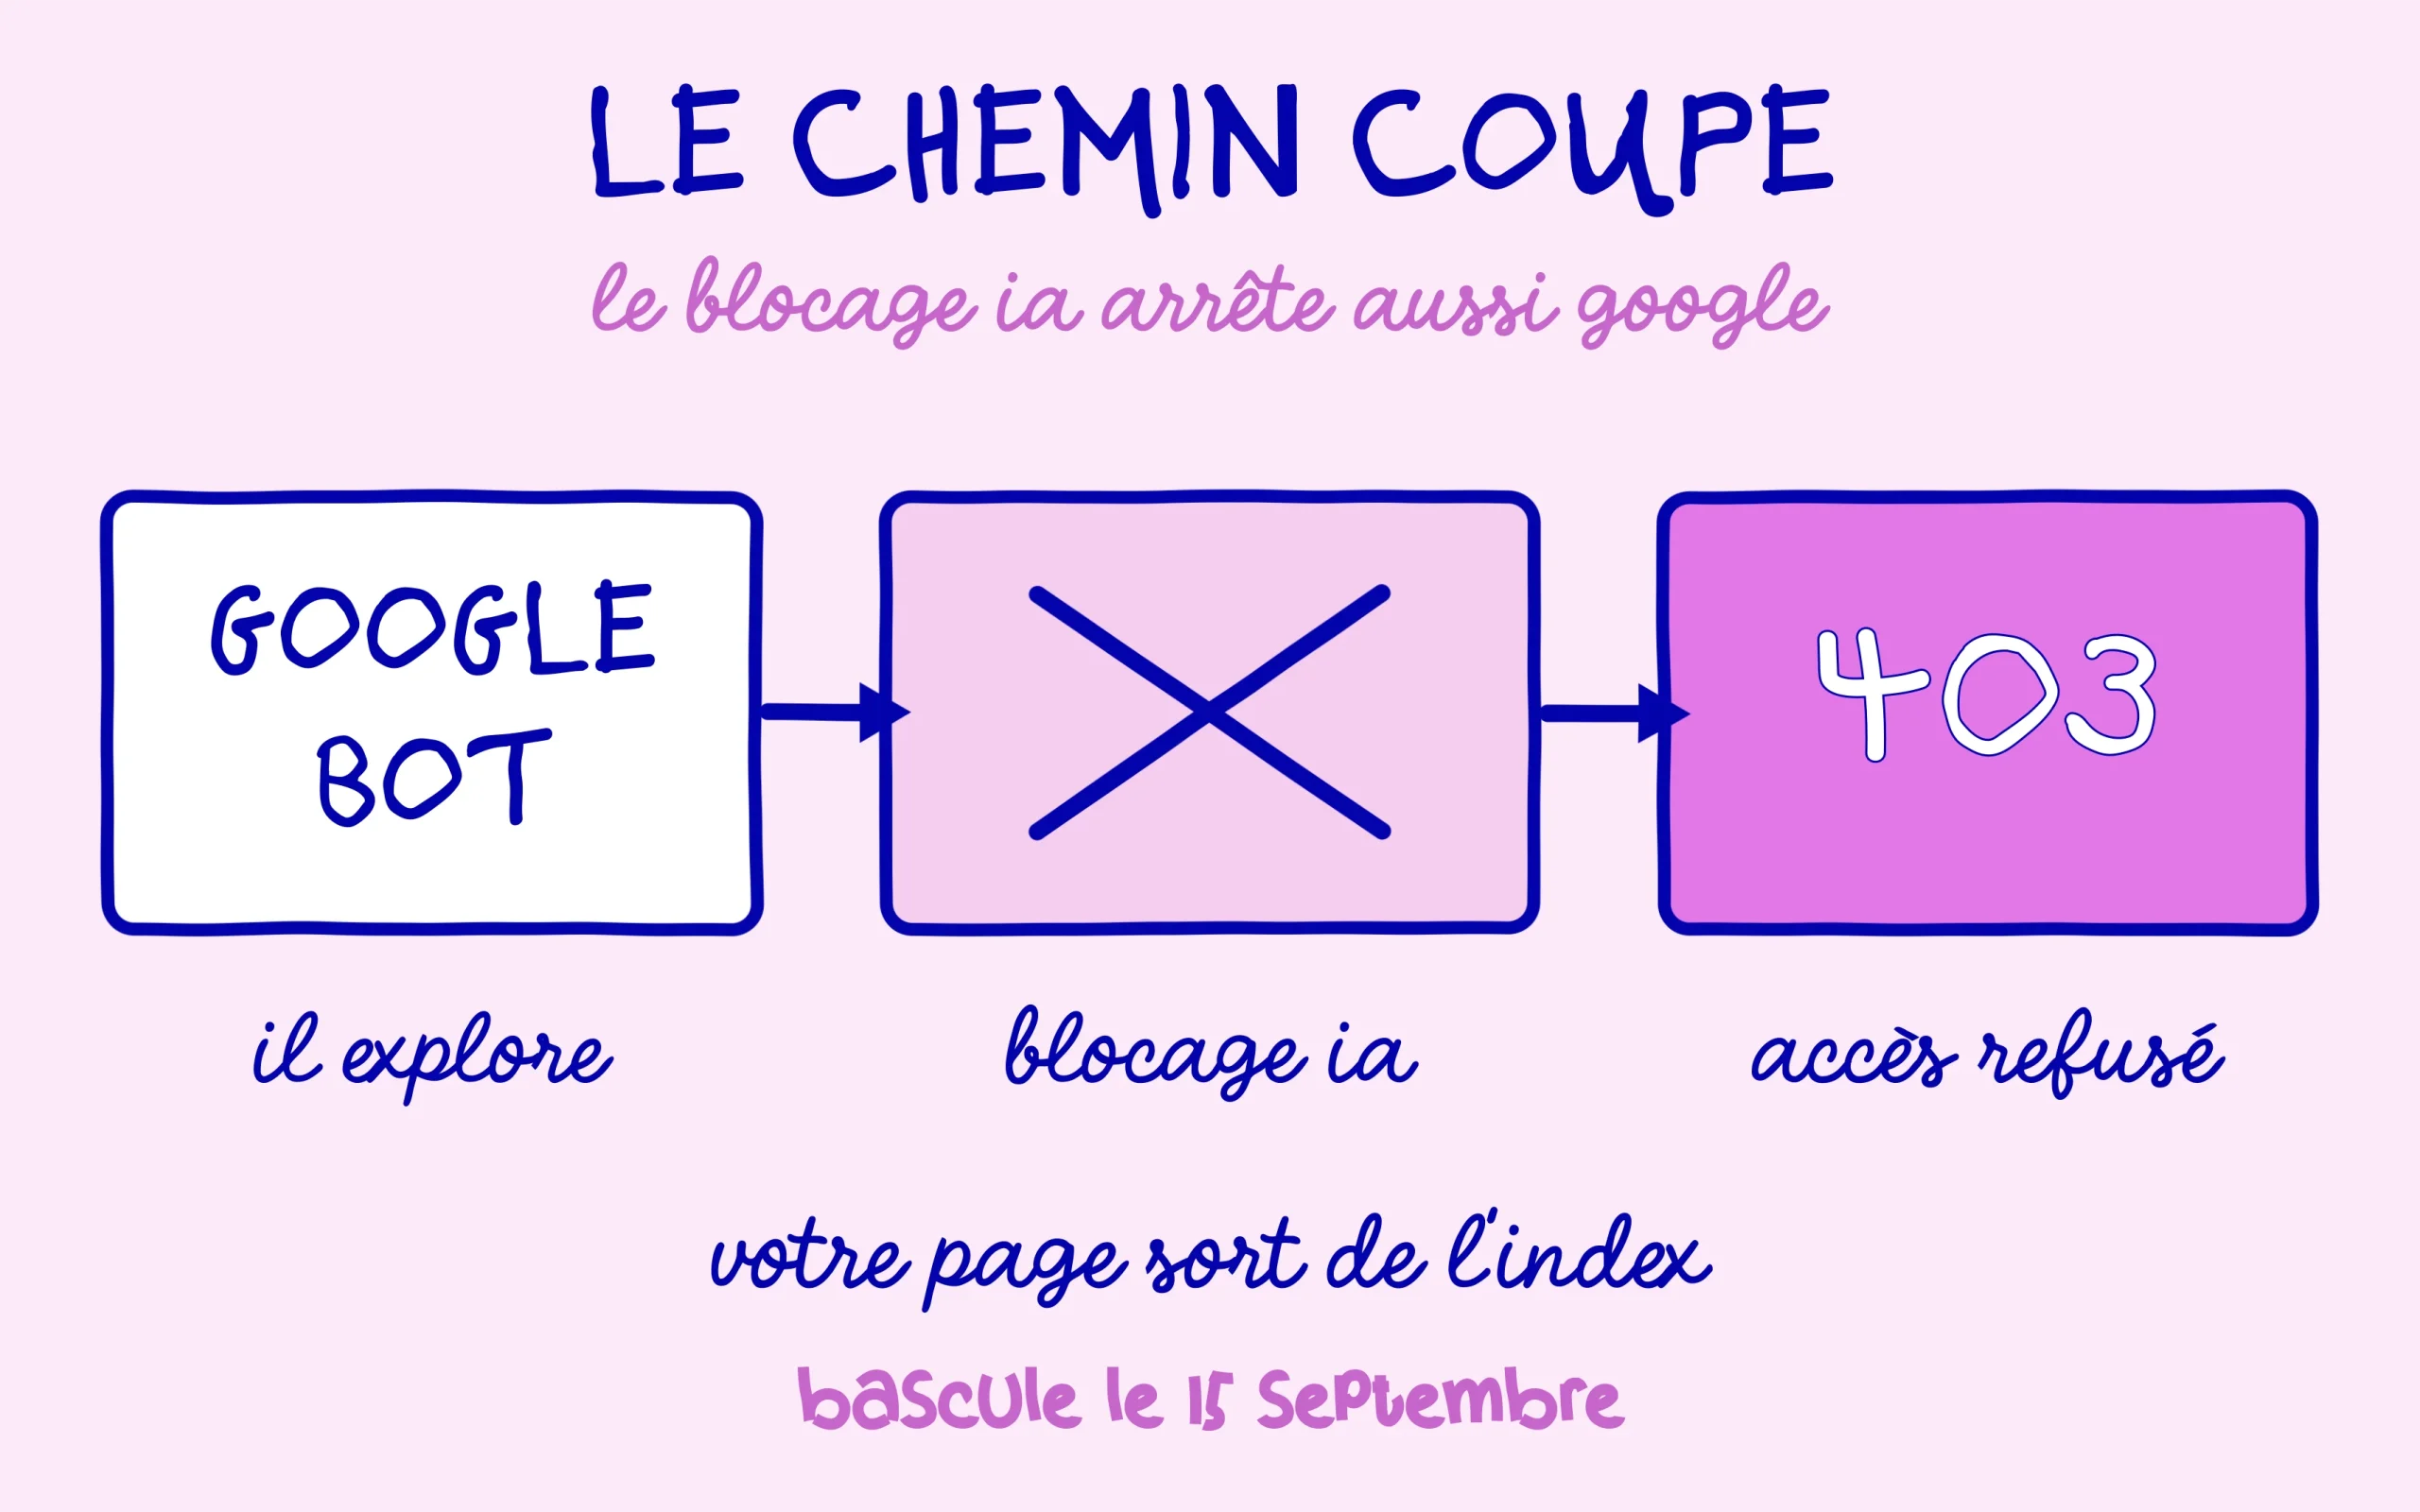
Le signalement est parti début août d’un propriétaire de site qui constatait que ses pages n’étaient plus explorées. En regardant les logs, la réponse renvoyée aux robots de Google n’était ni une page ni une redirection, mais une erreur 403, celle qui signifie littéralement un accès refusé. Google a pris acte publiquement du signalement et demandé les détails pour investiguer. Ce n’est pas la première fois que la configuration d’un réseau de diffusion interfère avec la lecture de Google, une mécanique déjà croisée avec la directive Cloudflare que Google ignore dans le robots.txt.
Deux réglages sont en cause. Le premier est le Bot Fight Mode, une protection générale contre les robots. Le second est l’option de blocage de l’entraînement IA dans la section dédiée aux crawlers, celle que beaucoup de sites ont activée depuis un an pour éviter que leur contenu serve à nourrir des modèles.
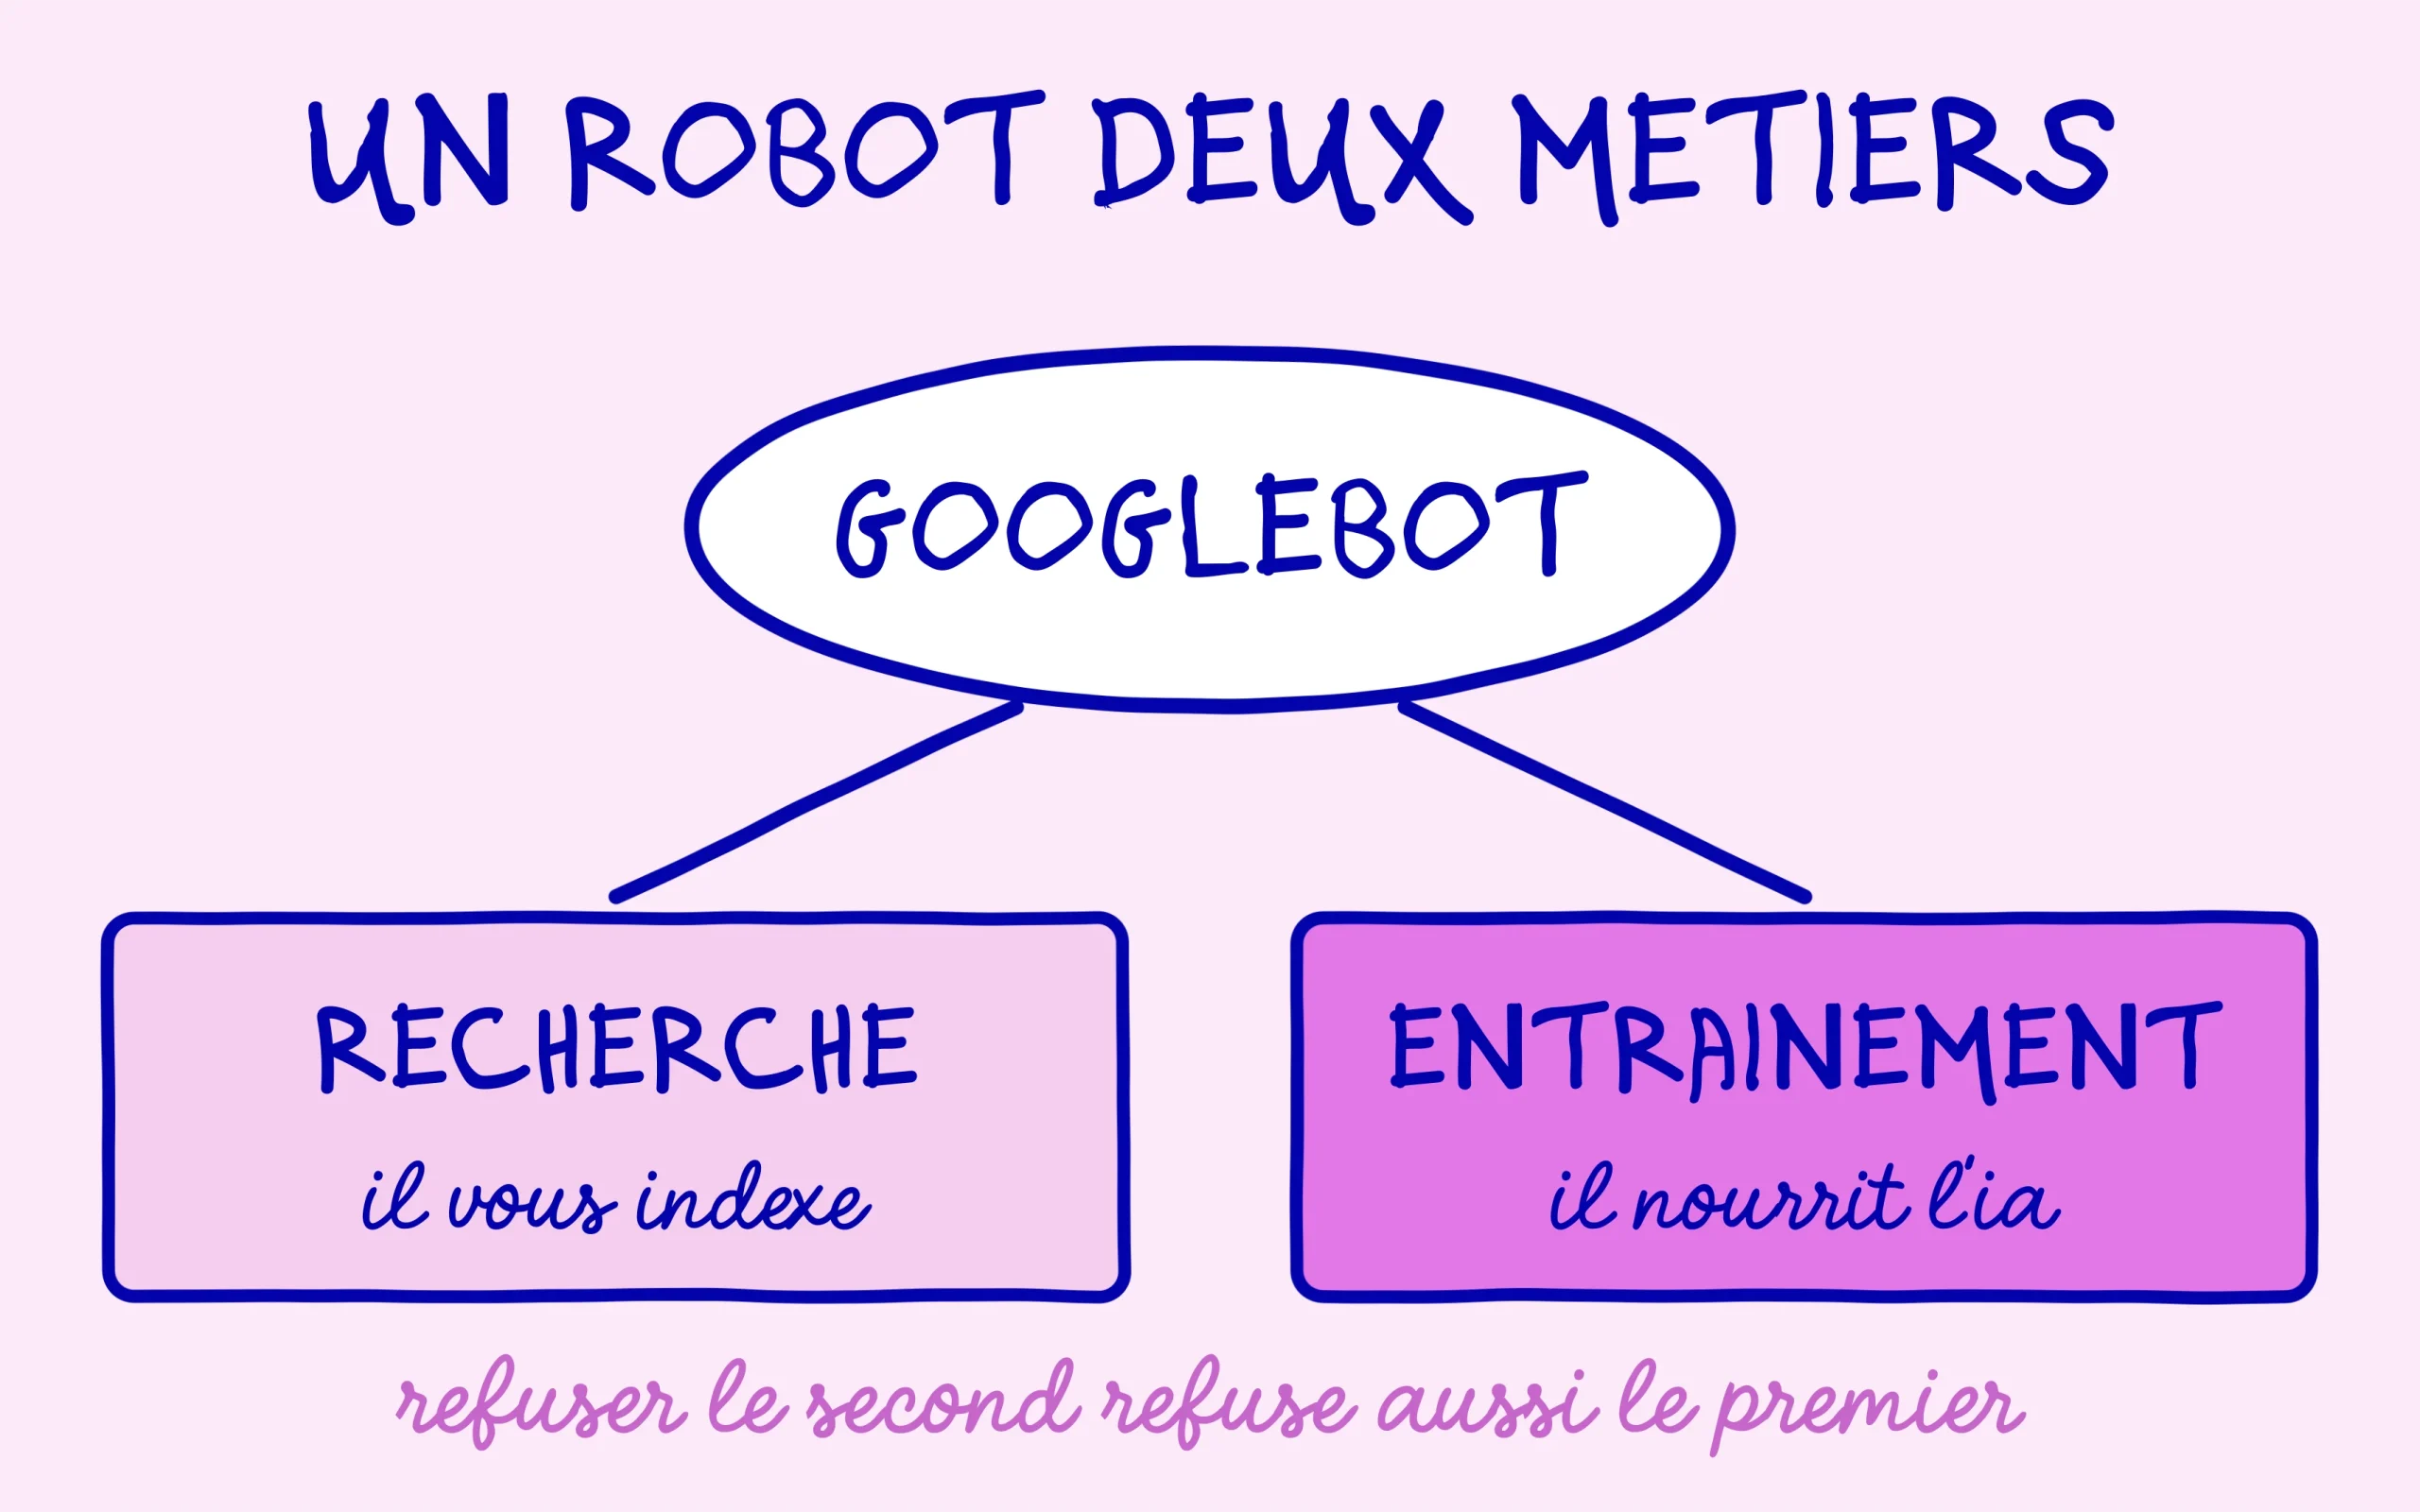
Le point à comprendre tient à la façon dont ces robots sont catégorisés. Cloudflare range les crawlers en trois familles selon leur usage : la recherche, l’agent qui agit en direct pour le compte d’une personne, et l’entraînement de modèles. Or Googlebot et Bingbot ne rentrent pas proprement dans une seule case, puisqu’ils explorent le web à la fois pour indexer et pour alimenter des systèmes génératifs.
Ces trois familles méritent d’être distinguées correctement, parce que la plupart des sites bloquent la mauvaise. La catégorie recherche regroupe les robots qui indexent votre contenu pour répondre à des questions plus tard, avec un trafic de retour attendu en échange. La catégorie agent couvre l’activité automatisée qui agit en temps réel pour quelqu’un, typiquement un assistant qui va chercher une page pendant une conversation. La catégorie entraînement, elle, désigne les robots qui aspirent votre contenu pour nourrir un modèle, sans contrepartie de visite.
Un robot à double usage tombe dans le blocage dès qu’une seule de ses fonctions est refusée. C’est exactement ce mécanisme qui explique le 403 : en refusant l’entraînement, vous refusez aussi l’indexation, parce que c’est le même robot qui fait les deux. Le principe est documenté dans la documentation officielle sur le blocage des robots IA, qui précise que les crawlers mixtes sont concernés par toutes les configurations de blocage d’entraînement.
Ce qui change vraiment le 15 septembre pour votre site
La date n’est pas anodine parce qu’elle transforme un effet de bord en règle assumée. À partir du 15 septembre 2026, deux choses s’appliquent en parallèle.
Premier volet, les nouveaux domaines qui arrivent sur la plateforme reçoivent des réglages par défaut différents. Les catégories entraînement et agent sont bloquées d’office sur les pages qui affichent de la publicité, tandis que la catégorie recherche reste autorisée. C’est une logique de protection des éditeurs qui vivent de leurs revenus publicitaires, détaillée dans l’annonce des nouvelles options de gestion du trafic IA.
Second volet, plus lourd de conséquences pour un site existant : les crawlers multi-usages seront traités selon l’ensemble de leurs comportements. Concrètement, Googlebot, Bingbot et Applebot seront bloqués chez tous les clients qui ont demandé à bloquer l’entraînement. Ce qui ressemblait à un dysfonctionnement en août devient le fonctionnement normal en septembre. D’ici là, le réflexe utile consiste à surveiller l’état réel de votre exploration plutôt que d’attendre la date, et la méthode complète tient dans notre guide pour vérifier l’indexation de votre site dans Google.
Une porte de sortie existe cependant, et elle est ouverte dès maintenant. Il est possible d’indiquer dans les réglages de sécurité qu’on ne souhaite aucun changement sur les robots d’entraînement qui explorent aussi pour la recherche. Autrement dit, on garde le blocage sur les crawlers purement dédiés à l’entraînement, et on laisse passer ceux qui servent à l’indexation.
Les trois vérifications à faire avant la rentrée
Première chose, ouvrez le tableau de bord Cloudflare de votre domaine et allez dans les réglages liés aux robots IA. Regardez si l’option de blocage de l’entraînement est active et si le Bot Fight Mode est enclenché. Si les deux le sont, vous êtes dans la configuration exacte qui a produit les erreurs 403.
Un point mérite d’être précisé pour éviter la panique inutile : les nouveaux réglages par défaut du 15 septembre ne s’appliquent qu’aux domaines qui arrivent sur la plateforme après cette date. Si votre site est déjà chez Cloudflare depuis un moment, vos réglages actuels restent en place. Le changement qui vous concerne porte uniquement sur la manière dont les robots multi-usages seront traités par les options que vous avez déjà cochées.
Deuxième chose, contrôlez l’état réel de votre indexation plutôt que de vous fier au réglage seul. Un site peut rester correctement référencé pendant plusieurs semaines avant que la baisse d’exploration ne se voie dans les résultats, ce qui rend le diagnostic tardif et coûteux à rattraper.
Troisième chose, ne comptez pas sur votre fichier robots.txt pour rattraper le coup. Un blocage appliqué au niveau du réseau intervient bien avant que le robot n’ait la moindre chance de lire vos directives, ce qui rend le fichier inopérant dans ce cas précis. La nuance rejoint la confusion fréquente entre bloquer une page et la désindexer, expliquée dans notre article sur le noindex que le robots.txt ne remplace pas.
Reste la question de fond, celle qui dépasse le réglage technique. Protéger son contenu des modèles génératifs et rester visible dans la recherche deviennent deux objectifs de plus en plus difficiles à tenir ensemble, précisément parce que les mêmes robots servent les deux usages. Cependant, pour un site qui débute et qui cherche encore son audience, la visibilité pèse largement plus lourd que la protection du contenu. Autant faire ce choix en connaissance de cause plutôt que par une case cochée un soir.
Continuez de progresser sur SEO Noobies.
[…] change, il faut revenir à la situation de l’été. Nous avions décrit début août comment Cloudflare renvoyait une erreur 403 à Googlebot quand le blocage de l’IA était actif. La raison tenait au fonctionnement des robots dits à double usage. Googlebot, Applebot et Bingbot […]