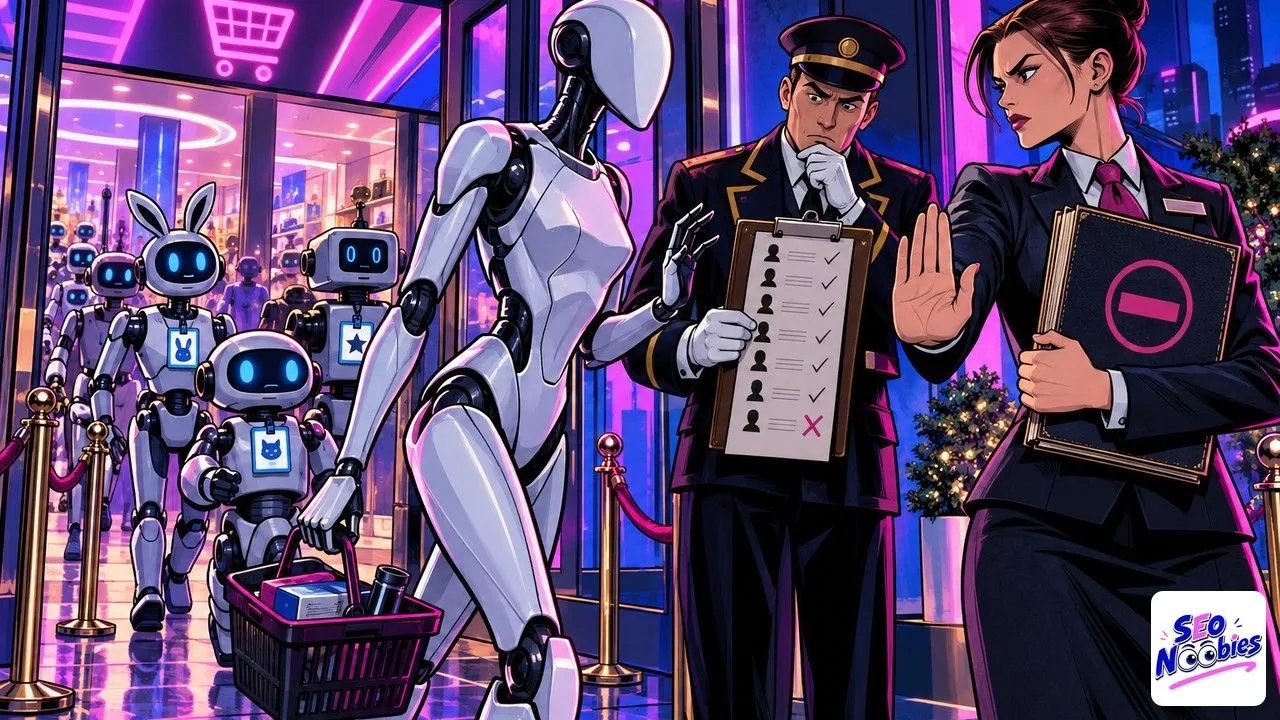
Un agent IA, c’est un assistant qui navigue sur le web à votre place : il ouvre des pages, compare des produits, remplit un panier, parfois jusqu’au paiement. Le 20 septembre, Amazon a coupé l’accès de son site à Muse, l’agent IA lancé par Meta quelques jours plus tôt. Le détail le plus instructif pour un propriétaire de site tient à l’outil utilisé : Amazon est passé par ses conditions d’utilisation, parce que son fichier robots.txt n’avait aucune prise sur cet agent. L’analyste Slobodan Manic a décortiqué l’épisode, et il raconte beaucoup de choses sur ce que ce petit fichier peut encore faire face aux assistants qui naviguent pour leurs utilisateurs. Voici ce qui s’est passé, pourquoi le robots.txt est resté muet, et ce que vous pouvez vérifier sur votre propre site.
En bref
Depuis le 20 septembre, Amazon bloque Muse, l’agent IA de Meta, en invoquant ses conditions d’utilisation acceptées par ses clients.
Amazon reproche à l’agent de naviguer sans s’identifier et de sembler conserver les identifiants de connexion des clients.
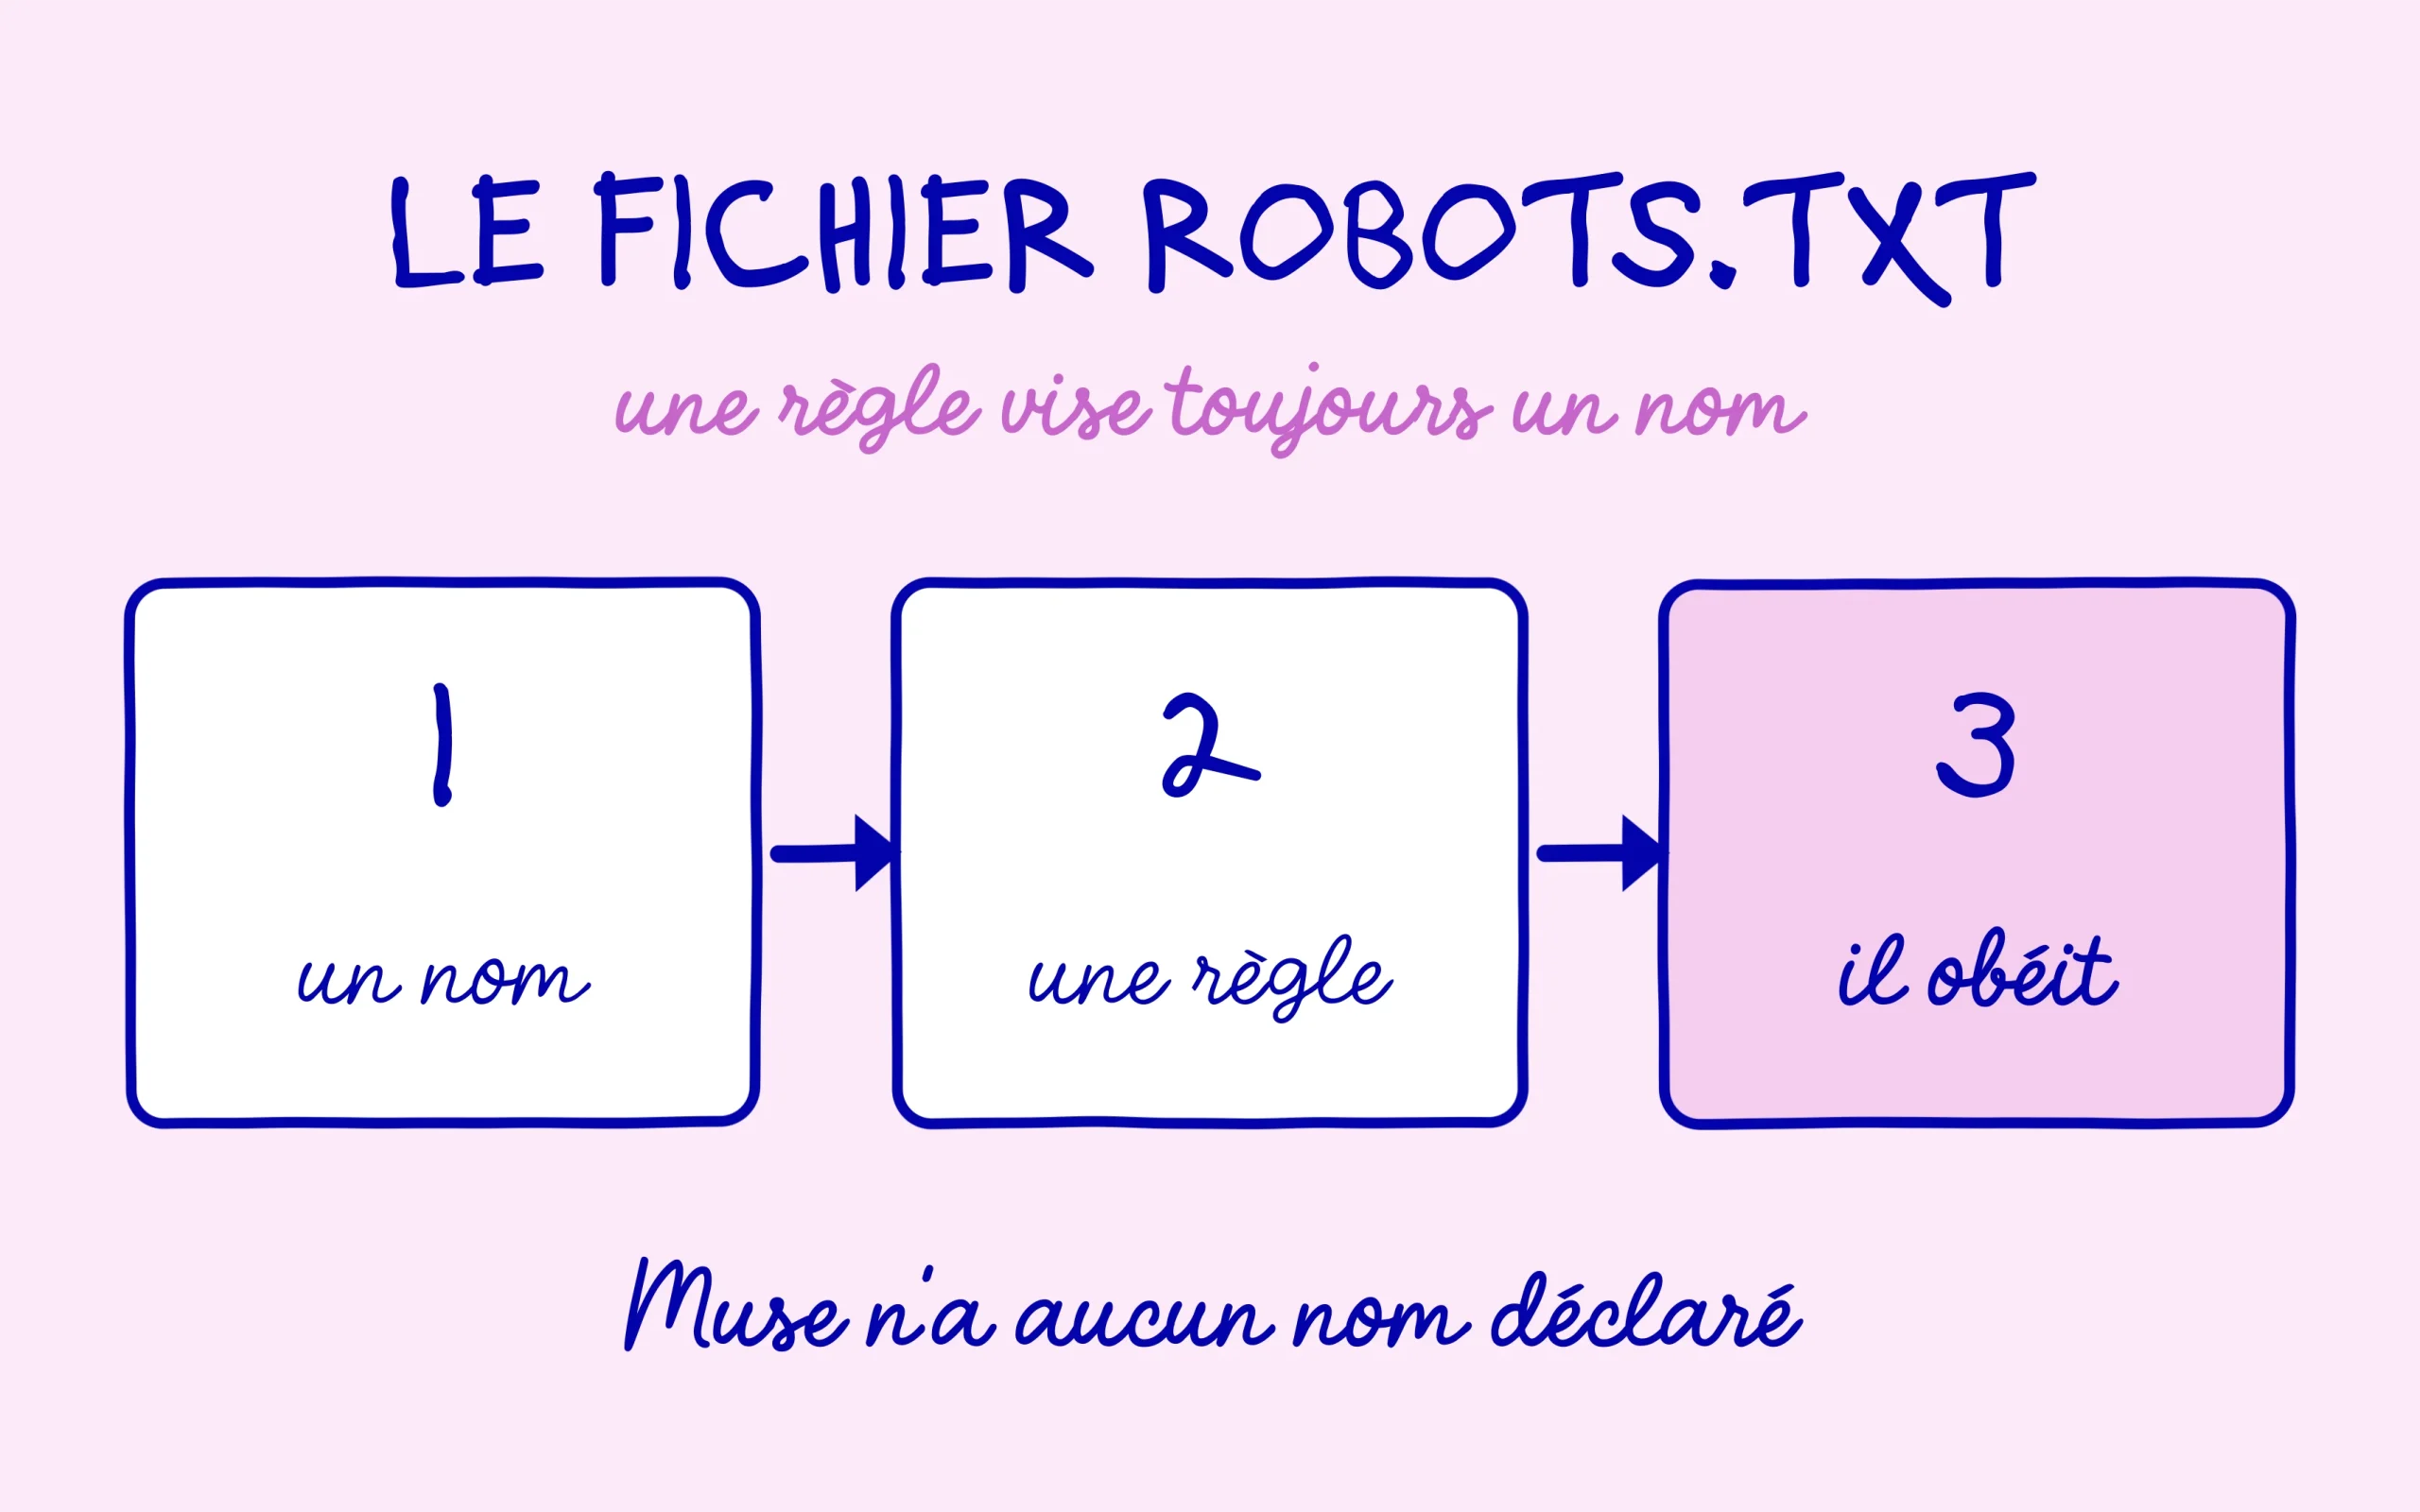
Le robots.txt fonctionne avec des noms de robots déclarés, et Meta ne publie aucun nom pour Muse dans sa documentation.
Ouvrez votre robots.txt, repérez les robots IA que vous bloquez, et vérifiez que ce choix correspond à ce que vous voulez vraiment.
Obtenir le résumé de cet article par une IA
Amazon ferme sa boutique à l’agent IA de Meta
Muse est l’agent IA que Meta a présenté début septembre pour aider ses utilisateurs à faire leurs achats ou réserver un rendez-vous en ligne. Dans la soirée du dimanche 20 septembre, les personnes qui l’envoyaient sur amazon.com sont tombées sur une page d’avertissement : « Continued access by an unauthorized AI agent violates Amazon’s Conditions of Use, to which our customers have agreed ». Autrement dit, l’accès d’un agent non autorisé enfreint les conditions d’utilisation acceptées par les clients d’Amazon.
Amazon a justifié sa décision par trois griefs, repris dans l’analyse publiée par Slobodan Manic : Meta n’a jamais prévenu Amazon que Muse viendrait sur sa boutique, l’agent ne s’identifie pas quand il navigue, et il semble capturer puis conserver les identifiants des clients. L’entreprise ajoute qu’une application qui achète au nom d’un client doit opérer ouvertement et respecter la décision du commerçant de participer ou non. Meta n’avait pas répondu publiquement au moment de la publication de cette analyse.
Le conflit dépasse le cas Muse. Amazon s’était déjà opposé en justice à Perplexity au sujet de son agent d’achat, et la question posée reste la même : un site peut-il choisir quel agent IA a le droit d’agir chez lui ? Pour un géant du e-commerce, la réponse passe par des avocats. Pour un petit site, elle passe d’abord par le robots.txt, et c’est précisément là que l’épisode devient intéressant.
Découvrir l’agence SEO Noobies
Pourquoi le robots.txt n’avait aucune prise sur cet agent IA
Petit rappel sur le fonctionnement du fichier. Une règle de robots.txt commence par nommer un robot, son « user agent », c’est-à-dire l’étiquette que le logiciel envoie à chaque fois qu’il demande une page. Elle indique ensuite ce que ce robot a le droit de récupérer. Sans nom déclaré, aucune règle ne peut viser un agent IA ou n’importe quel autre logiciel.
Or la documentation officielle des robots de Meta en liste cinq, et Muse n’y figure pas. On y trouve Meta-ExternalAgent pour l’entraînement des modèles, Meta-WebIndexer pour la recherche de Meta AI, Meta-ExternalAds pour la publicité, FacebookExternalHit pour les aperçus de liens partagés, et Meta-ExternalFetcher, qui récupère des pages à la demande d’un utilisateur. Slobodan Manic relève qu’Amazon bloque déjà trois d’entre eux dans son robots.txt, et que cela n’a rien changé pour Muse.
Un détail de cette documentation mérite d’être lu deux fois. Meta y précise que Meta-ExternalFetcher peut contourner les règles du robots.txt, au motif qu’il effectue des récupérations demandées par l’utilisateur. Le même raisonnement circule chez d’autres acteurs : SEO Noobies avait déjà montré que le robot de ChatGPT lit des pages que votre robots.txt bloque quand un utilisateur le lui demande. L’agent IA qui agit pour une personne se place dans une catégorie à part, que le robots.txt couvre mal, et chaque nouvel agent IA lancé par un grand acteur pose la même question aux éditeurs de sites.
Google le dit d’ailleurs noir sur blanc dans sa présentation du fichier robots.txt : les instructions de ce fichier ne peuvent pas obliger un robot à respecter les règles du site. Les robots sérieux les suivent, d’autres peuvent les ignorer. Le robots.txt reste un panneau d’indication, et l’épisode Muse montre ce qui arrive quand le visiteur n’a même pas de nom à lire sur le panneau.
Ce que vous pouvez vérifier dans votre propre robots.txt
Pour un site de PME ou un blog, la priorité tient rarement au blocage d’un agent IA. Le risque inverse est souvent plus grand : un robots.txt hérité d’un modèle trouvé en ligne, qui bloque des robots IA sans que personne ne l’ait décidé, et qui retire le site des réponses de ChatGPT ou de Meta AI. Commencez donc par ouvrir votre fichier, en tapant votre nom de domaine suivi de /robots.txt dans le navigateur, et listez les noms de robots qu’il mentionne.
Pour chaque robot IA bloqué, posez-vous une question simple : est-ce que ce blocage sert l’entreprise ? Bloquer un robot d’entraînement comme Meta-ExternalAgent relève d’un choix éditorial défendable. Bloquer un robot qui alimente une recherche, comme Meta-WebIndexer, revient en revanche à disparaître d’un moteur où vos clients posent peut-être déjà des questions sur votre métier. Le bon réglage dépend de votre activité, et un agent IA d’achat ne se gère de toute façon pas depuis ce fichier.
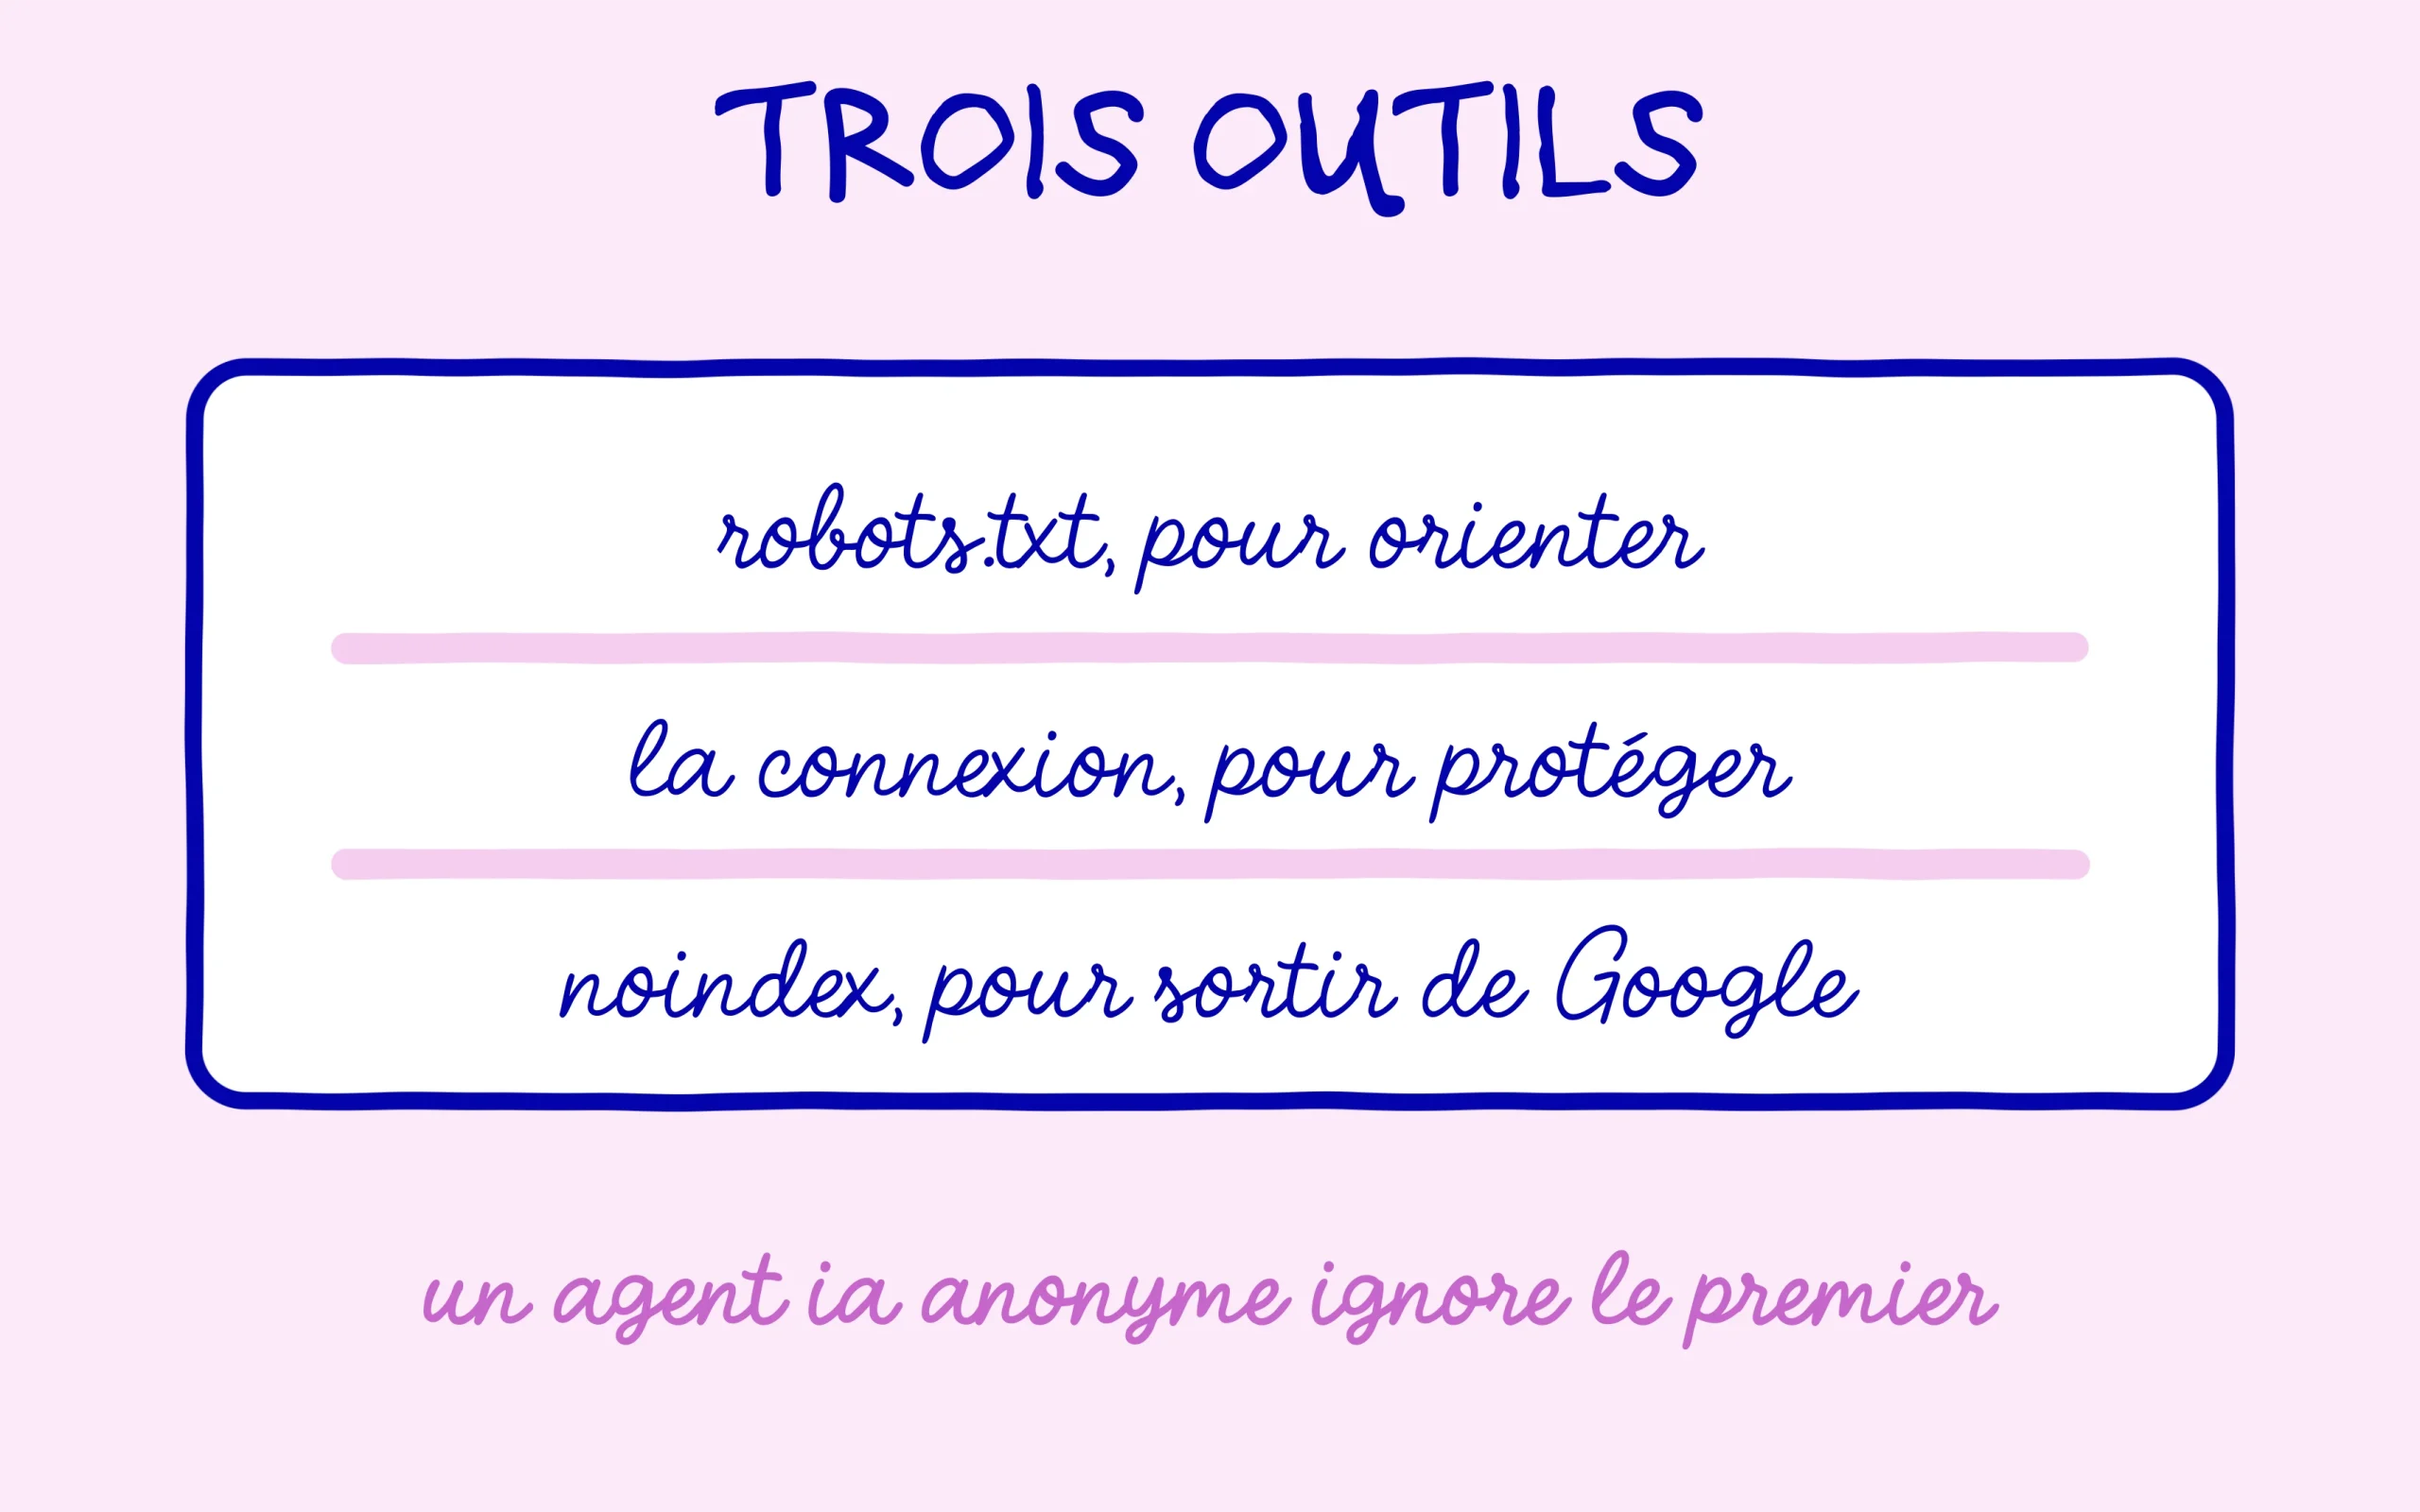
Si votre souci porte sur des pages réellement sensibles, l’espace client, les devis, les tarifs réservés aux partenaires, Google rappelle que la protection passe par d’autres méthodes, comme un mot de passe. Un contenu qui doit rester privé se met derrière une connexion. Et pour retirer une page des résultats de Google, c’est la balise noindex qui fait le travail, comme l’explique l’article sur le robots.txt qui ne remplace pas le noindex. Le robots.txt garde alors son rôle d’origine, qui consiste à orienter les robots qui acceptent de lire ses consignes.
Bref, l’histoire Muse se joue entre deux géants, mais elle laisse une leçon utile à tous les sites : le robots.txt parle aux robots qui annoncent leur nom, et un agent IA anonyme passe à côté de ses consignes. Pour tout le reste, ce sont les conditions d’utilisation, les connexions et les réglages de serveur qui prennent le relais.
Continuez de progresser sur SEO Noobies.