Une licence OpenAI change la fréquence à laquelle un éditeur de presse se retrouve cité dans ChatGPT, et une étude publiée le 20 août met enfin un chiffre dessus. Press Ranger et Otterly.AI ont passé au crible 129,3 millions de citations relevées en juin sur sept plateformes d’IA génératives, puis les ont croisées avec la liste des accords signés entre les entreprises d’IA et les éditeurs de presse. Le résultat tient dans un écart simple : 10,2 citations par page pour les éditeurs sous contrat avec OpenAI, contre 6,9 pour ceux qui n’ont rien signé. Aucun site qui démarre n’aura évidemment un contrat à négocier avec OpenAI. Ce qui rend cette étude utile pour un petit site se trouve ailleurs, dans ce que les six autres plateformes mesurées ont donné.
En bref
Press Ranger et Otterly.AI ont analysé 129,3 millions de citations relevées en juin 2026 sur sept plateformes d’IA génératives.
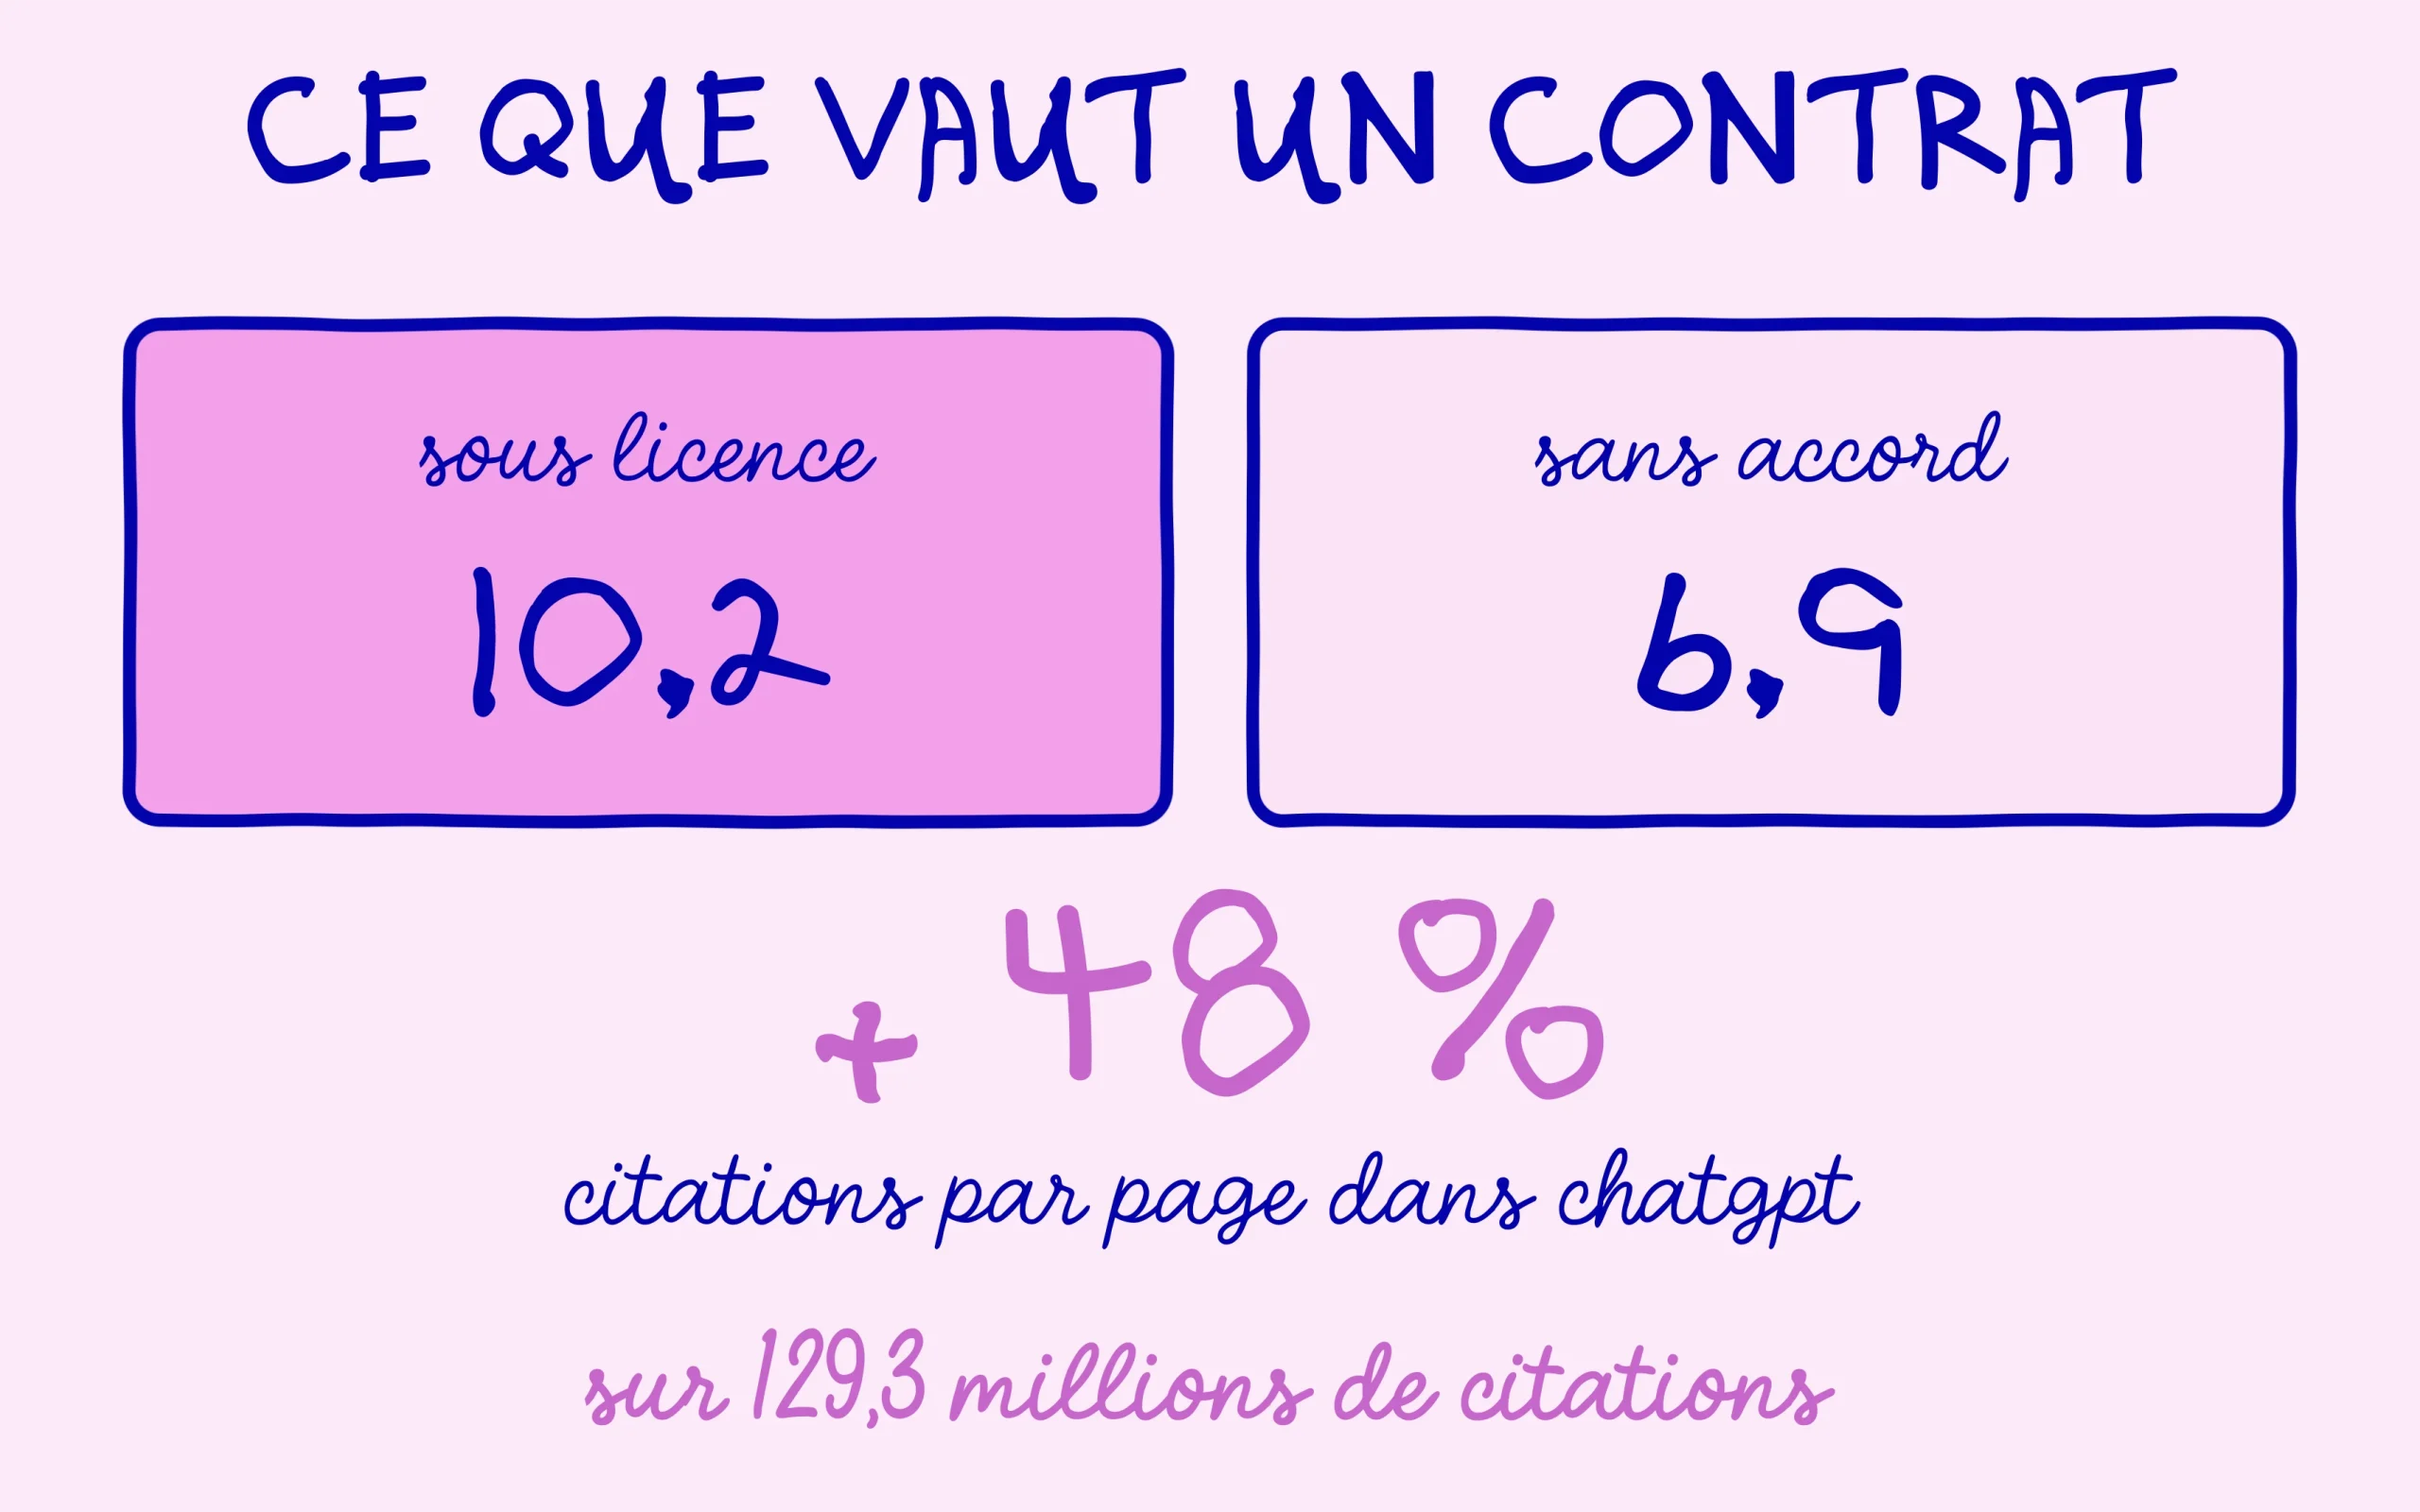
Les pages d’éditeurs sous licence OpenAI récoltent 10,2 citations en moyenne dans ChatGPT, contre 6,9 pour les éditeurs sans accord, soit 48 % de plus.
L’avantage ne se reproduit nulle part ailleurs : les éditeurs sous contrat avec Google sont légèrement moins cités dans les AI Overviews, et Perplexity traite ses partenaires comme les autres.
Pour un site sans contrat, les leviers de citation restent ceux d’avant l’étude : contenu structuré, données propres, présence sur les sources que les moteurs relisent.
Résumer cet article avec une IA
ChatGPTCe que 129 millions de citations ont permis de mesurer
L’étude a été publiée le 20 août par deux acteurs qui travaillent chacun sur une moitié du problème. Press Ranger tient une base de données de relations presse, Otterly.AI mesure la visibilité des marques dans les moteurs génératifs. Ensemble, ils ont relevé 129,3 millions de citations sur le mois de juin 2026, réparties sur sept plateformes : ChatGPT, Google AI Overviews, Google AI Mode, Perplexity, Copilot, Gemini et Claude. Chaque page citée a ensuite été rattachée à son éditeur, et chaque éditeur à ses accords de licence connus. La méthode et les résultats sont détaillés dans le communiqué qui accompagne la publication de l’étude.
Le chiffre central porte sur ChatGPT. Une page publiée par un éditeur sous licence OpenAI y récolte 10,2 citations en moyenne, quand une page équivalente d’un éditeur sans accord en récolte 6,9. L’écart fait 48 %. Il grimpe à 112 % pour les éditeurs qui ont signé avec OpenAI et avec personne d’autre. Sur l’ensemble des sept plateformes réunies, l’avantage retombe à 46 %, ce qui paraît proche du premier chiffre jusqu’à ce qu’on regarde d’où il vient. L’écart tient sur une seule plateforme et se dilue dès qu’on élargit le champ.
Reste un nombre qui éclaire tout le reste : 57,9 % du volume total de citations IA des éditeurs sous licence OpenAI provient de ChatGPT seul. Autrement dit, ces éditeurs ont bâti plus de la moitié de leur visibilité générative sur une plateforme qu’ils ne contrôlent pas et dont les règles peuvent bouger du jour au lendemain. Le décrochage observé récemment sur d’autres sources, comme celui détaillé dans notre article sur l’effondrement des citations Reddit dans ChatGPT, montre à quelle vitesse ce genre d’équilibre se déplace.
Pourquoi la licence OpenAI ne pèse que sur ChatGPT
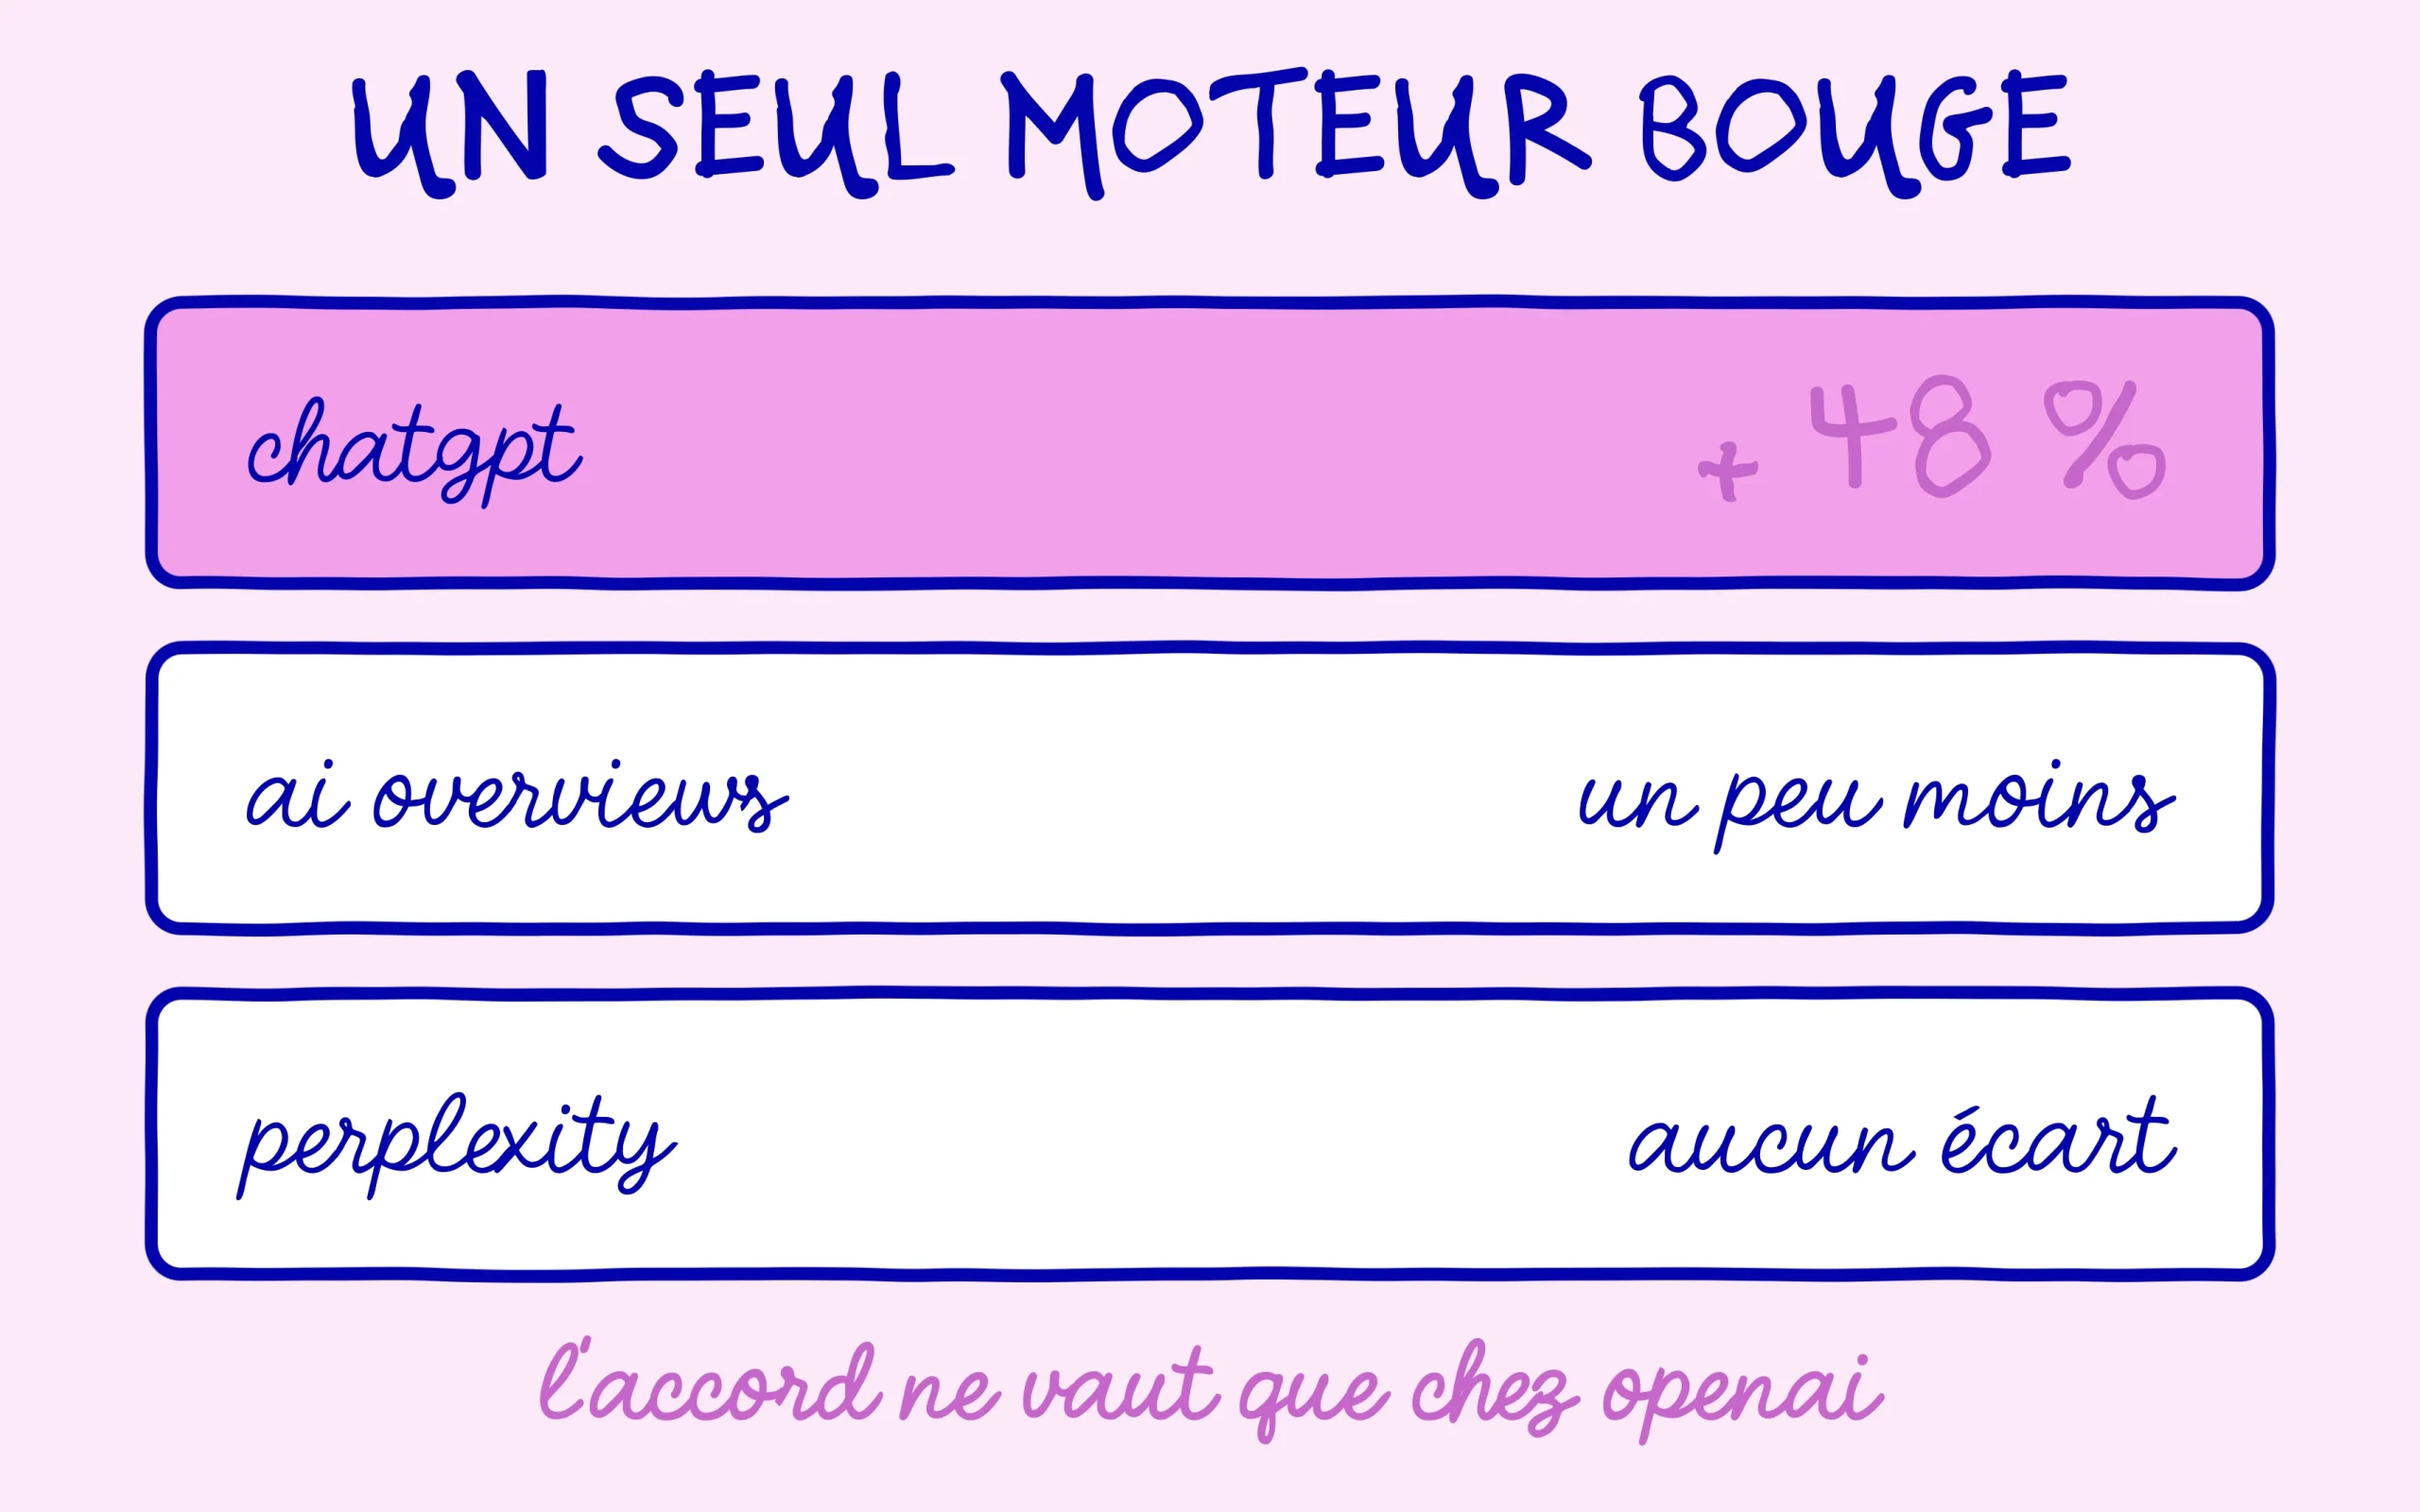
Sur Google, le résultat s’inverse légèrement. Les éditeurs qui ont un accord avec Google sont cités dans les AI Overviews à un rythme un peu inférieur à celui d’éditeurs comparables sans accord. Chez Perplexity, les partenaires sous contrat arrivent à parité stricte avec les autres. La licence OpenAI ressort donc comme le seul accord de l’échantillon qui produit un avantage visible sur la plateforme de celui qui paie. Toutes les autres signatures relevées dans l’étude n’ont eu aucun effet mesurable sur les citations.
Thomas Peham, cofondateur et directeur général d’Otterly.AI, la plateforme autrichienne de suivi des citations dans les IA, insiste sur ce point dans la présentation des résultats : l’accord commercial ne se traduit pas mécaniquement en visibilité. Il faut le prendre pour ce que c’est. Une corrélation observée sur un mois de relevés ne prouve pas qu’OpenAI favorise délibérément ses partenaires dans les réponses. Les éditeurs qui signent ces contrats sont aussi, très souvent, ceux qui publiaient déjà beaucoup et qui étaient déjà bien identifiés avant l’accord.
En revanche, l’absence d’effet chez Google et chez Perplexity dit quelque chose d’utile sur la manière dont ces moteurs choisissent leurs sources. Ils continuent d’aller chercher ce qu’ils jugent pertinent, contrat ou pas, selon des mécanismes de sélection que nous avons détaillés dans notre article sur la façon dont l’index de ChatGPT choisit les pages qu’il cite. Payer un éditeur ne le fait pas mieux citer partout, et c’est plutôt une bonne nouvelle pour tous ceux qui n’ont rien à signer.
Ce qu’un site sans accord de licence peut en retenir
Aucun site qui démarre ne signera de contrat avec OpenAI, et il n’y a pas de version allégée de ce type d’accord pour les petits éditeurs. La question utile devient donc celle des places qui restent. Elles existent, et elles sont nombreuses : les grands médias sous licence représentent une part limitée des sources citées, loin derrière les plateformes communautaires et encyclopédiques dont nous parlions dans notre analyse des sources que les IA citent bien plus que les médias. Le reste du volume se répartit entre des milliers de sites qui n’ont jamais rien négocié avec personne.
Trois vérifications tiennent en une heure et valent mieux qu’une veille sur les accords de licence. Vérifiez d’abord que votre robots.txt laisse effectivement passer les robots des moteurs génératifs, parce qu’un blocage hérité d’un plugin de sécurité fait plus de dégâts qu’un concurrent sous contrat. Assurez-vous ensuite que vos pages énoncent leurs faits de façon isolable, avec des chiffres, des dates et des phrases qui se tiennent sorties de leur paragraphe. Regardez enfin où votre marque apparaît en dehors de votre propre site, parce que c’est cette présence tierce que les moteurs recoupent quand ils décident qui citer.
Toutefois, une étude portant sur un seul mois de relevés ne suffit pas à fonder une stratégie. Juin 2026 est une photographie, les accords évoluent, et rien ne garantit que la licence OpenAI produira le même écart en décembre. La lecture raisonnable consiste à noter l’ordre de grandeur et à surveiller si le prochain relevé confirme la tendance. Pour un site qui débute, la conclusion pratique tient en une ligne : ce qui vous rend citable ne s’achète pas, du moins pas à votre échelle, donc autant travailler ce sur quoi vous avez la main.
Continuez de progresser sur SEO Noobies.
[…] intérêt. Reste à savoir qui se retrouve cité dans ces réponses, une question sur laquelle les accords de licence signés par OpenAI pèsent déjà […]
[…] produit un effet mesurable sur la présence dans les réponses, documenté dans notre analyse de l’écart de citations observé entre éditeurs sous licence et éditeurs sans accord. Un moteur qui paie ses sources construit mécaniquement une relation différente avec elles. […]