On parle de l’index de ChatGPT au singulier depuis des mois, et l’analyse publiée le 4 septembre par Tomek Rudzki sur le blog de Peec AI montre qu’il faudrait plutôt parler d’index spécialisés au pluriel. Douze, précisément, chacun dédié à un type de contenu. Un pour le web général, un pour l’actualité, un pour le juridique, un pour le médical, un pour le commerce, un pour les données locales. Concrètement, la question de savoir si votre page est connue de ChatGPT n’a plus une seule réponse : elle dépend du rayon dans lequel on la cherche. Voilà ce que le relevé montre et comment le lire quand on débute.
En bref
ChatGPT ne consulte pas une base unique mais une famille de douze index spécialisés, répartis par domaine.
Un champ technique visible dans les échanges de ChatGPT entre le 21 mai et le 21 juillet 2026 a permis d’observer d’où venait chaque résultat.
Le robot d’OpenAI explore à un rythme mesuré de 35 000 requêtes par heure, mais reste très loin d’avoir tout vu.
Être visible dans le rayon qui correspond à votre activité compte plus que d’être présent quelque part.
Résumer cet article avec une IA
ChatGPTDouze index spécialisés au lieu d’une seule base
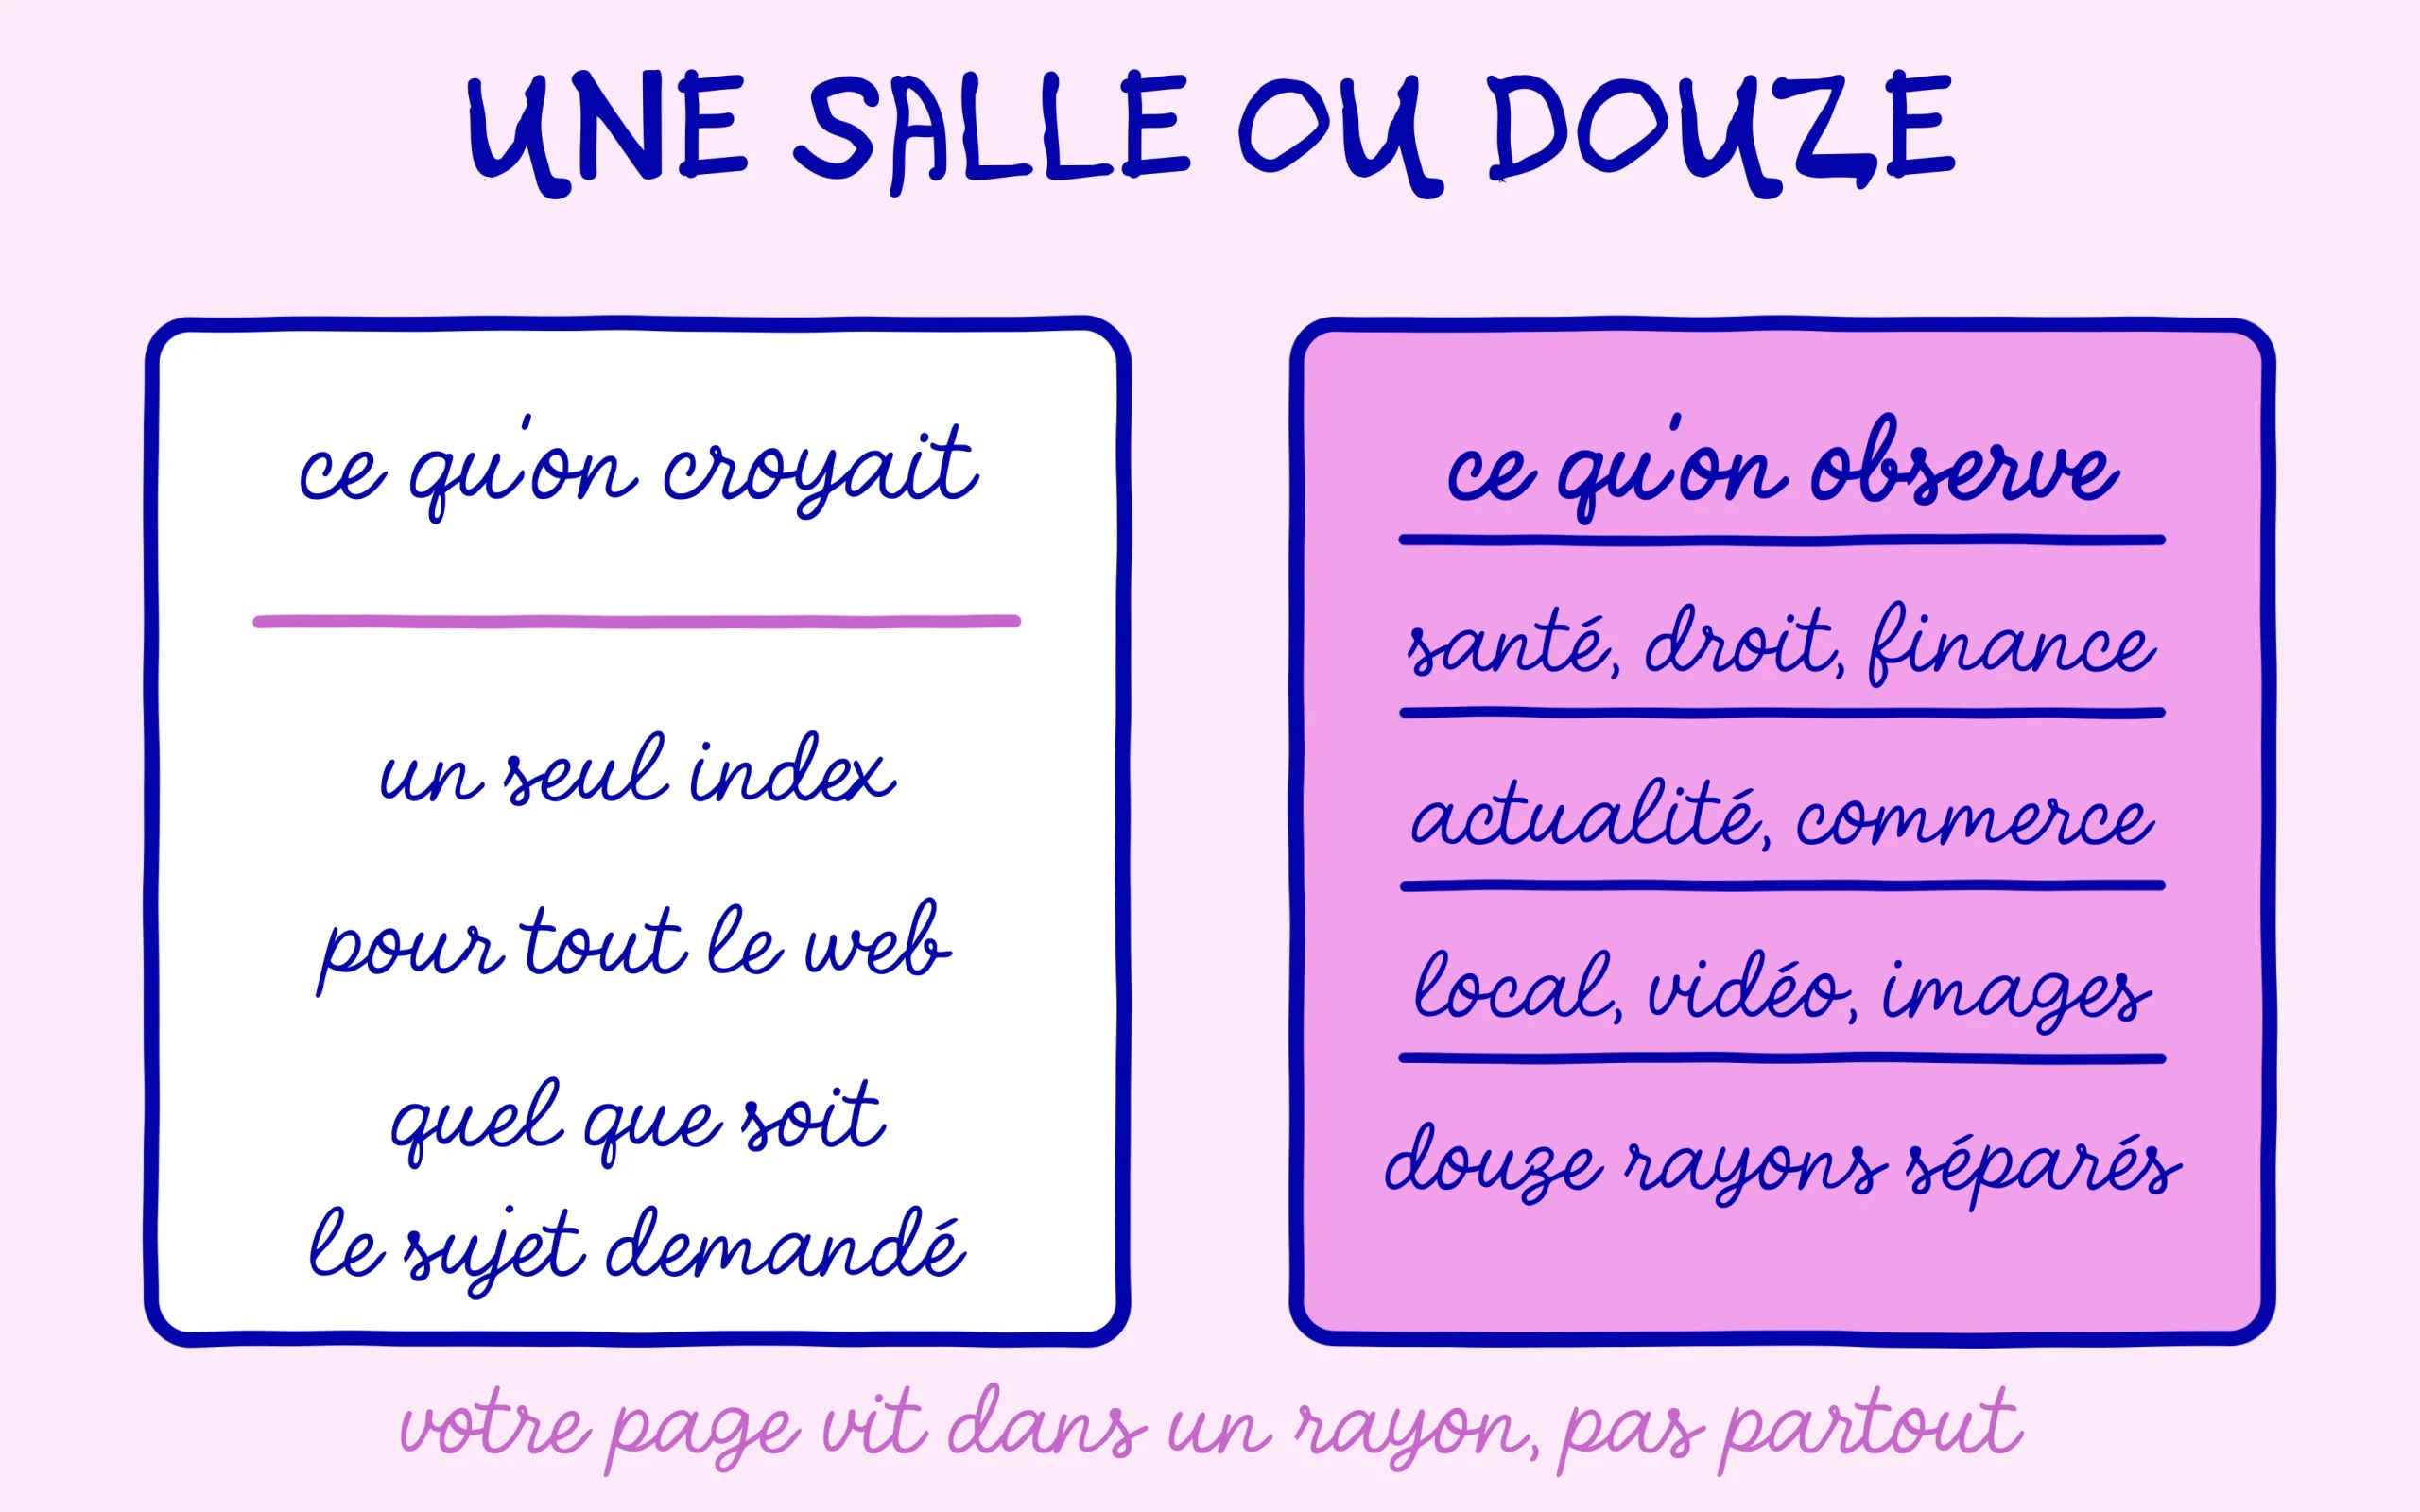
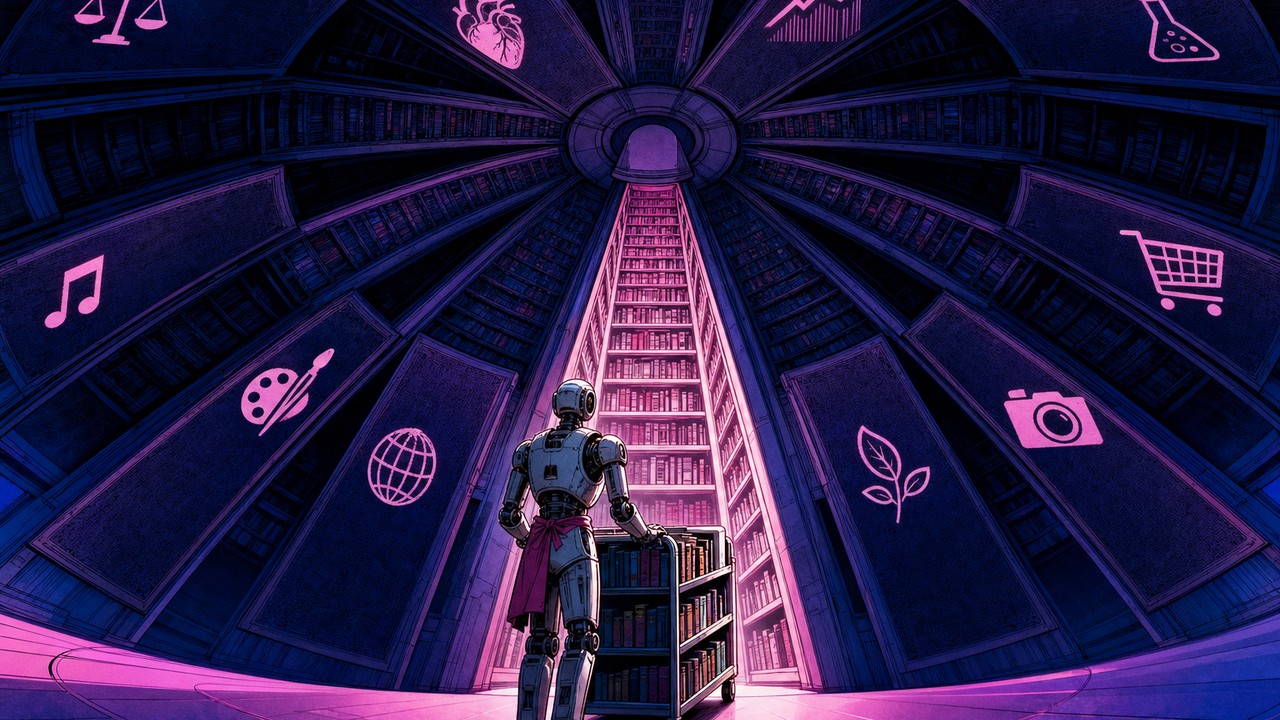
L’index maison d’OpenAI porte un nom de code interne, Labrador. Son existence était déjà connue, et nous avions décrit comment l’index de ChatGPT choisit les pages qu’il cite. Ce que l’analyse apporte de neuf, c’est sa composition. Là où on imaginait une grande base unique, on trouve une famille : web général, PDF, YouTube, actualité avec ses propres niveaux de fraîcheur, arXiv pour les publications scientifiques, Wikipédia, local, finance, juridique, médical, commerce et images.
Pour se représenter la chose, la bibliothèque reste l’image la plus juste. Une bibliothèque qui range tout dans une seule salle traite un livre de droit et un guide de cuisine de la même façon. Une bibliothèque organisée en rayons envoie le lecteur au bon endroit selon ce qu’il demande. Ces index spécialisés font exactement ça, et le tri se joue avant même que votre page soit évaluée.
Un détail qui compte : la présence d’un rayon consacré à l’actualité, avec ses propres niveaux de fraîcheur, dit que la date d’une page ne pèse pas partout pareil. Sur une question d’actualité, une page de trois ans a peu de chances de servir. Sur une question de droit ou de méthode, l’ancienneté ne pose aucun problème tant que le contenu tient. Beaucoup de sites se sont mis à republier mécaniquement leurs vieux articles avec une date fraîche, et cette distinction montre à quel point le réflexe est mal calibré.
Pour un site de niche, la conséquence pratique est directe. Un cabinet comptable, un site de santé, une boutique en ligne ne jouent pas dans le même rayon, et rien ne garantit que la présence dans l’un vaille présence dans l’autre. À la question de savoir si vous êtes connu de ChatGPT, ces index spécialisés en ajoutent donc une autre, posée en amont : dans quel rayon vous cherche-t-il exactement.
Ce qu’un champ technique laissé visible a permis d’observer
La méthode mérite d’être expliquée, parce qu’elle dit beaucoup sur l’état des connaissances en la matière. Entre le 21 mai et le 21 juillet 2026, un champ nommé result_source apparaissait dans les échanges techniques entre ChatGPT et le navigateur. Ce champ indiquait la provenance de chaque résultat affiché, avec quatre valeurs possibles : l’index maison d’un côté, trois fournisseurs extérieurs de l’autre.
Autrement dit, l’observation repose sur une fenêtre qui s’est refermée. Le champ a disparu depuis, et ce qu’on sait vient de ces deux mois d’observation. C’est honnêtement plus solide que la plupart de ce qui circule sur le sujet, et c’est aussi la limite à garder en tête avant de tirer des règles définitives d’un relevé daté.
L’analyse rappelle par ailleurs qu’OpenAI continue de s’appuyer sur au moins huit fournisseurs extérieurs, dont Google, Bing, Yelp et TripAdvisor. L’index maison ne remplace donc rien pour l’instant, il s’ajoute. Sur le commerce, des tests comparent les deux approches sur des portions de trafic allant de 8 à 20 %, ce qui ressemble beaucoup à une bascule en préparation plutôt qu’à une expérience de curiosité. Le détail complet figure dans l’analyse de Tomek Rudzki sur le blog de Peec AI.
Ce que ça change pour un site qui démarre
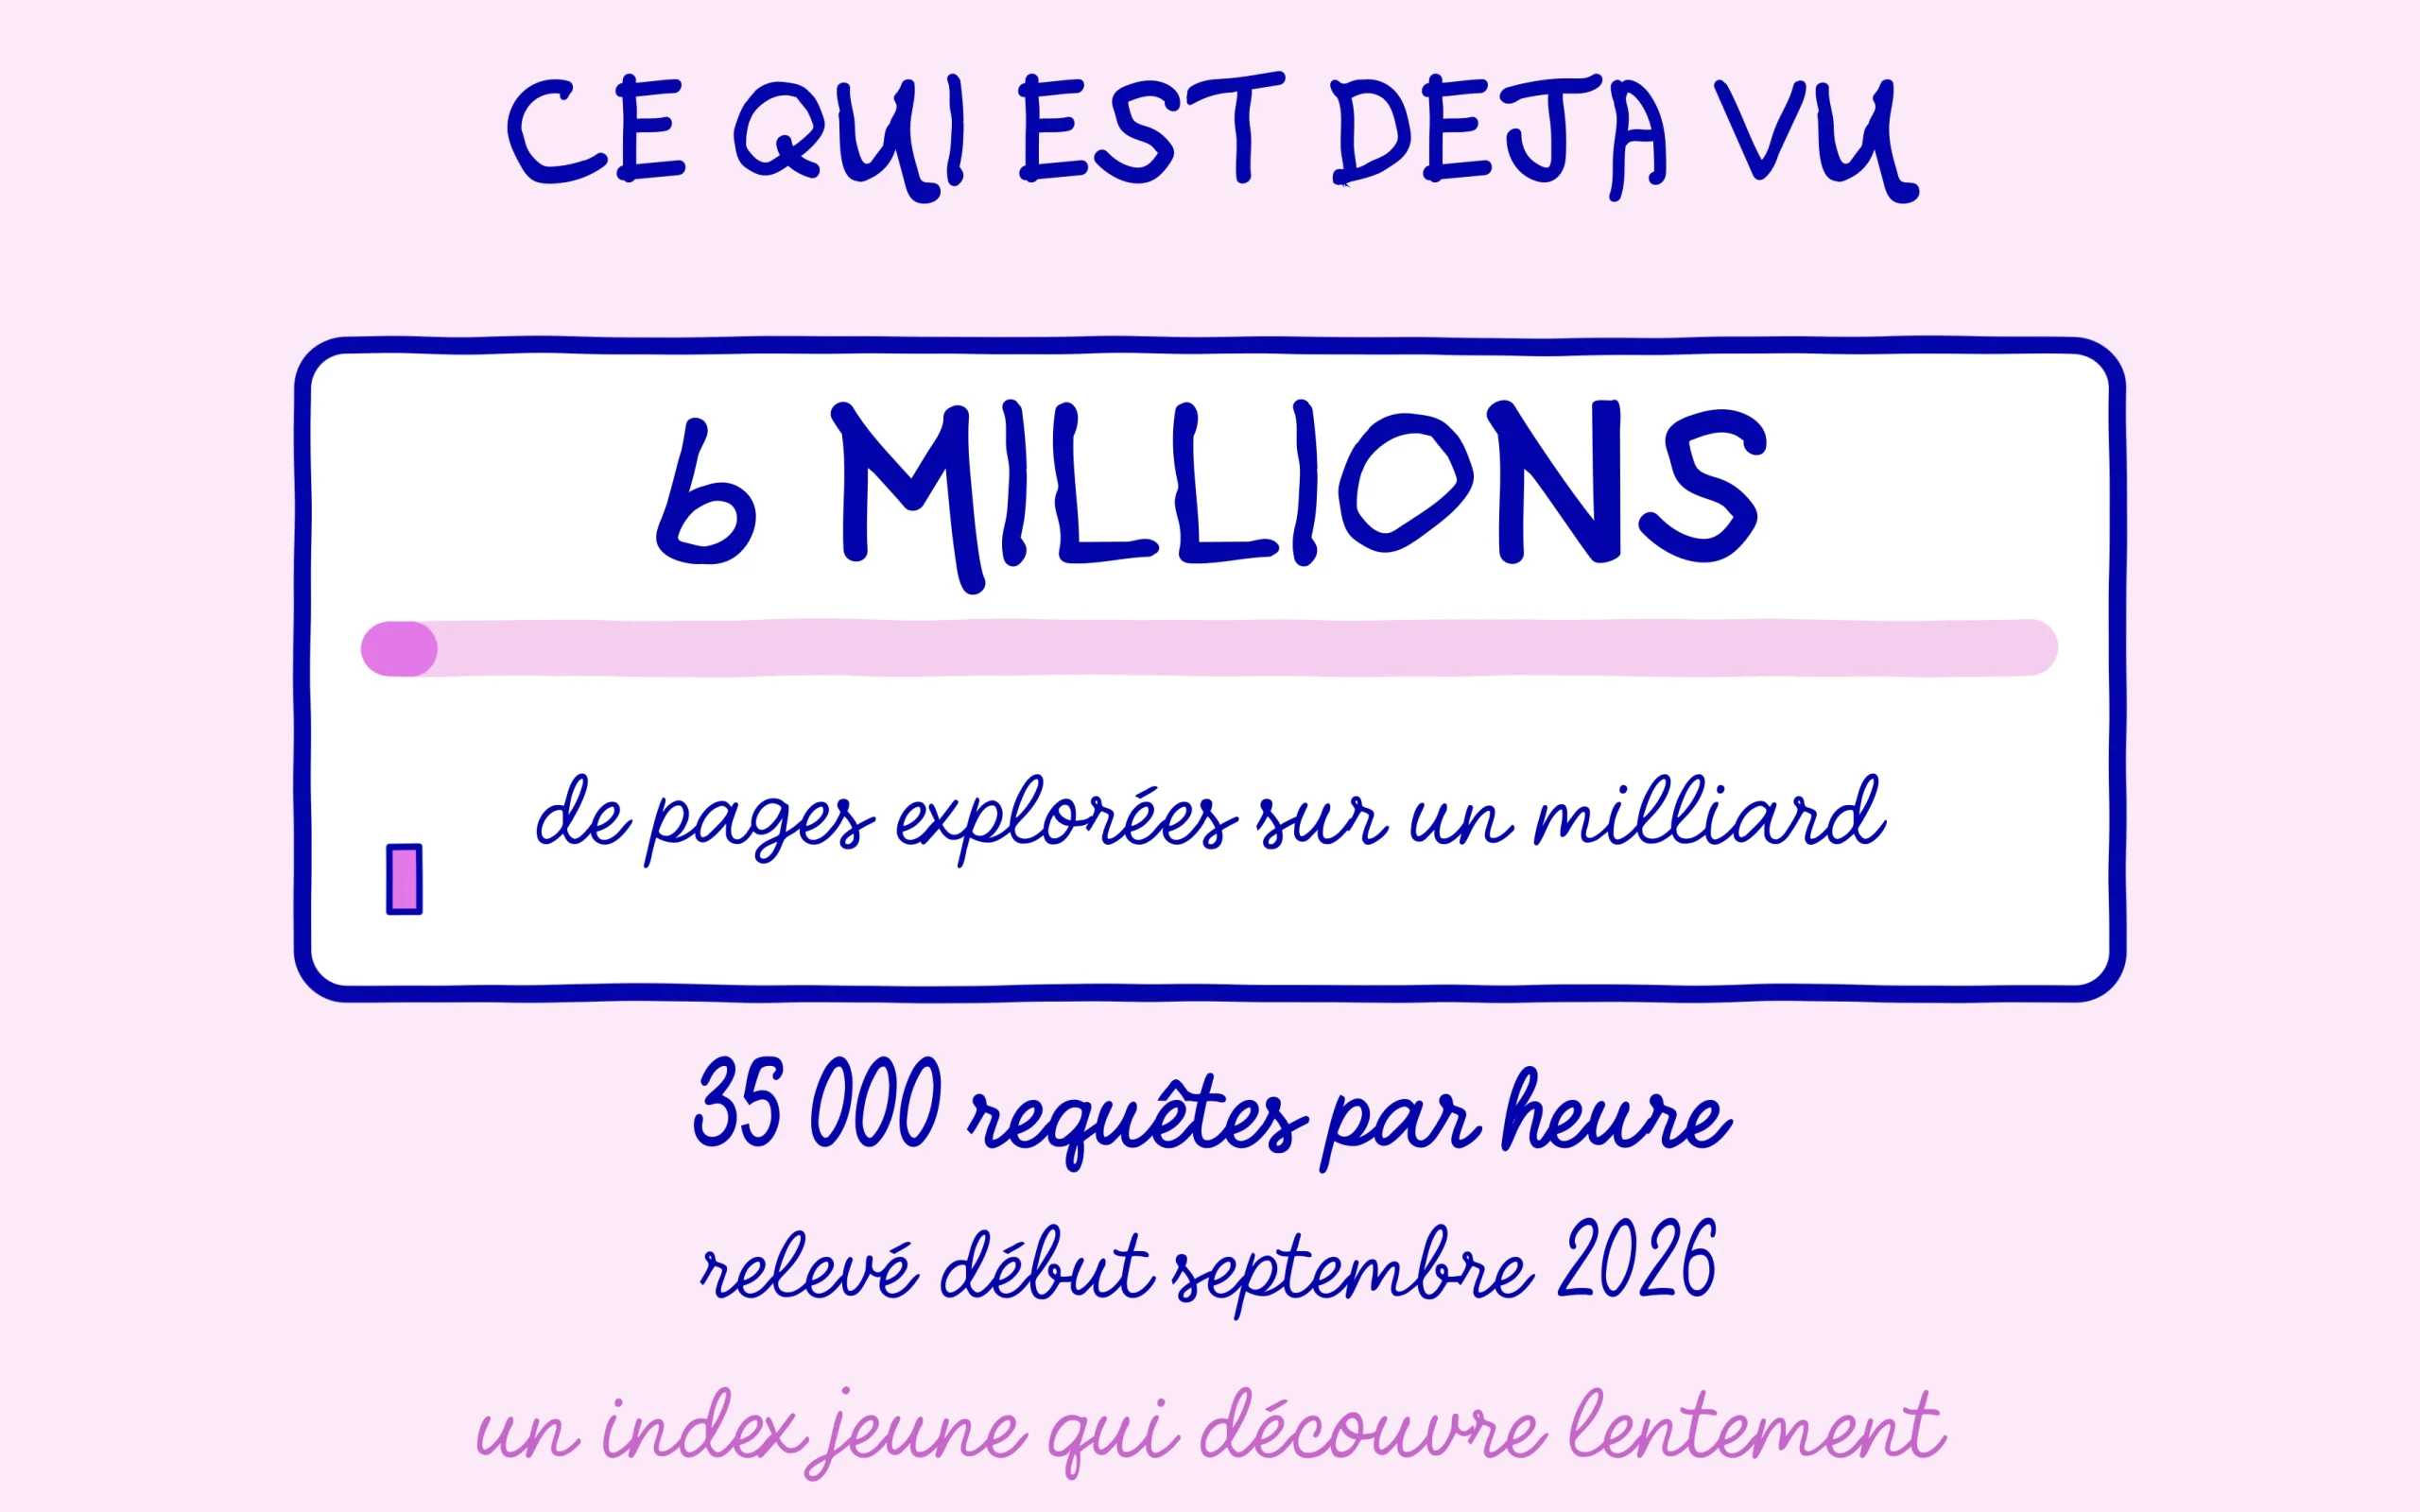
Le chiffre qui remet les choses à leur place est celui du crawl. Sur un site test d’un milliard de pages, le robot d’OpenAI en avait exploré six millions début septembre, à un rythme de 35 000 requêtes par heure. Ramené à l’échelle du web, c’est un index encore jeune, qui découvre bien plus lentement que Google. Un site récent a donc mécaniquement peu de chances d’y figurer, et ce n’est pas un problème de qualité de contenu.
Cependant, cette lenteur a une contrepartie utile. Un index qui explore peu s’appuie davantage sur les sources qu’il connaît déjà, ce qui rejoint ce qu’on observe sur la manière dont les citations ChatGPT varient selon votre secteur. Un site de santé, un site juridique et un site de voyage n’affrontent pas la même concurrence pour la même raison : ils ne partagent pas le même rayon.
En pratique, la chose la plus utile à faire reste la plus simple : regarder ce qui sort réellement quand on pose à ChatGPT les questions de son domaine, et noter qui est cité. C’est gratuit, ça prend un quart d’heure, et vos citations dans les IA se vérifient sans payer d’outil. Vous verrez rapidement si les réponses de votre secteur reposent sur des sites indépendants ou sur trois grandes références installées.
Attention en revanche à ne pas transformer cette découverte en chantier technique. On voit déjà passer des conseils invitant à baliser ses pages pour signaler leur domaine aux index spécialisés, comme si un marqueur suffisait à choisir son rayon. Rien dans le relevé ne va dans ce sens, et OpenAI n’a documenté aucun mécanisme de ce type. Le classement se fait sur ce que la page contient réellement, jamais sur ce qu’elle déclare être dans une balise ajoutée pour l’occasion.
Le reste ne bouge pas. Aucune balise, aucun fichier à la racine, aucun réglage caché ne vous fait entrer dans ces index spécialisés. Ce qui vous y fait entrer, c’est d’être accessible au robot d’OpenAI et d’être une page que quelqu’un a une raison de citer sur son sujet. Ce sont deux chantiers longs, et ils étaient déjà les bons avant cette découverte.
Continuez de progresser sur SEO Noobies.