On répète depuis deux ans qu’il faut optimiser pour ChatGPT sans jamais vraiment savoir ce que la machine va chercher, ni où. Une étude publiée début août change franchement la donne sur ce point, parce qu’elle documente pour la première fois le fonctionnement réel de l’index de ChatGPT à partir de données observées et non de suppositions. Ce qu’on y apprend est parfois contre-intuitif, notamment sur le rôle de Bing, sur ce qui déclenche une citation, et sur la façon dont votre page est stockée une fois lue. Après un an à suivre le référencement sur les IA sur mes propres sites, honnêtement, plusieurs de mes hypothèses sont tombées à la lecture. Voilà ce que cette mécanique implique concrètement pour un site qui débute.
En bref
ChatGPT s’appuie sur un index maison, distinct de Google et de Bing, qui renvoie pour chaque résultat une URL, un titre complet et un extrait d’environ 200 caractères.
Un cache de lecture partagé entre tous les utilisateurs stocke les pages complètes converties en Markdown, avec une fenêtre de fraîcheur de trente minutes.
Une page réellement ouverte par le modèle finit citée 74 % du temps, contre 7 % pour une page simplement présente dans l’index.
Plus de 90 % des utilisateurs restent en version gratuite, donc sur le mode qui n’ouvre presque jamais les pages : être bien indexé compte autant qu’être bien rédigé.
Résumer cet article avec une IA
ChatGPTL’index de ChatGPT n’est pas alimenté par Bing
Commençons par le point qui bouscule le plus les habitudes. On a longtemps répété que ChatGPT s’appuyait sur Bing pour ses recherches web, ce qui poussait pas mal de débutants à soigner leur présence sur Bing Webmaster Tools en priorité. Les données ne soutiennent pas cette lecture.
L’étude conduite par Olivier De Segonzac, fondateur de Resoneo, repose sur 1 249 réponses capturées, 88 000 résultats de recherche, 26 900 pages distinctes et 6 400 domaines, sur des comptes gratuits comme payants et dans plusieurs pays. Le détail complet de la méthode et des relevés est disponible dans l’étude publiée sur la stack de retrieval de ChatGPT.
Cet index interne porte un nom de code, labrador, et il fonctionne de façon autonome. Le recoupement mesuré avec les vingt premiers résultats de Bing tombe à 1,5 %, ce qui exclut assez nettement l’idée d’une simple redistribution des résultats Bing.
Chaque résultat renvoyé par l’index contient trois éléments : l’adresse de la page, son titre complet sans troncature, et un extrait d’environ 200 caractères ancré sur le contenu du H1. Ce détail a une conséquence directe sur votre travail éditorial. L’extrait ignore la meta description, et il ignore aussi la question posée, ce qui veut dire que le même extrait est servi quelle que soit la requête de départ. Vous ne pouvez donc pas compter sur une adaptation contextuelle comme le fait un snippet Google.
Le robot qui alimente ce store s’identifie sous le nom OAI-SearchBot dans les logs serveur. Un deuxième robot, ChatGPT-User, intervient sur une tout autre couche, et un troisième, GPTBot, est associé à l’entraînement des modèles sans apparaître dans ces deux mécaniques.
Cette distinction en trois robots mérite d’être retenue, parce qu’elle règle une confusion très répandue chez les débutants. Bloquer GPTBot pour refuser l’entraînement des modèles ne vous retire pas de l’index de ChatGPT, puisque ce n’est pas le même robot qui remplit les deux rôles. Beaucoup de sites ont pris cette décision en croyant se rendre invisibles, ou au contraire en craignant de disparaître, alors que les deux mécaniques restent séparées côté OpenAI.
Pour situer l’ordre de grandeur, l’index de ChatGPT observé ici couvre 6 400 domaines sur le corpus analysé, ce qui reste modeste comparé à ce que balaie un moteur classique. La conséquence pratique est plutôt encourageante quand on débute : la concurrence pour y figurer est nettement moins dense que sur Google, et un site jeune n’est pas mécaniquement relégué derrière les gros médias installés. Cette densité varie fortement d’un domaine à l’autre, ce qui explique en bonne partie pourquoi les citations ChatGPT dépendent autant de votre secteur.
Le cache de lecture et sa fenêtre de trente minutes
La deuxième couche est celle que la plupart des articles sur le sujet passent sous silence, alors qu’elle explique beaucoup de comportements observés. Quand ChatGPT ouvre réellement une page, il ne la lit pas à la volée pour chaque conversation. Il la convertit en Markdown et la range dans un cache de lecture.
Ce cache est partagé entre tous les utilisateurs, et la clé d’entrée est simplement l’adresse de la page. Si quelqu’un a déjà fait ouvrir votre article dans les minutes qui précèdent, la version servie à l’utilisateur suivant sort du cache. La fenêtre de fraîcheur observée tourne autour de trente minutes, avec un rafraîchissement en arrière-plan une fois cette fenêtre dépassée. La rétention, elle, s’étale sur bien plus long, avec des cas documentés au-delà de quatre-vingt-dix jours.
Deux limites techniques méritent votre attention. La première concerne le poids : au-delà de quatre mégaoctets, une page n’est pas lue du tout, et le rejet est total plutôt que partiel. La seconde concerne le JavaScript, qui n’est pas exécuté. Tout contenu généré côté navigateur reste donc invisible, ce qui pénalise lourdement les sites qui affichent leur texte principal après chargement.
Concrètement, ces deux contraintes remettent au premier plan des fondamentaux techniques que le discours GEO avait un peu écrasés sous les recettes à la mode. Une page lourde ou rendue en JavaScript sort du jeu avant même d’être évaluée, quelle que soit la qualité de ce qu’elle raconte. C’est la même logique qui rendait déjà les balises structurées moins décisives qu’annoncé, un point que j’avais creusé en regardant si le schema markup est vraiment lu par les IA.
Le partage du cache entre utilisateurs a une autre implication, plus rassurante celle-là. Vous n’avez pas besoin que le modèle vienne relire votre page à chaque conversation pour rester dans la course, puisqu’une seule lecture sert ensuite à tout le monde pendant la fenêtre en cours. En pratique, une mise à jour importante de votre contenu met donc un moment à circuler, ce qui invite à soigner une page au moment de sa publication plutôt qu’à la retoucher en continu.
Un contrôle simple permet de savoir où vous en êtes sans aucun outil payant. Ouvrez les logs d’accès de votre hébergement et cherchez les trois noms cités plus haut. La présence d’OAI-SearchBot indique que vous êtes crawlé pour l’index de ChatGPT, celle de ChatGPT-User que vos pages sont réellement ouvertes et mises en cache. L’absence totale des deux constitue le vrai signal d’alarme, bien avant toute considération sur la qualité éditoriale.
Ce qui sépare une page listée d’une page citée
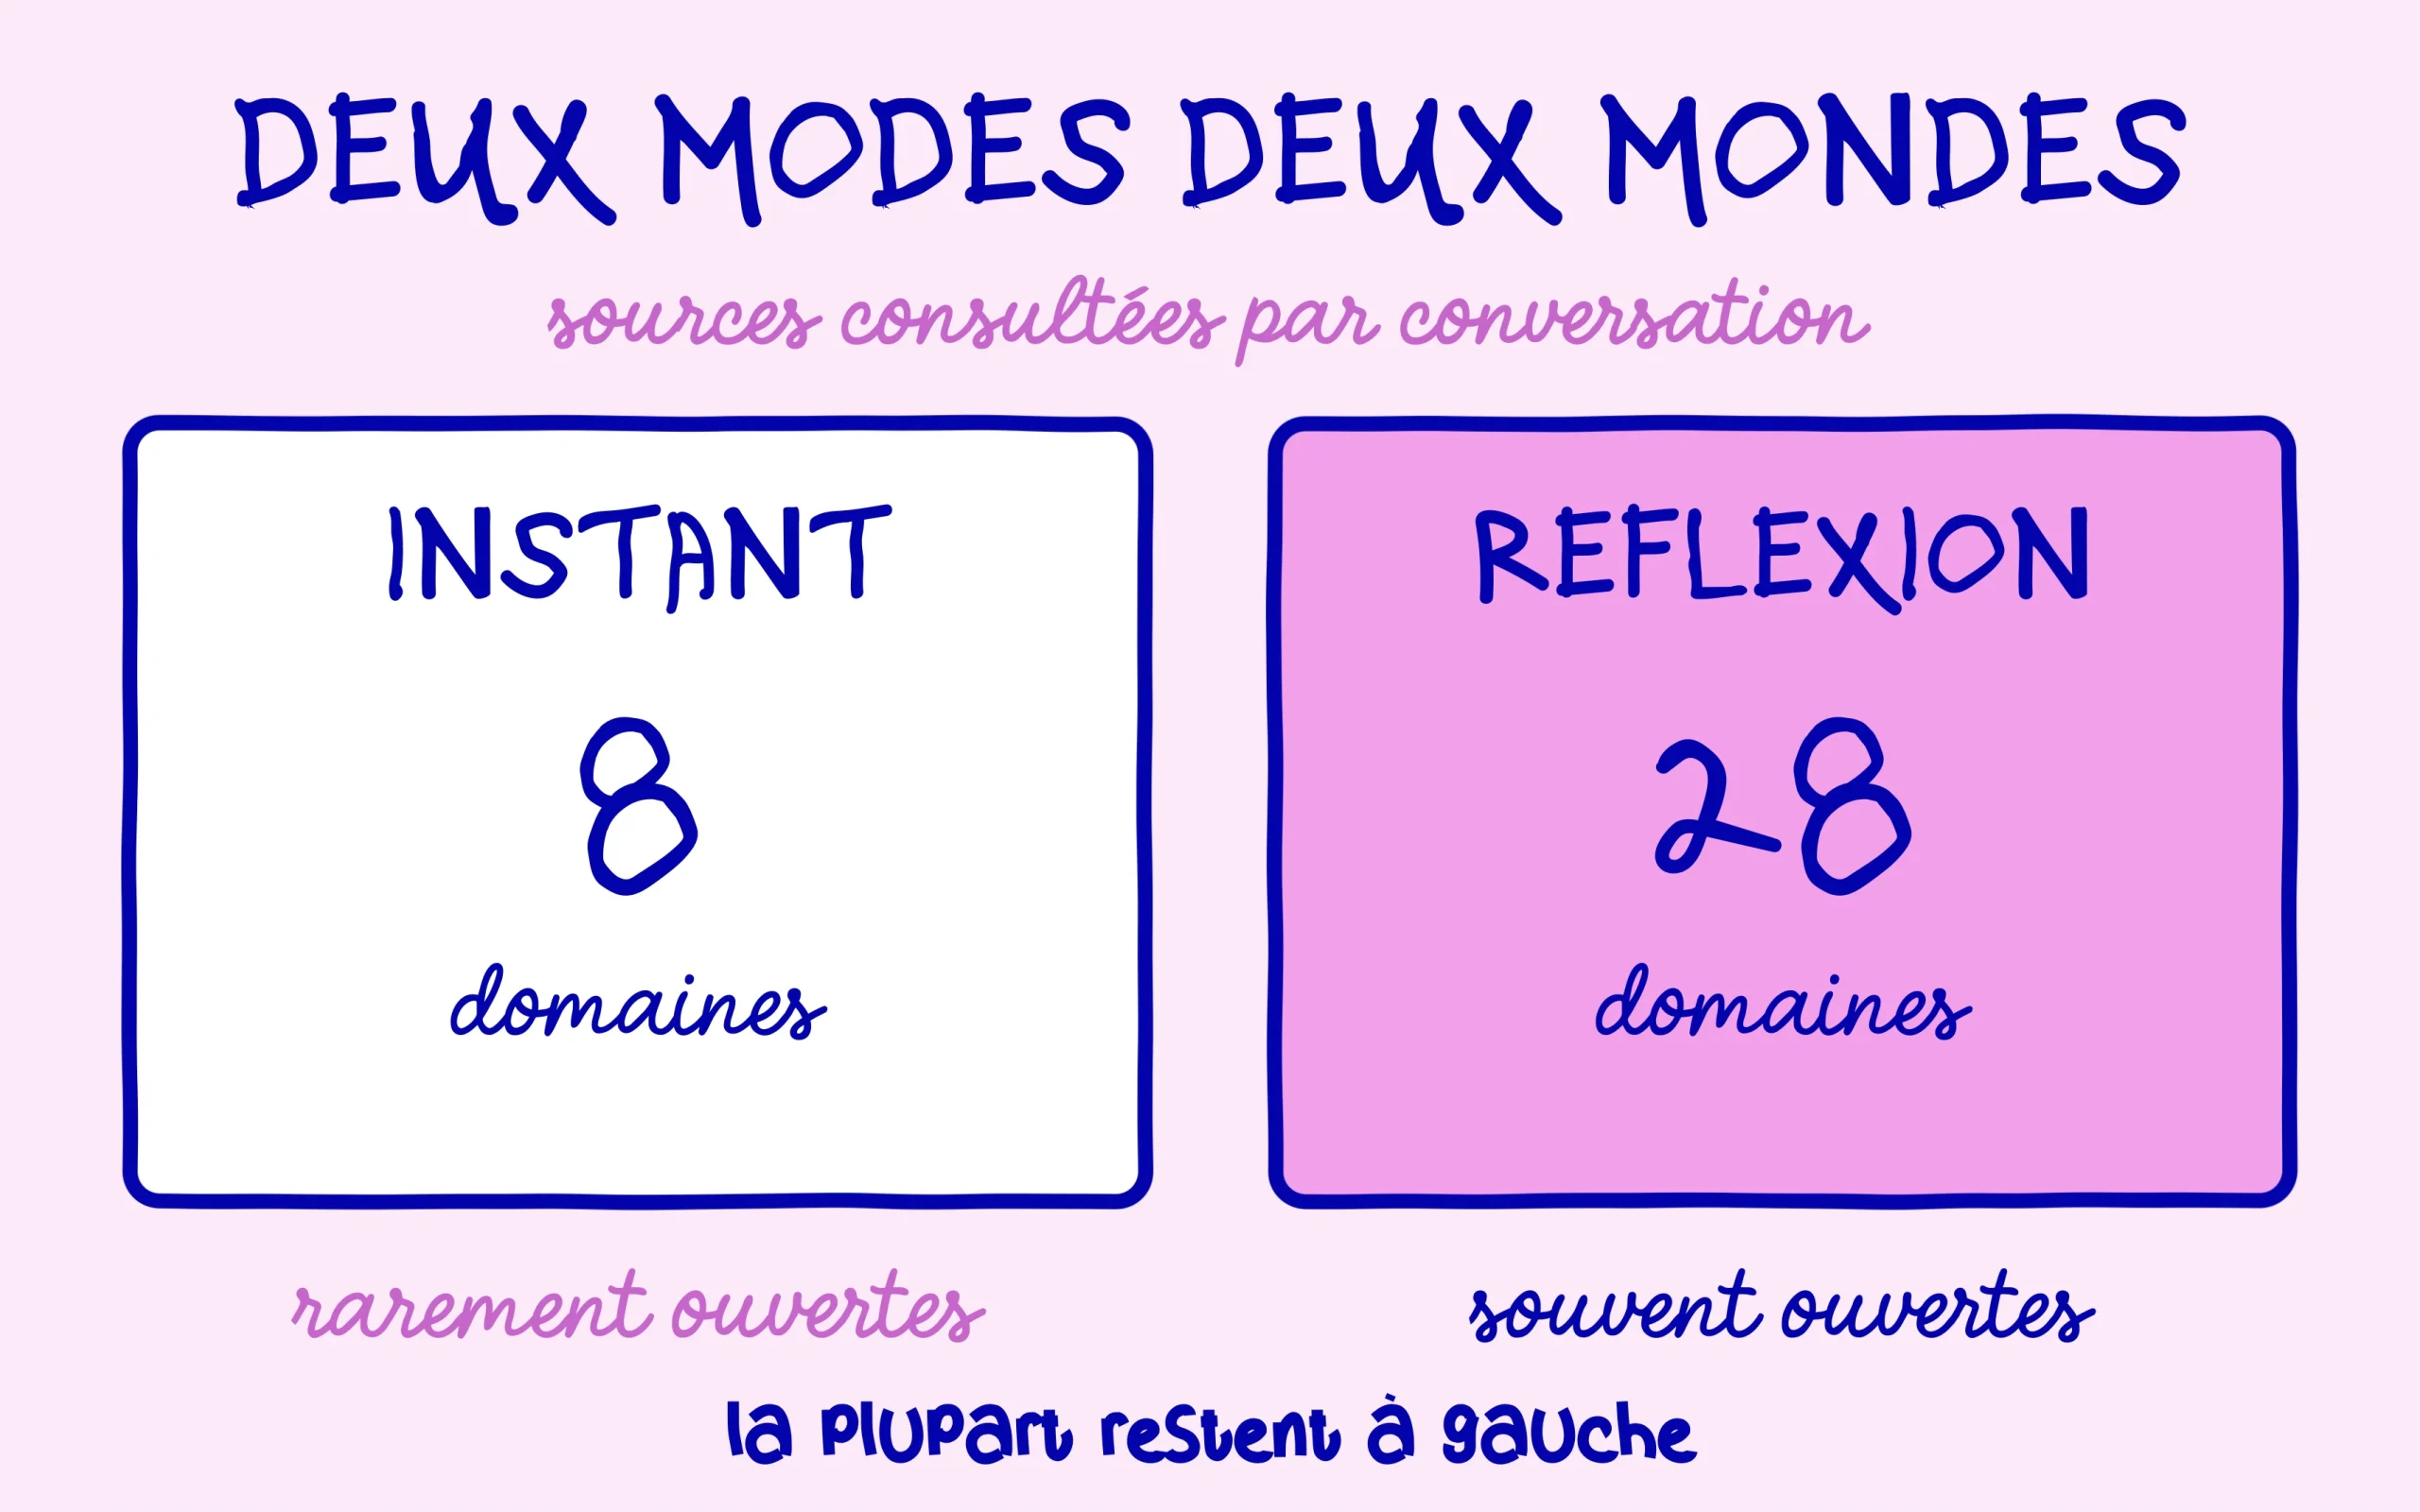
Le chiffre le plus parlant de toute l’étude tient en une comparaison. Une page réellement ouverte par le modèle termine citée dans 74 % des cas. Une page simplement remontée dans les résultats de l’index, sans être ouverte, tombe à 7 %.
L’écart est énorme, et il déplace la question. Être présent dans l’index vous met dans la salle d’attente. Être ouvert vous met à la table. Sauf que l’ouverture dépend surtout du mode utilisé : sur 759 pages ouvertes relevées, 757 provenaient du mode de réflexion, réservé aux comptes payants.
Or plus de 90 % des utilisateurs de ChatGPT restent sur la version gratuite, donc sur le mode instantané qui s’appuie presque uniquement sur l’index. Pour la grande majorité des conversations qui parlent de votre secteur, votre page ne sera jamais ouverte. Ce qui circule, c’est votre titre et votre extrait de 200 caractères.
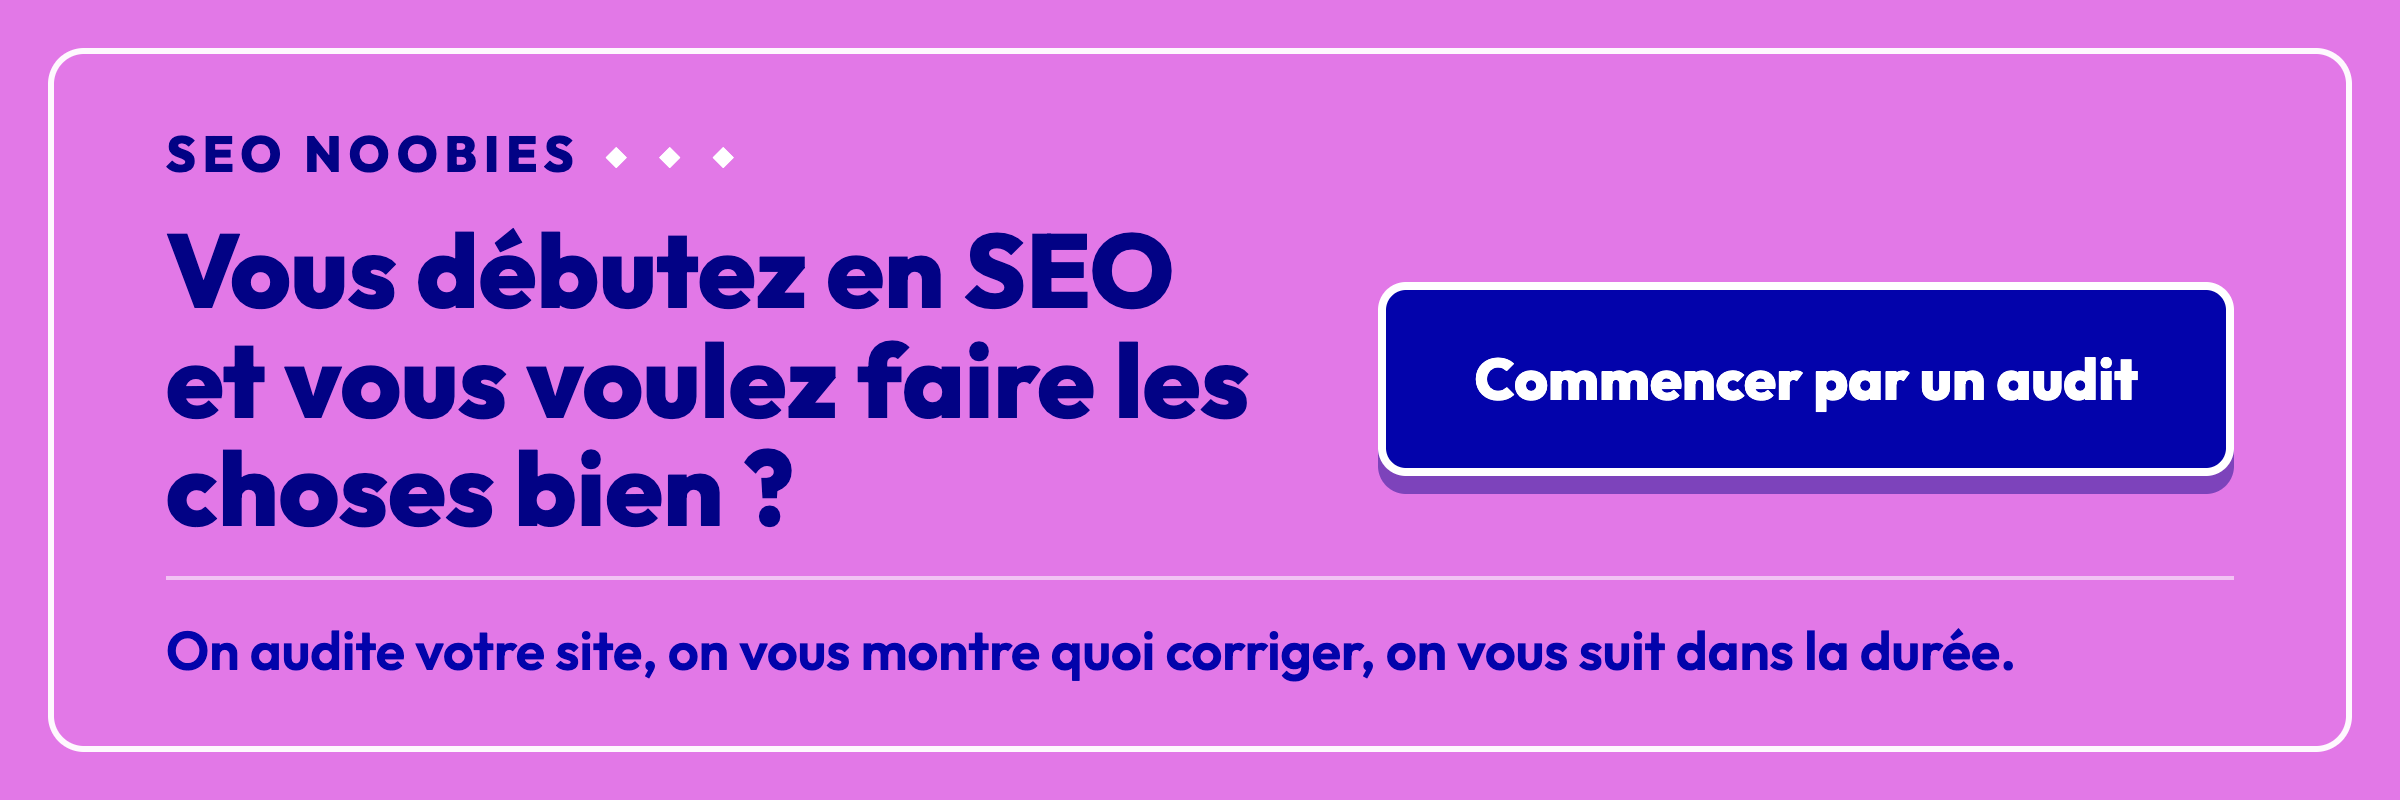
Le nombre de sources consultées suit la même fracture. Le mode instantané s’appuie sur une médiane de huit domaines distincts par conversation, quand le mode de réflexion en mobilise vingt-huit. Le premier laisse donc très peu de places, et il les distribue sur la base du titre et de l’extrait uniquement.
Traduit en action, cela donne une priorité claire sur laquelle un débutant peut travailler dès cette semaine. Reprenez vos dix pages les plus stratégiques et relisez uniquement leur H1 et leur premier paragraphe, en vous demandant si ces deux cents caractères suffisent à comprendre de quoi la page parle et pour qui. Un titre malin mais opaque vous coûte cher dans l’index de ChatGPT, précisément parce qu’aucun contexte de requête ne viendra le compléter.
Ma lecture après cette étude est assez simple à formuler. Le travail utile porte d’abord sur le H1 et les premières lignes, puisque c’est ce qui alimente l’extrait figé qui vous représentera dans la plupart des réponses. Ensuite seulement viennent la profondeur du contenu et la fiabilité, qui pèsent quand une page est ouverte. Les thématiques où peu de sites remplissent correctement ces deux couches laissent donc beaucoup de place aux nouveaux entrants, et c’est une fenêtre qui ne restera pas ouverte éternellement.
Je peux me tromper sur le tempo, et ces mécaniques bougeront probablement dans les mois qui viennent. Cependant, la direction me paraît stable : le modèle privilégie les sources qu’il retrouve régulièrement sur un même terrain plutôt qu’une page isolée bien optimisée, ce qui rejoint ce qu’on observait déjà sur l’autorité thématique et les références que l’IA cite. Bref, publier régulièrement sur un sujet précis reste plus rentable que traquer la dernière astuce technique.
Continuez de progresser sur SEO Noobies.
[…] Le reste des chiffres dessine un entonnoir très serré. Environ 3 554 pages ont été récupérées sur l’ensemble des conversations analysées, et 110 d’entre elles ont fini citées, soit 3,1 %. La position dans le groupe de résultats compte aussi : une page arrivée en première place est citée dans 5,2 % des cas, contre 0,3 % à partir de la sixième. Le même phénomène de tri qu’on observe sur une page de résultats classique se rejoue donc à l’intérieur du raisonnement du modèle, en plus brutal. Si ce mécanisme de sélection vous intéresse, il complète bien ce qu’on avait vu sur la manière dont l’index de ChatGPT choisit les pages qu’il cite. […]
[…] Ce biais recoupe ce qu’on observait déjà sur la sélection des pages : notre article sur la façon dont l’index de ChatGPT retient les pages qu’il cite montrait que le choix se joue sur des signaux de contexte bien avant de se jouer sur le contenu de […]
[…] à partir de ce que ses robots ont réellement lu, comme l’expliquait l’article sur la façon dont l’index de ChatGPT choisit les pages qu’il cite. Une page dont le texte arrive par script peut donc très bien se positionner sur Google et rester […]