Vos pages de tags remplissent le rapport d’indexation de la Search Console avec des dizaines d’URL que vous n’avez jamais écrites : /tag/marketing/, /tag/conseils/, /tag/wordpress/. WordPress les génère automatiquement à chaque étiquette posée sur un article. La plupart n’affichent qu’un seul lien et aucun texte à elles. Google les explore quand même, les met parfois dans son index, et vous vous retrouvez avec un site qui pèse trois fois son poids réel en pages. On va voir comment identifier celles qui posent problème, comment les sortir de l’index proprement, et surtout comment ne pas casser autre chose au passage.
En bref
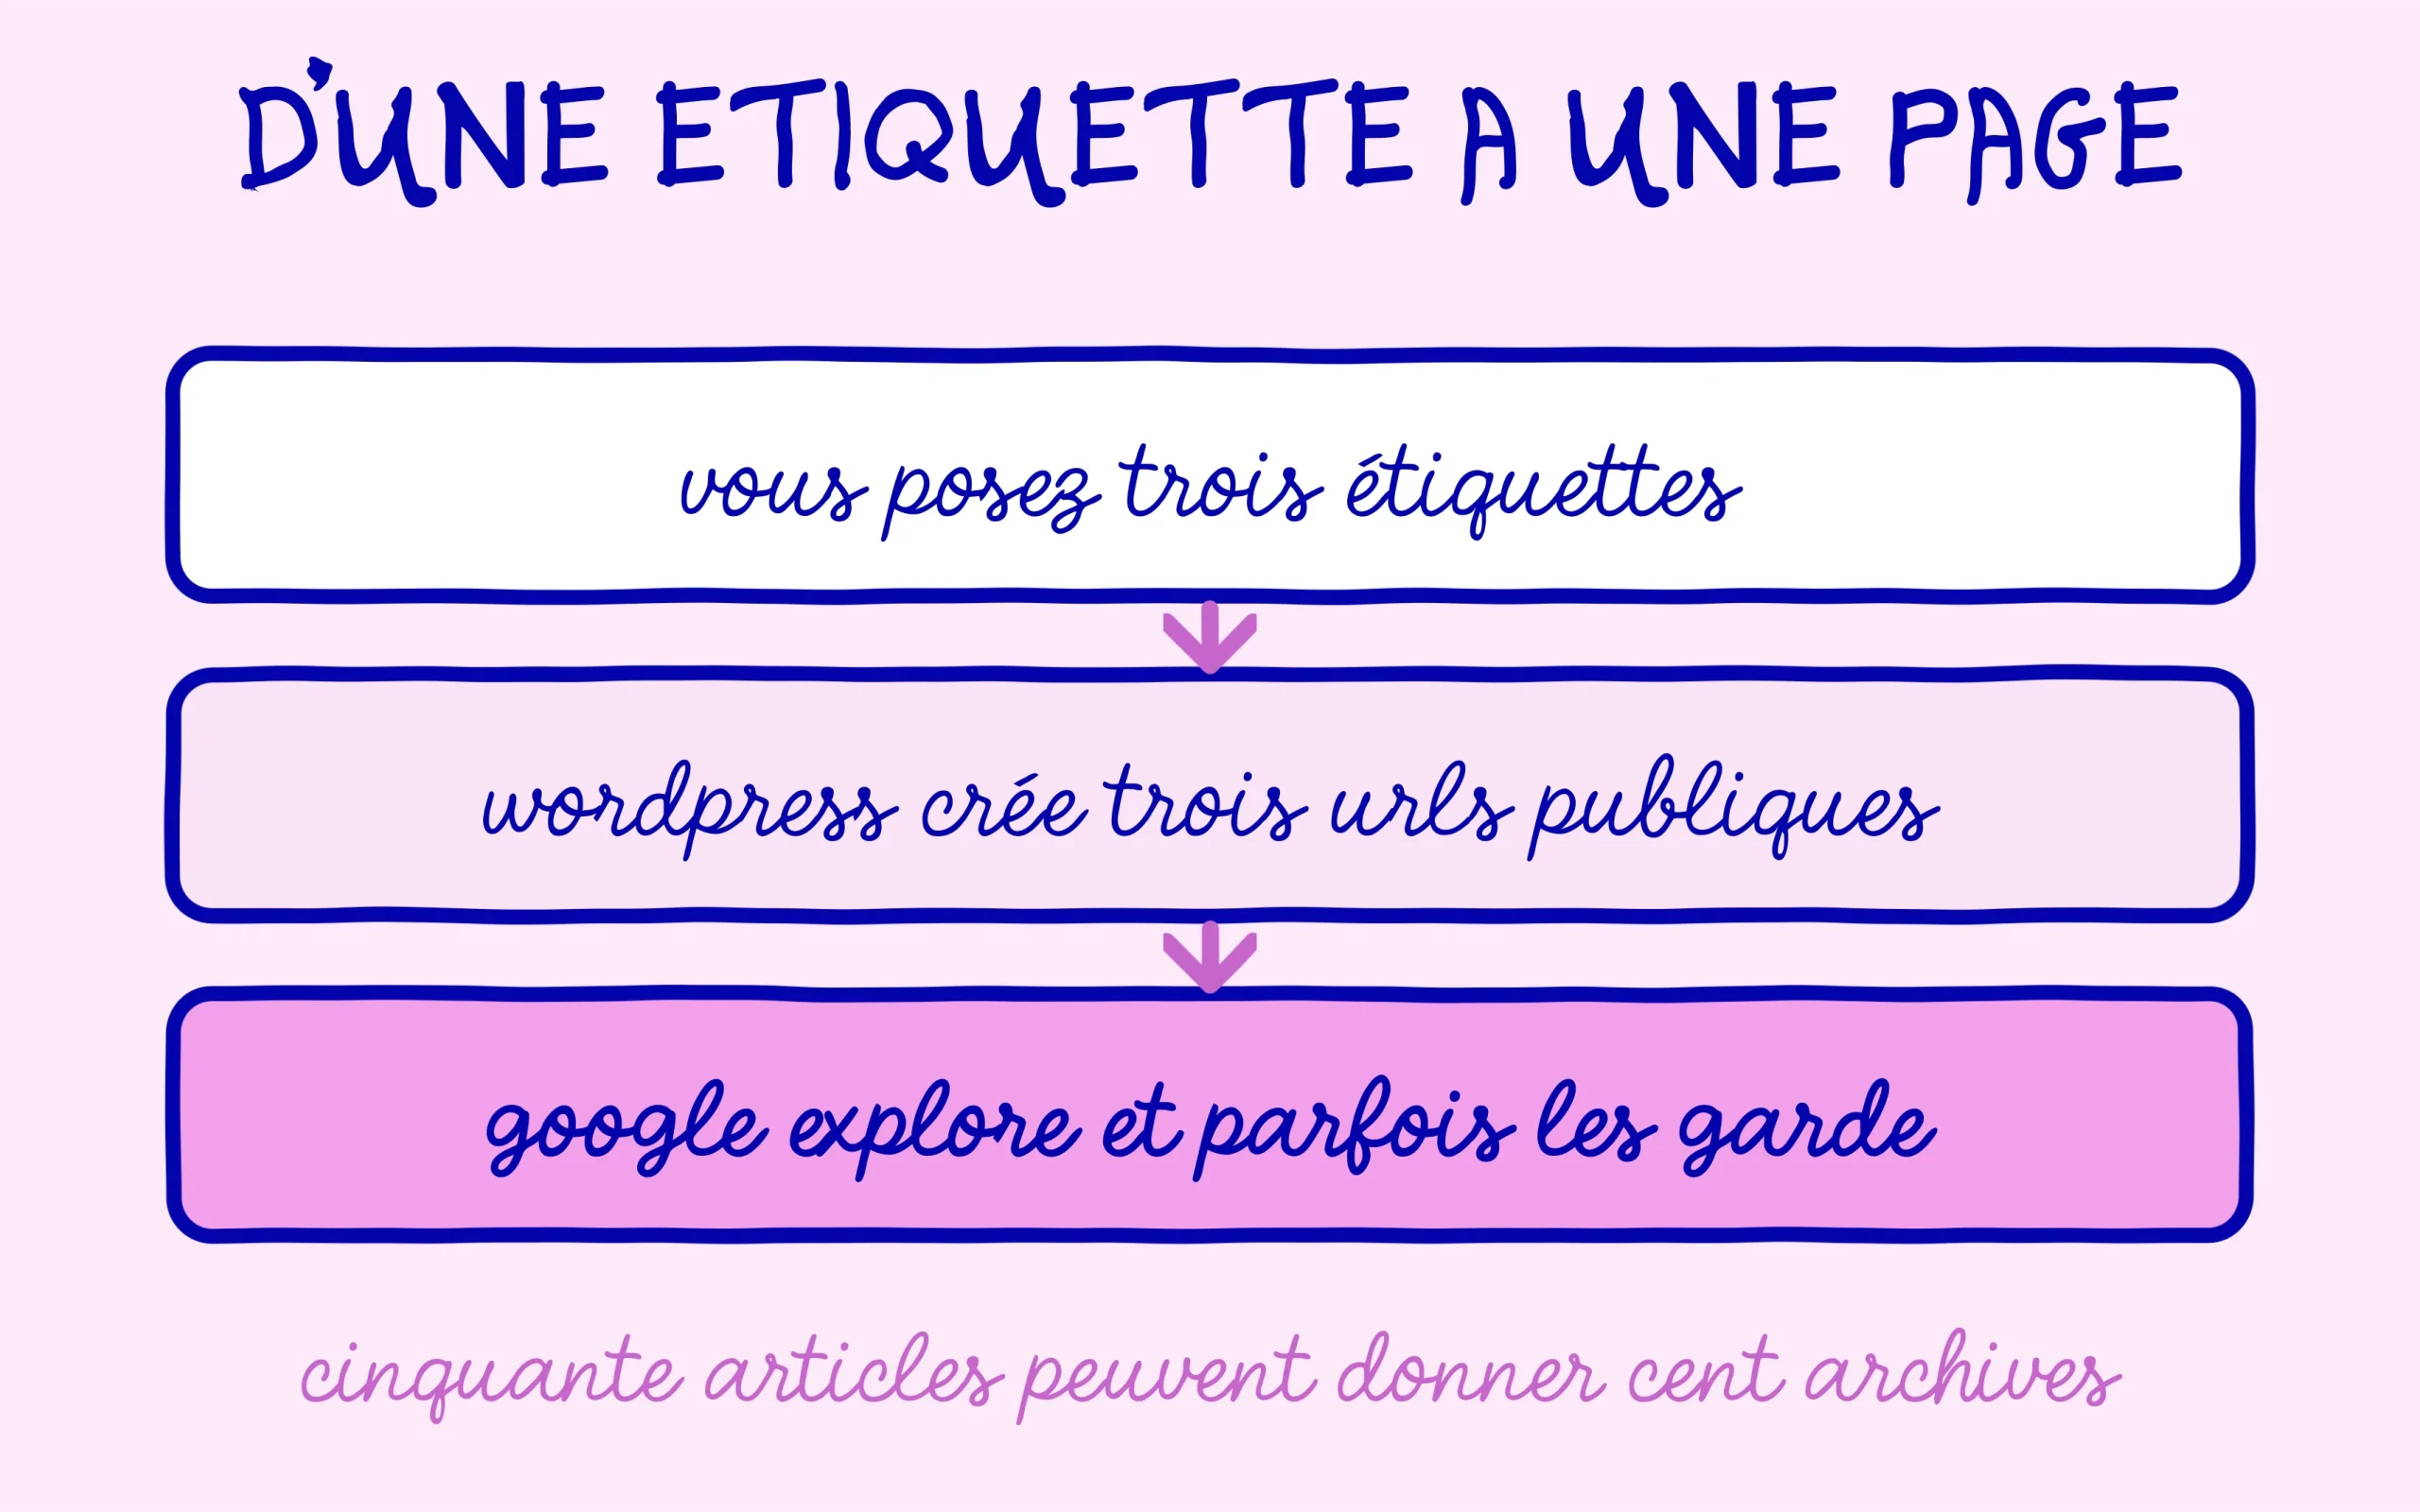
Chaque étiquette posée sur un article crée une page d’archive publique, même si elle ne contient qu’un seul lien.
Ces pages n’ont pas de contenu propre, donc elles diluent le site sans jamais amener de visite utile.
La sortie de l’index se règle en deux clics dans Rank Math ou Yoast, sans toucher au code.
Le noindex ne suffit pas : il faut aussi supprimer les étiquettes inutiles et garder celles qui servent vraiment.
Résumer cet article avec une IA
ChatGPTPourquoi WordPress crée des pages de tags sans vous prévenir
Sur WordPress, une étiquette n’est pas juste un mot-clé de classement interne. C’est une taxonomie, et chaque terme de taxonomie reçoit sa propre URL publique. Écrivez un article, ajoutez les étiquettes « seo », « débutant » et « wordpress », et vous venez de créer trois pages accessibles à n’importe qui, dont le contenu se résume au titre de votre article suivi de son extrait. Répétez l’opération sur cinquante articles avec trois ou quatre étiquettes chacun et vous obtenez facilement cent pages d’archives pour cinquante vrais contenus.
Le problème apparaît quand ces pages entrent dans l’index. Google se retrouve à choisir entre votre article et une archive qui reprend son titre, son extrait et rien d’autre. une page de tag n’a aucun contenu que l’article ne porte déjà, donc elle ne peut que se placer derrière lui, ou pire, à sa place sur une requête où elle n’apporte rien au visiteur. Sur un blog qui tourne depuis deux ou trois ans sans jamais avoir surveillé ce point, il n’est pas rare de découvrir plusieurs centaines d’étiquettes accumulées dont la grande majorité ne rassemble qu’un seul article. Autant de pages explorées pour rien.
Cela dit, toutes les pages de tags ne se valent pas. Un blog cuisine avec une étiquette « sans gluten » qui regroupe quarante recettes tient là une vraie page de navigation, utile au visiteur et légitime dans l’index. La distinction se joue sur le nombre d’articles rassemblés et sur l’existence d’une intention de recherche derrière l’étiquette. Le reste, les étiquettes créées une fois pour un sujet ponctuel, encombre sans rien rapporter. C’est le même raisonnement que pour les pages détectées mais non indexées par Google, à ceci près qu’ici, c’est vous qui décidez.
Une confusion revient souvent chez les débutants, et elle vaut la peine d’être levée tout de suite : les catégories et les étiquettes ne jouent pas le même rôle. Une catégorie sert à ranger, elle structure le site en quelques grandes familles et elle apparaît en général dans le menu. Une étiquette sert à relier des articles qui partagent un détail transversal, sans hiérarchie. En pratique, un site bien tenu porte cinq à dix catégories et devrait porter beaucoup moins d’étiquettes que ce qu’on trouve d’habitude. Quand vous hésitez entre les deux, la question à se poser est simple : est-ce qu’un visiteur irait cliquer là-dessus pour lire trois articles de plus ?
Repérer les pages de tags indexées sur votre site
Première méthode, la plus rapide : tapez dans Google la commande site:votredomaine.fr inurl:tag. La liste qui s’affiche vous donne un ordre de grandeur immédiat de ce que Google connaît de vos archives. ce que Google affiche ne prouve pas ce qu’il a retenu. Si vous voyez apparaître des dizaines d’URL en /tag/, le ménage vaut le coup. Si vous n’en voyez aucune, vos réglages actuels font peut-être déjà le travail, et il suffira de vérifier le point suivant pour en être sûr.
Deuxième méthode, plus fiable : ouvrez la Search Console, allez dans Indexation puis Pages, et parcourez la liste des pages indexées. Vous pouvez filtrer les URL contenant « tag » depuis la barre de recherche du rapport. C’est la source qui fait foi, parce qu’elle vous dit ce que Google a réellement retenu, et pas seulement ce qu’il affiche à un instant donné. Si l’exercice vous semble flou, la marche à suivre complète est détaillée dans notre tutoriel sur la façon de vérifier l’indexation de son site.
Troisième vérification, dans l’administration WordPress cette fois : allez dans Articles puis Étiquettes. La colonne de droite affiche le nombre d’articles par étiquette. Triez dessus. Toutes les étiquettes à zéro ou à un article sont vos candidates à la suppression, pas seulement au noindex. Notez leur nombre avant de commencer, ça donne une idée honnête de l’ampleur du chantier.
Le réglage à basculer dans Rank Math ou dans Yoast
Le réglage se trouve au même endroit dans les deux extensions, à un nom de menu près. Avec Rank Math en version gratuite, ouvrez Rank Math SEO, puis Réglages généraux, puis Apparence dans les résultats de recherche, et enfin l’onglet Taxonomies. Sélectionnez Étiquettes et basculez l’option « Robots Meta » sur noindex. Enregistrez : deux clics suffisent, aucun code n’est nécessaire. Si vous n’avez jamais mis les mains dans ces écrans, notre guide de configuration de Rank Math sur WordPress reprend la navigation pas à pas.
Avec Yoast SEO, le chemin est Yoast SEO, puis Réglages, puis Types de contenu et Taxonomies, section Étiquettes. Le réglage s’appelle « Afficher les étiquettes dans les résultats de recherche » et il faut le passer sur Non. L’extension ajoute alors la balise noindex sur chaque archive d’étiquette et les retire du sitemap au passage, ce qui est exactement ce qu’on veut.
Vérifiez ensuite que le réglage est bien passé. Ouvrez une page de tag de votre site, faites un clic droit puis « Afficher le code source », et cherchez la chaîne noindex. Elle doit apparaître dans une balise meta robots en haut du document. Un point qui piège souvent : certains thèmes posent leur propre balise robots, et vous vous retrouvez avec deux déclarations contradictoires dans le même en-tête. Si c’est le cas, la balise du thème doit sauter, pas celle de l’extension.
Regardez aussi votre sitemap au passage. Les deux extensions listent par défaut les archives d’étiquettes dedans, et laisser une URL en noindex dans un sitemap envoie deux messages opposés au même robot. Rank Math gère ça dans Réglages du sitemap puis Taxonomies, Yoast le fait automatiquement quand vous basculez l’affichage sur Non. Ouvrez ensuite votre sitemap dans le navigateur et cherchez « /tag/ » : plus aucune URL de ce type ne doit y figurer.
Un cas particulier mérite une seconde d’attention. Si une de vos pages de tags reçoit déjà des visites depuis Google, elle apparaîtra dans le rapport Performances de la Search Console. Filtrez les pages sur « /tag/ » avant de tout basculer, et regardez si l’une d’elles ramène des clics réels. Le cas est rare mais il existe, notamment sur les blogs anciens où une étiquette bien remplie a fini par se positionner. Dans ce cas, gardez-la indexée et ajoutez-lui un vrai paragraphe d’introduction, ce qui la transforme en page de navigation légitime.
Ce que le noindex ne règle pas tout seul
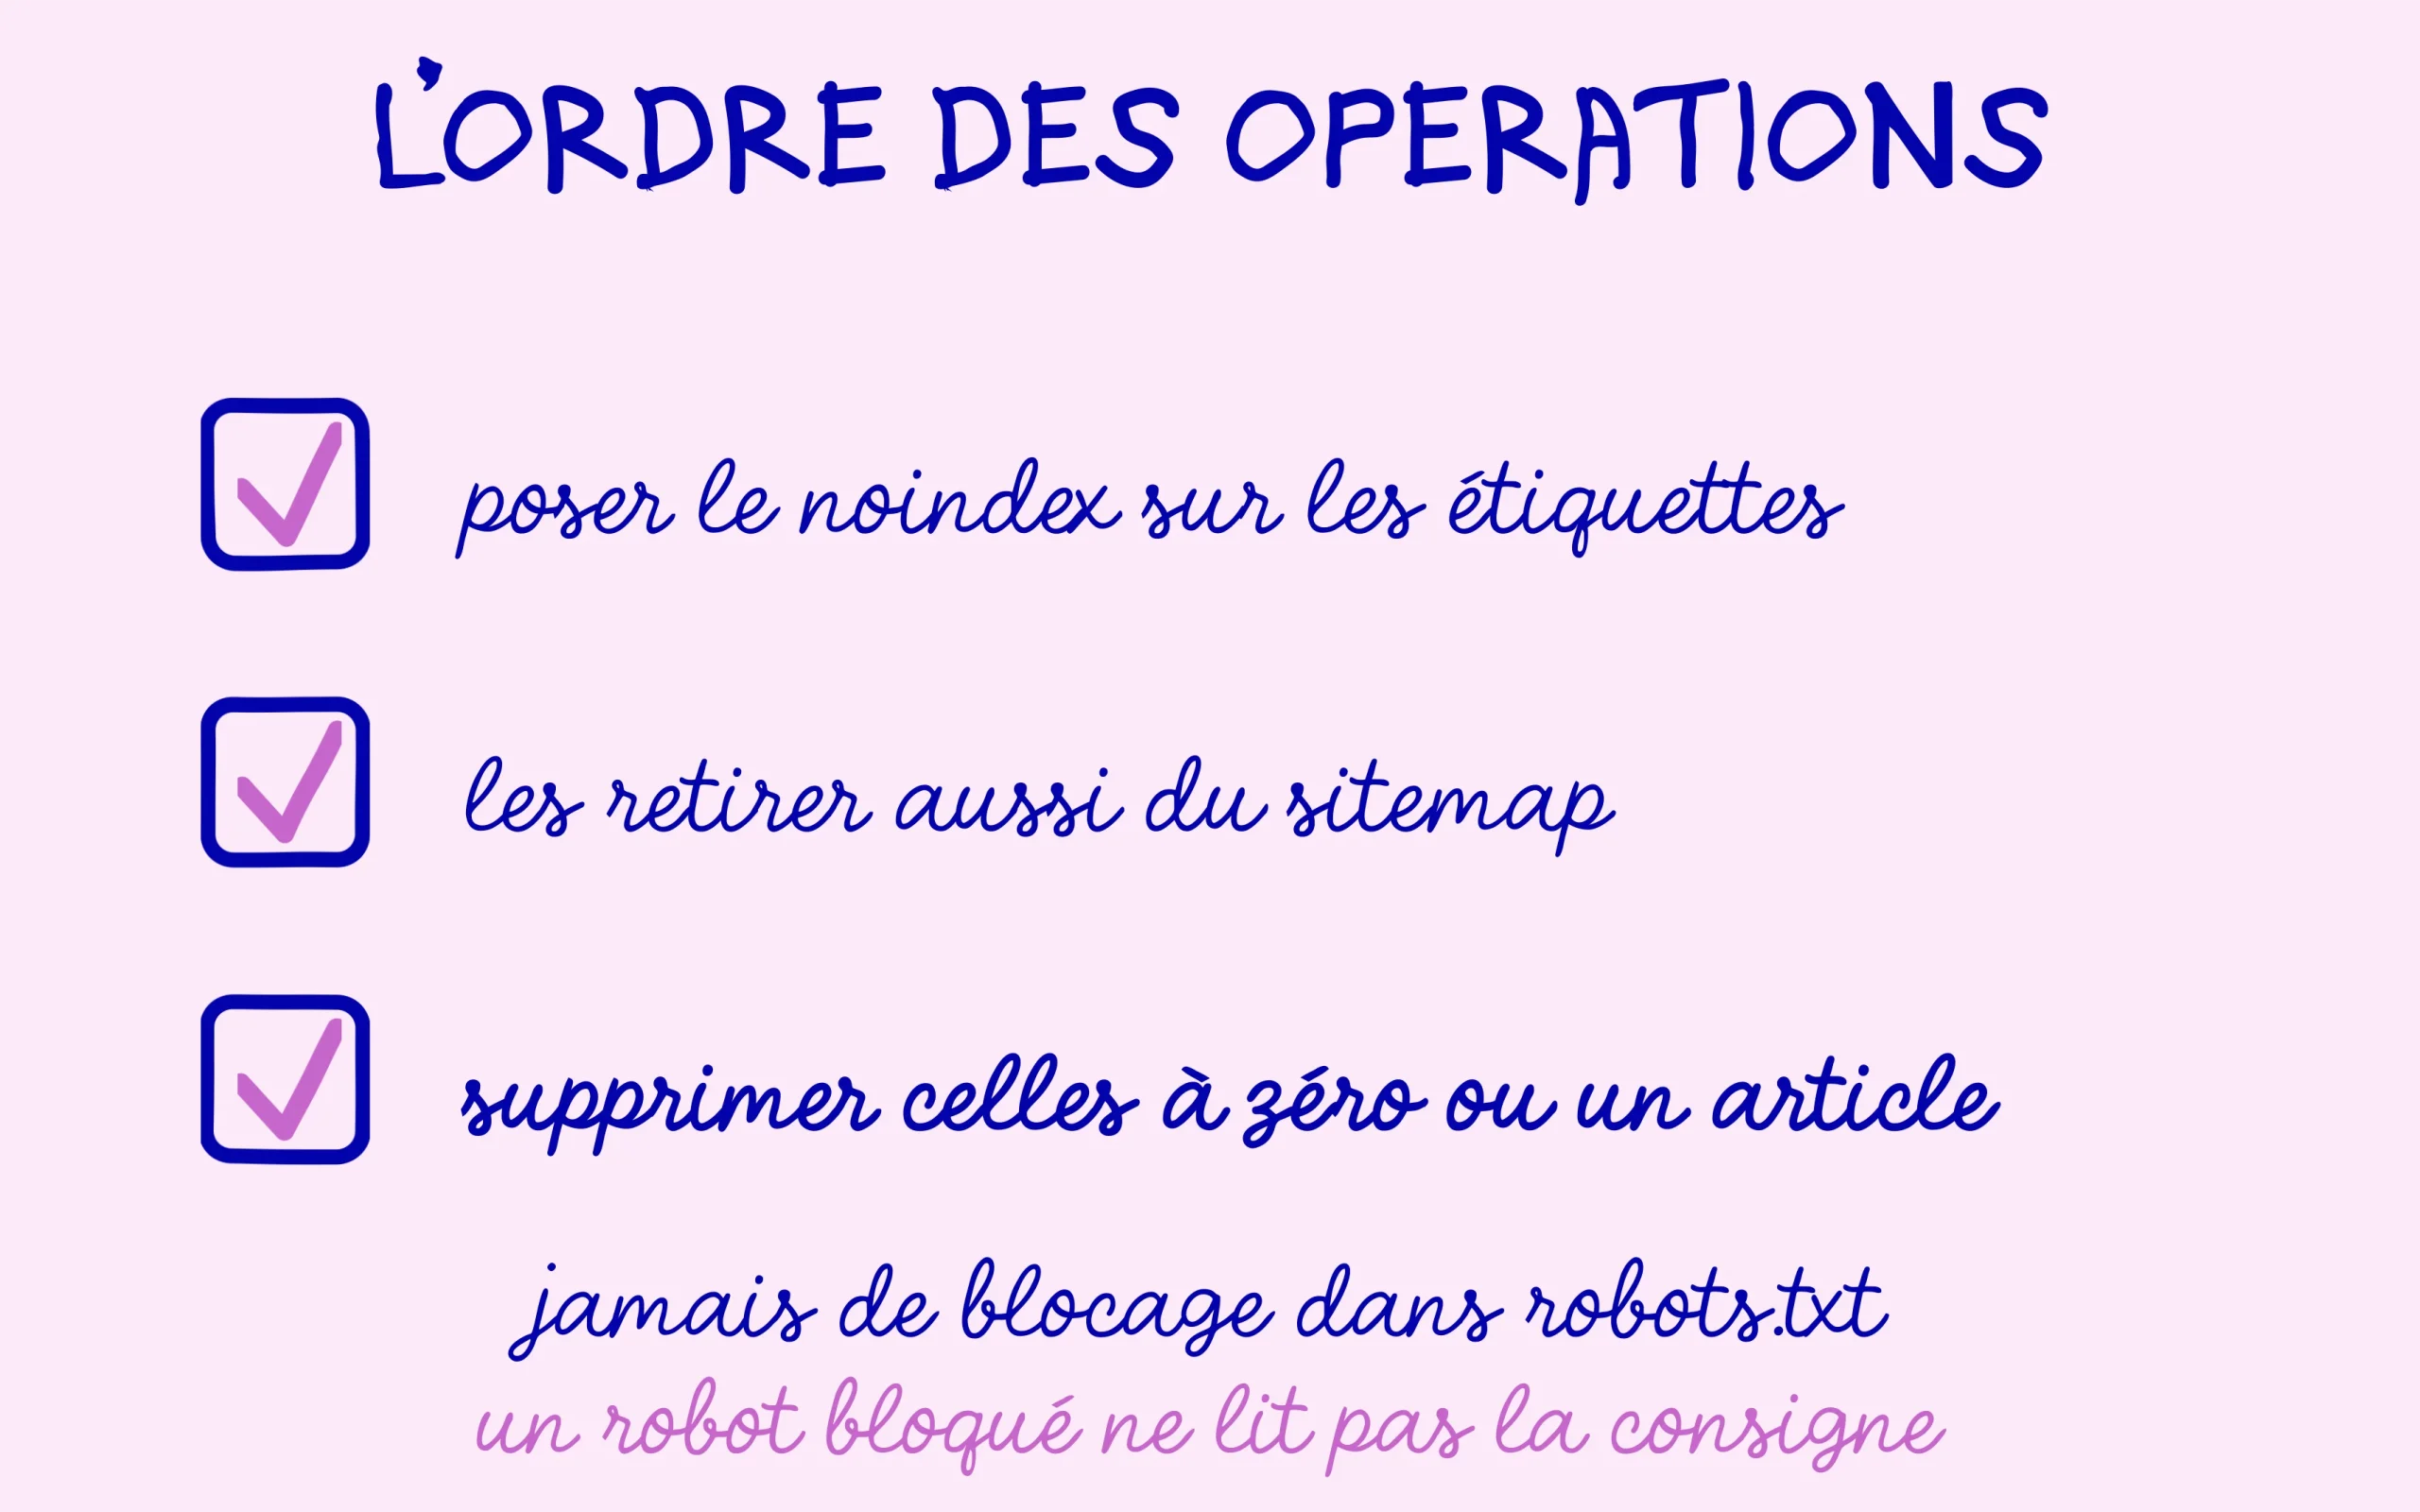
Mettre une page en noindex demande à Google de la retirer de l’index, mais il faut d’abord qu’il repasse dessus pour lire l’instruction. Sur un petit site, comptez plusieurs semaines avant de voir les compteurs bouger dans la Search Console. Ne bloquez surtout pas /tag/ dans le fichier robots.txt en pensant accélérer les choses : un robot bloqué ne peut pas lire la balise noindex, donc la page reste dans l’index, parfois pendant des mois, sans son contenu. C’est l’erreur la plus fréquente sur ce sujet, et un robot bloqué ne peut pas lire la consigne qu’on lui adresse.
Ensuite vient le vrai ménage. Retournez dans Articles puis Étiquettes, et supprimez celles qui ne portent aucun article ou un seul. Supprimer une étiquette ne supprime jamais l’article correspondant, la manipulation est sans risque. Regroupez aussi les doublons évidents, du type « seo », « SEO » et « référencement seo », qui créent trois archives pour le même sujet. Une étiquette conservée doit rassembler assez d’articles pour former une vraie liste de lecture.
Une précaution avant de supprimer en masse : si une étiquette apparaît dans un lien posé à l’intérieur d’un de vos articles, la supprimer laissera un lien mort. Passez donc une recherche sur « /tag/ » dans le contenu de vos articles avant le grand ménage, la fonction de recherche de l’administration WordPress suffit. Ce cas reste rare, la plupart des liens vers les étiquettes venant du thème lui-même, mais il vaut mieux le vérifier que le découvrir dans un rapport d’erreurs trois mois plus tard.
Enfin, prenez l’habitude de limiter les étiquettes à la création d’un article. Trois à cinq suffisent, et l’étiquette neuve ne se justifie que si elle servira plusieurs fois. Une étiquette créée pour un sujet unique produit mécaniquement une page vide de plus. Le réflexe coûte deux secondes au moment de publier et évite de refaire ce nettoyage dans un an.
Un mot sur ce que vous allez voir dans la Search Console après l’opération, parce que la lecture surprend souvent. Le nombre de pages non indexées va augmenter, et la catégorie « Exclue par la balise noindex » va se remplir. C’est le résultat attendu, pas un problème. Le chiffre à suivre est celui des pages indexées : il doit se rapprocher du nombre réel d’articles et de pages que vous avez écrits. Un écart qui se réduit sur deux ou trois mois signifie que le ménage a produit son effet.
Et du côté des moteurs génératifs
La question se pose aussi pour ChatGPT, Perplexity ou les AI Overviews de Google, qui explorent le web avec leurs propres robots. Une page d’archive qui répète un titre et un extrait ne leur donne rien à citer, parce qu’ils cherchent un passage qui répond à une question, pas une liste de liens. Un tag laissé dans l’index ne va pas vous faire citer par erreur : il occupe du budget d’exploration que vos vraies pages n’auront pas.
Ce que ça change en pratique : la page à soigner reste l’article, et l’archive d’étiquette ne mérite d’exister que si un humain a une raison de la parcourir. Vous pouvez d’ailleurs faire le test vous-même, il prend une minute et ne demande aucun outil. Ouvrez une de vos pages de tags, lisez-la comme si vous découvriez le site pour la première fois, et demandez-vous honnêtement ce qu’elle vous apprend. Si la réponse tient en un haussement d’épaules, elle n’a pas sa place dans l’index de Google.
Continuez de progresser sur SEO Noobies.
Cet article contient un lien affilié. Cela ne change rien pour vous, cela nous aide à maintenir le site gratuit.