Le bot ChatGPT qui va chercher une page quand quelqu’un pose une question à l’assistant ne suit pas forcément votre fichier robots.txt. La documentation officielle d’OpenAI l’écrit noir sur blanc, dans une formulation qui ne laisse pas beaucoup de place au doute. La raison tient en une phrase : la visite est déclenchée par une personne réelle, donc elle n’est pas traitée comme le passage d’un robot automatique. Beaucoup de sites ont pourtant ajouté des règles de blocage en pensant fermer complètement la porte aux IA génératives. Voilà ce que le texte dit exactement, ce que ça change quand on gère un petit site, et les réglages qui restent utiles malgré tout.
En bref
OpenAI documente quatre robots distincts, et le bot ChatGPT qui récupère une page à la demande d’un utilisateur est le seul qui échappe partiellement aux règles de robots.txt.
La documentation précise que ces visites étant déclenchées par une personne, les règles du fichier peuvent ne pas s’appliquer.
Bloquer ce robot ne retire pas votre site de la recherche ChatGPT, et l’autoriser ne garantit pas d’y être cité.
Le réglage qui compte vraiment porte sur OAI-SearchBot, le robot qui décide de votre présence dans les résultats.
Résumer cet article avec une IA
ChatGPTCe que dit la documentation d’OpenAI sur le bot ChatGPT
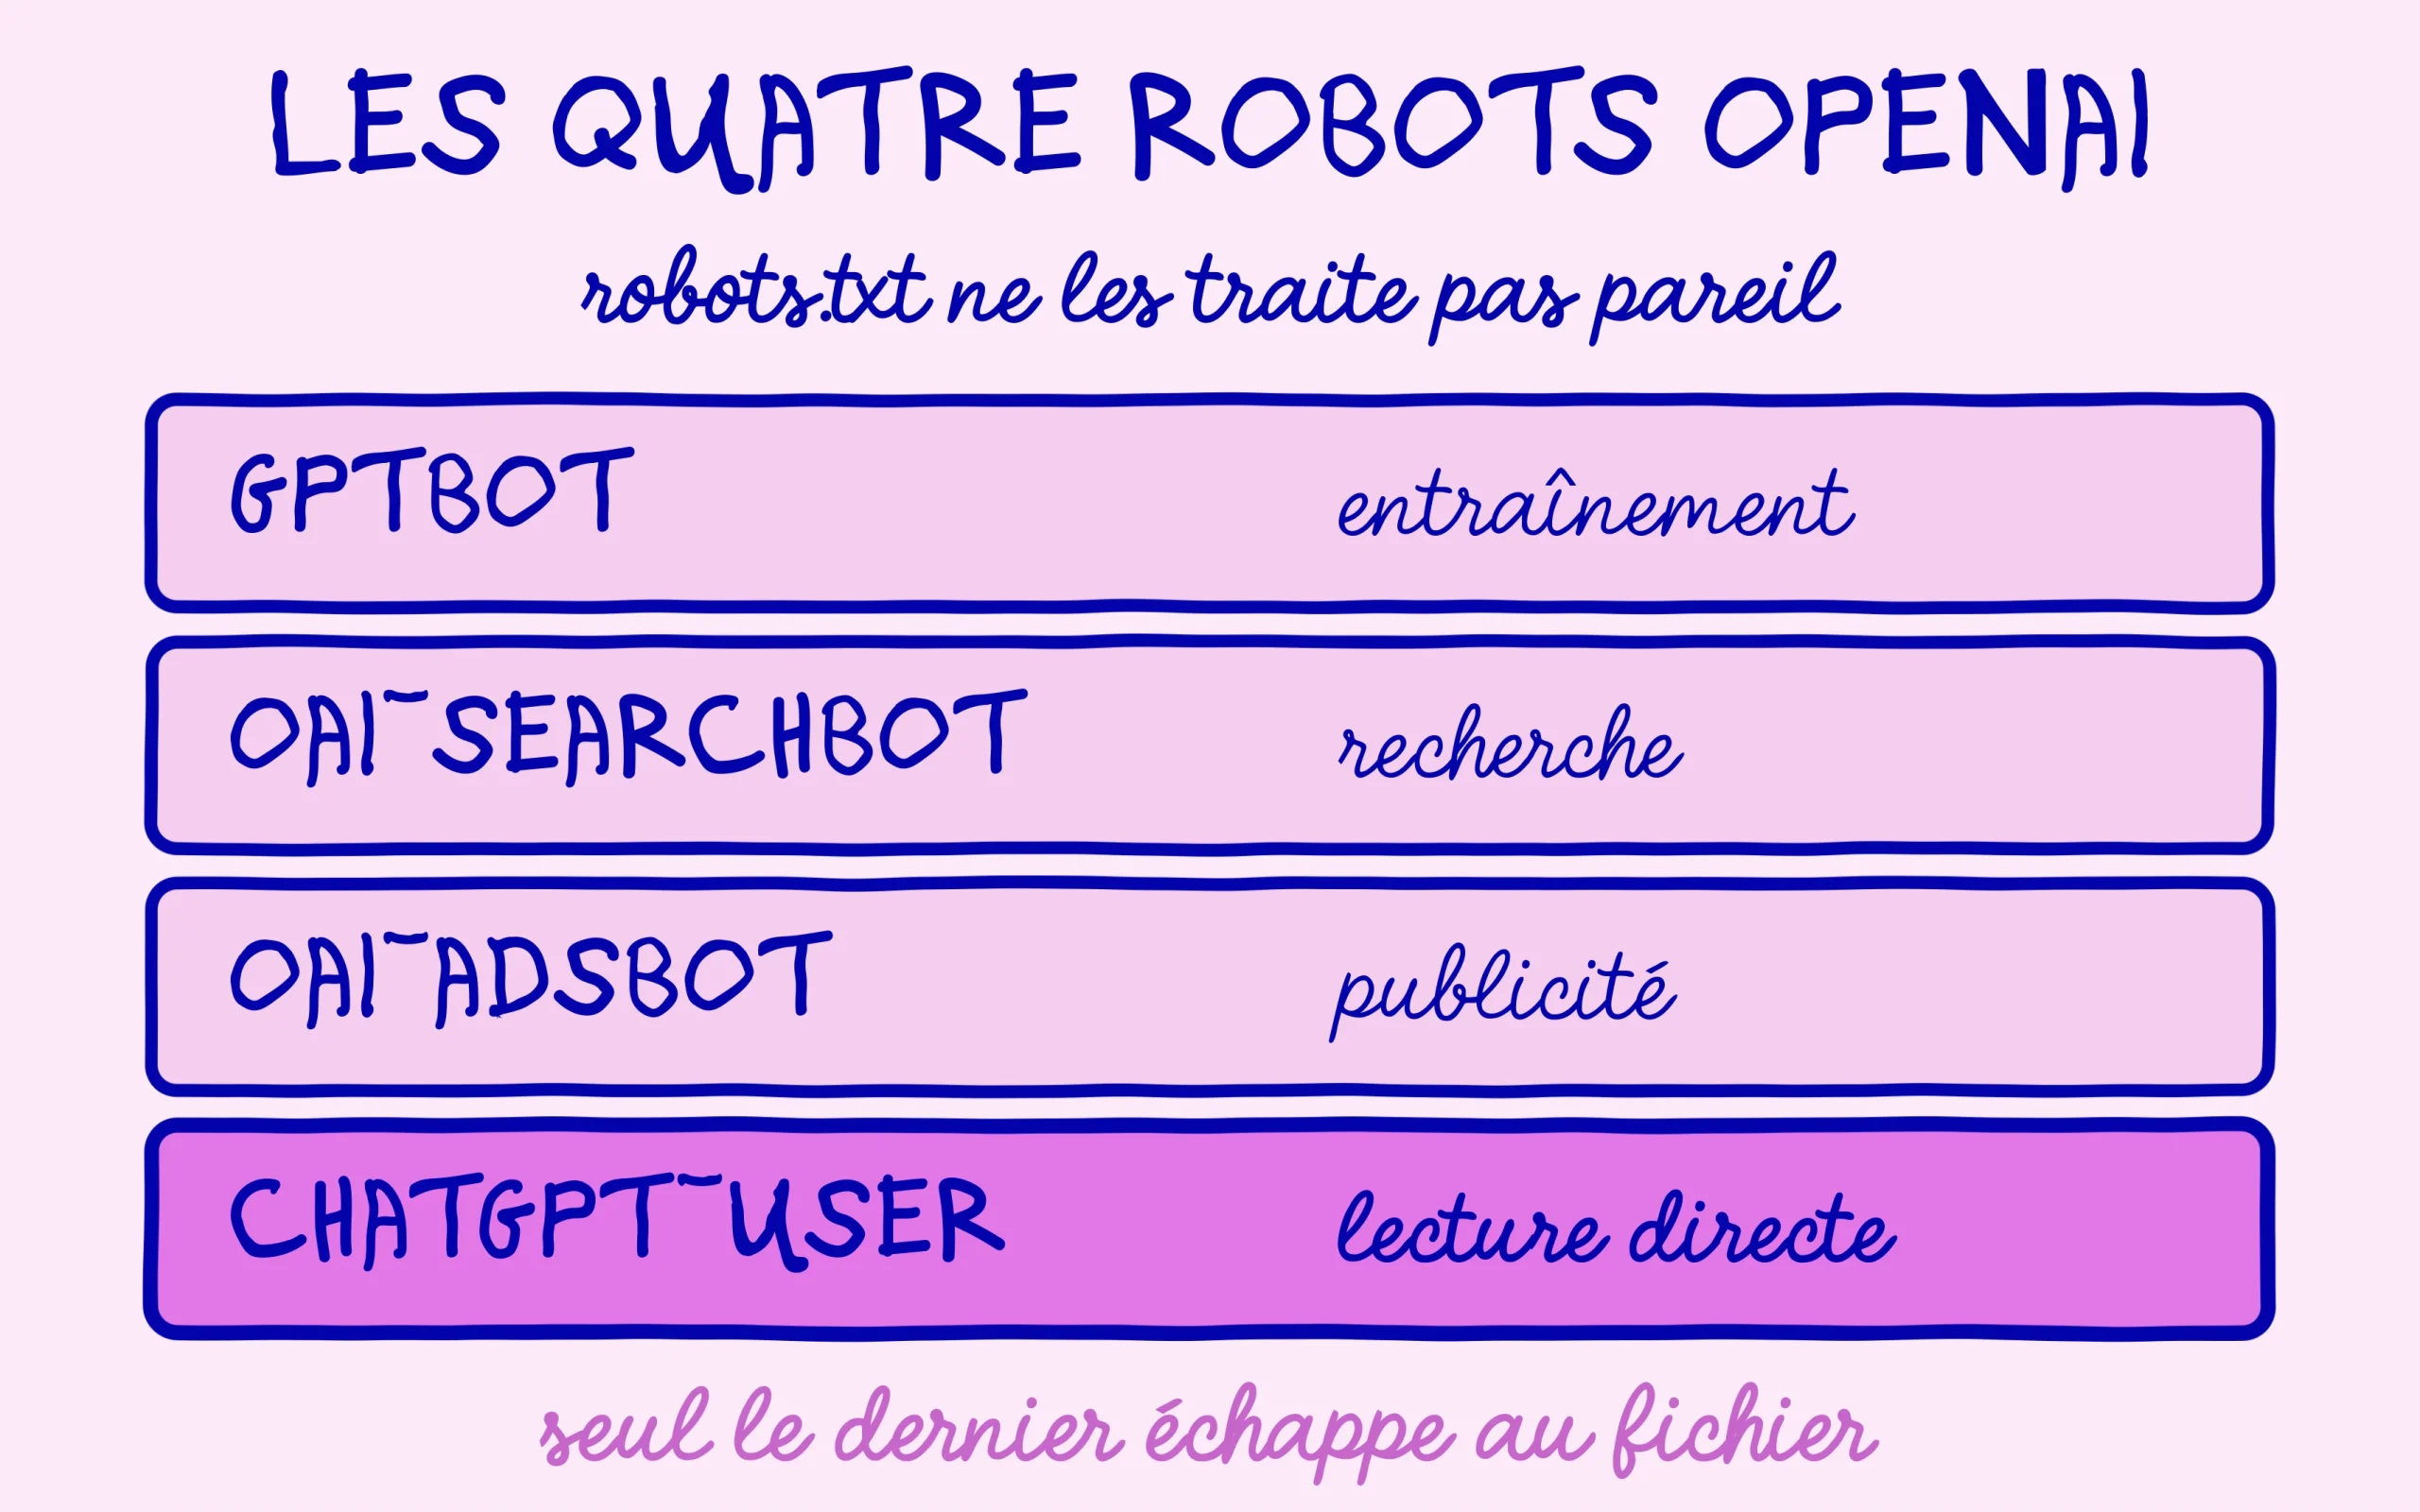
OpenAI documente quatre robots différents, et les confondre est l’erreur la plus fréquente quand on découvre le sujet. GPTBot collecte de la matière pour l’entraînement des modèles. OAI-SearchBot alimente l’index de recherche qui décide si votre site peut apparaître dans les réponses. OAI-AdsBot travaille sur la partie publicitaire. Et le bot ChatGPT, nommé ChatGPT-User dans le fichier, va chercher une page précise au moment où un utilisateur pose sa question.
Un point mérite d’être clarifié avant d’aller plus loin, parce qu’il revient tout le temps. Un fichier robots.txt gère l’accès à une page, pas son affichage dans un moteur. C’est exactement la confusion démontée dans notre article sur le fait que bloquer une page dans robots.txt ne remplace pas la balise noindex. La même logique s’applique ici, avec une couche supplémentaire de complexité côté IA.
La phrase qui pose problème est courte. Le texte indique que ces actions étant déclenchées par un utilisateur, les règles de robots.txt peuvent ne pas s’appliquer. Il ajoute que ce robot ne sert pas à déterminer si un contenu peut apparaître dans la recherche, et renvoie vers OAI-SearchBot pour tout ce qui touche à l’exclusion des résultats. Le fichier reste lu, mais il n’a pas le dernier mot sur cette visite précise, ce qui est très différent d’une garantie de blocage.
Cette formulation figure dans la page officielle qui décrit le comportement des robots OpenAI et leur rapport à robots.txt. Elle vaut la peine d’être lue en entier, ne serait-ce que pour voir que chaque robot y reçoit une recommandation différente et parfois opposée.
Pourquoi une visite déclenchée par un utilisateur change les règles
Reste à comprendre le raisonnement derrière cette exception, parce qu’il n’est pas arbitraire. Le protocole d’exclusion des robots a été pensé pour encadrer des programmes qui parcourent le web en continu, sans intention particulière, et qui coûtent de la bande passante aux serveurs. Une personne qui colle une adresse dans ChatGPT et demande un résumé se trouve dans une autre situation. Elle agit comme quelqu’un qui ouvre un navigateur, sauf que le rendu passe par un intermédiaire.
Cette lecture n’est pas propre à OpenAI. Plusieurs acteurs du secteur appliquent la même distinction entre un robot d’exploration systématique et un agent qui répond à une demande ponctuelle. Le débat porte moins sur la légitimité du principe que sur son périmètre, puisque rien n’empêche techniquement d’appeler « déclenché par un utilisateur » un volume de requêtes considérable.
Côté hébergement, la question est déjà sortie du cadre théorique. Nous avions détaillé le cas où une règle de blocage des IA posée via Cloudflare finissait aussi par gêner Googlebot, avec des conséquences bien réelles sur l’indexation classique. Le sujet du filtrage des robots déborde largement le fichier texte posé à la racine du site.
Autant le dire clairement, robots.txt n’a jamais été un pare-feu. C’est une convention que les acteurs sérieux respectent parce qu’ils y ont intérêt, et que les autres ignorent sans conséquence. La nouveauté tient à ce qu’un acteur majeur documente publiquement une catégorie de visites où il se réserve de ne pas appliquer la règle.
Une conséquence pratique en découle, et elle surprend souvent. Le bot ChatGPT ne laisse pas les mêmes traces qu’un robot d’exploration classique dans vos journaux serveur. Là où GPTBot passe par vagues régulières sur des dizaines d’adresses, une visite déclenchée par un utilisateur touche une seule page, une seule fois, au moment où quelqu’un pose sa question. Repérer ce comportement dans les statistiques demande donc de chercher un pic isolé plutôt qu’un balayage, ce qui explique pourquoi beaucoup de sites ne l’ont jamais vu passer.
Ce qu’un petit site peut faire à partir d’aujourd’hui
Concrètement, la première chose à faire est d’ouvrir votre robots.txt et de regarder quels noms y figurent vraiment. Un site qui a copié une liste trouvée sur un forum bloque souvent GPTBot et ChatGPT-User tout en laissant OAI-SearchBot passer, ou fait exactement l’inverse sans le savoir. Ces deux réglages produisent des résultats opposés, l’un touchant l’entraînement et la lecture à la demande, l’autre votre présence dans les réponses.
Ensuite vient la question de fond : que cherchez-vous à obtenir ? Un site qui vit de son audience et veut être cité par les assistants a intérêt à laisser passer le robot de recherche, quitte à accepter que des pages soient lues à la demande par le bot ChatGPT. Un site qui vend un contenu payant raisonne autrement et se protège au niveau du serveur, pas d’un fichier consultatif. Une décision claire vaut mieux qu’une liste de blocage recopiée dont on ne mesure pas les effets.
Pour ceux qui visent la citation, le travail utile porte ailleurs. Les critères qui pèsent réellement sur la sélection des pages sont détaillés dans notre analyse de la façon dont l’index de ChatGPT choisit les pages qu’il cite, et ils ressemblent beaucoup à du bon SEO classique : lisibilité, fraîcheur, réponse directe à une question posée.
Il reste une option que peu de gens envisagent, alors qu’elle est souvent la bonne : ne rien bloquer du tout. Un site de contenu qui cherche de la visibilité n’a aucun intérêt à fermer la porte au bot ChatGPT, puisque chaque page lue est une page susceptible d’être résumée avec un lien vers vous. Le blocage se justifie quand vous vendez l’accès à ce contenu, ou quand la charge serveur devient un vrai coût. En dehors de ces deux cas, la ligne de blocage recopiée vous prive d’un canal sans rien vous rapporter en échange.
Un dernier point de prudence sur l’interprétation de tout ça. La documentation dit que les règles peuvent ne pas s’appliquer, pas qu’elles sont systématiquement ignorées. La nuance compte, et elle interdit de conclure que le fichier ne sert plus à rien. Il continue de porter les instructions destinées aux autres robots, qui restent l’immense majorité du trafic automatisé sur un petit site.
Rien de tout ça n’appelle une refonte en urgence. Vérifier ce que contient votre fichier, comprendre à quel robot correspond chaque ligne, et décider consciemment ce que vous laissez entrer suffit largement pour aujourd’hui. Le reste dépendra de la façon dont ces règles évoluent, et elles évoluent vite.
Continuez de progresser sur SEO Noobies.
[…] Ce jeu de jetons ne concerne pas non plus les robots conversationnels qui vont chercher une page en direct pendant une question posée par un utilisateur. Ceux-là obéissent à leurs propres noms dans le robots.txt, et les confondre avec les robots d’entraînement reste l’erreur la plus fréquente. Nous avions détaillé ce piège à propos du robot de ChatGPT à ne pas bloquer par erreur dans le robots.txt. […]
[…] Le même raisonnement circule chez d’autres acteurs : SEO Noobies avait déjà montré que le robot de ChatGPT lit des pages que votre robots.txt bloque quand un utilisateur le lui demande. L’agent IA qui agit pour une personne se place dans une […]