Refuser que vos pages servent à l’entraînement IA sans disparaître de Google, c’était jusqu’ici un choix impossible pour les sites protégés par Cloudflare. Les mêmes robots explorent le web pour la recherche et pour nourrir des modèles, donc bloquer l’un revenait à bloquer l’autre. Le 15 septembre 2026, Cloudflare a publié un nouveau réglage qui sépare enfin les deux usages chez Google et chez Apple, et qui remplace automatiquement les anciennes options de blocage. Pour un site qui a coché une case de protection ces derniers mois, c’est plutôt une bonne nouvelle. Encore faut-il comprendre ce que le réglage fait vraiment, ce qu’il laisse de côté, et ce qu’il reste à contrôler sur votre domaine.
En bref
Cloudflare lance le réglage Disallow AI Training, qui publie un refus d’entraînement dans votre fichier robots.txt tout en laissant Googlebot, Applebot et Bingbot explorer pour la recherche.
Les sites qui avaient choisi Block ou Block on pages with ads sont basculés automatiquement sur ce nouveau réglage.
Chez Google, le refus passe par le jeton Google-Extended, que Google décrit comme sans effet sur l’inclusion ou le classement dans la recherche.
Microsoft ne respecte pas encore ce refus au niveau du site, la prise en charge est visée pour début 2027.
Obtenir le résumé de cet article par une IA
Refuser l’entraînement IA sans fermer la porte à la recherche
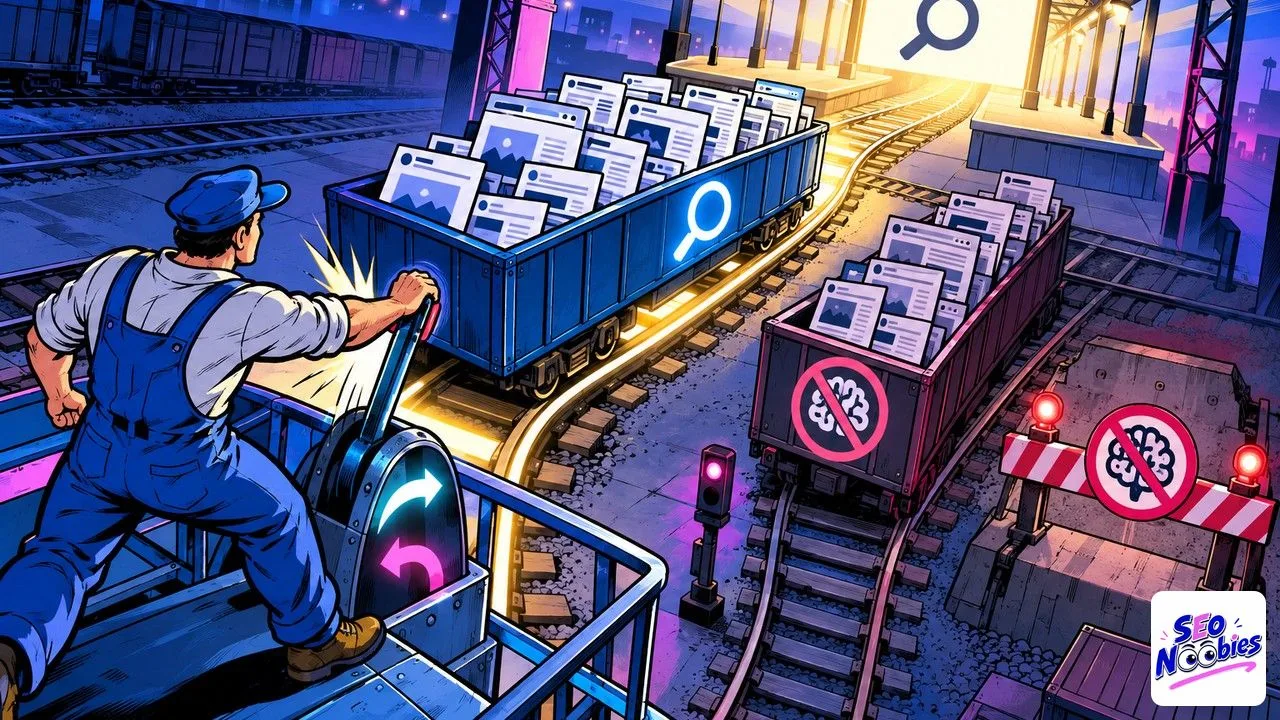
Le billet publié par Cloudflare s’intitule Have it both ways, stay discoverable in search while disallowing AI training, et son titre résume assez bien la promesse. Le nouveau réglage s’appelle Disallow AI Training. Une fois actif, il écrit dans votre fichier robots.txt un refus d’entraînement IA adressé aux robots concernés, et il laisse passer les robots de recherche de Google, d’Apple et de Microsoft.
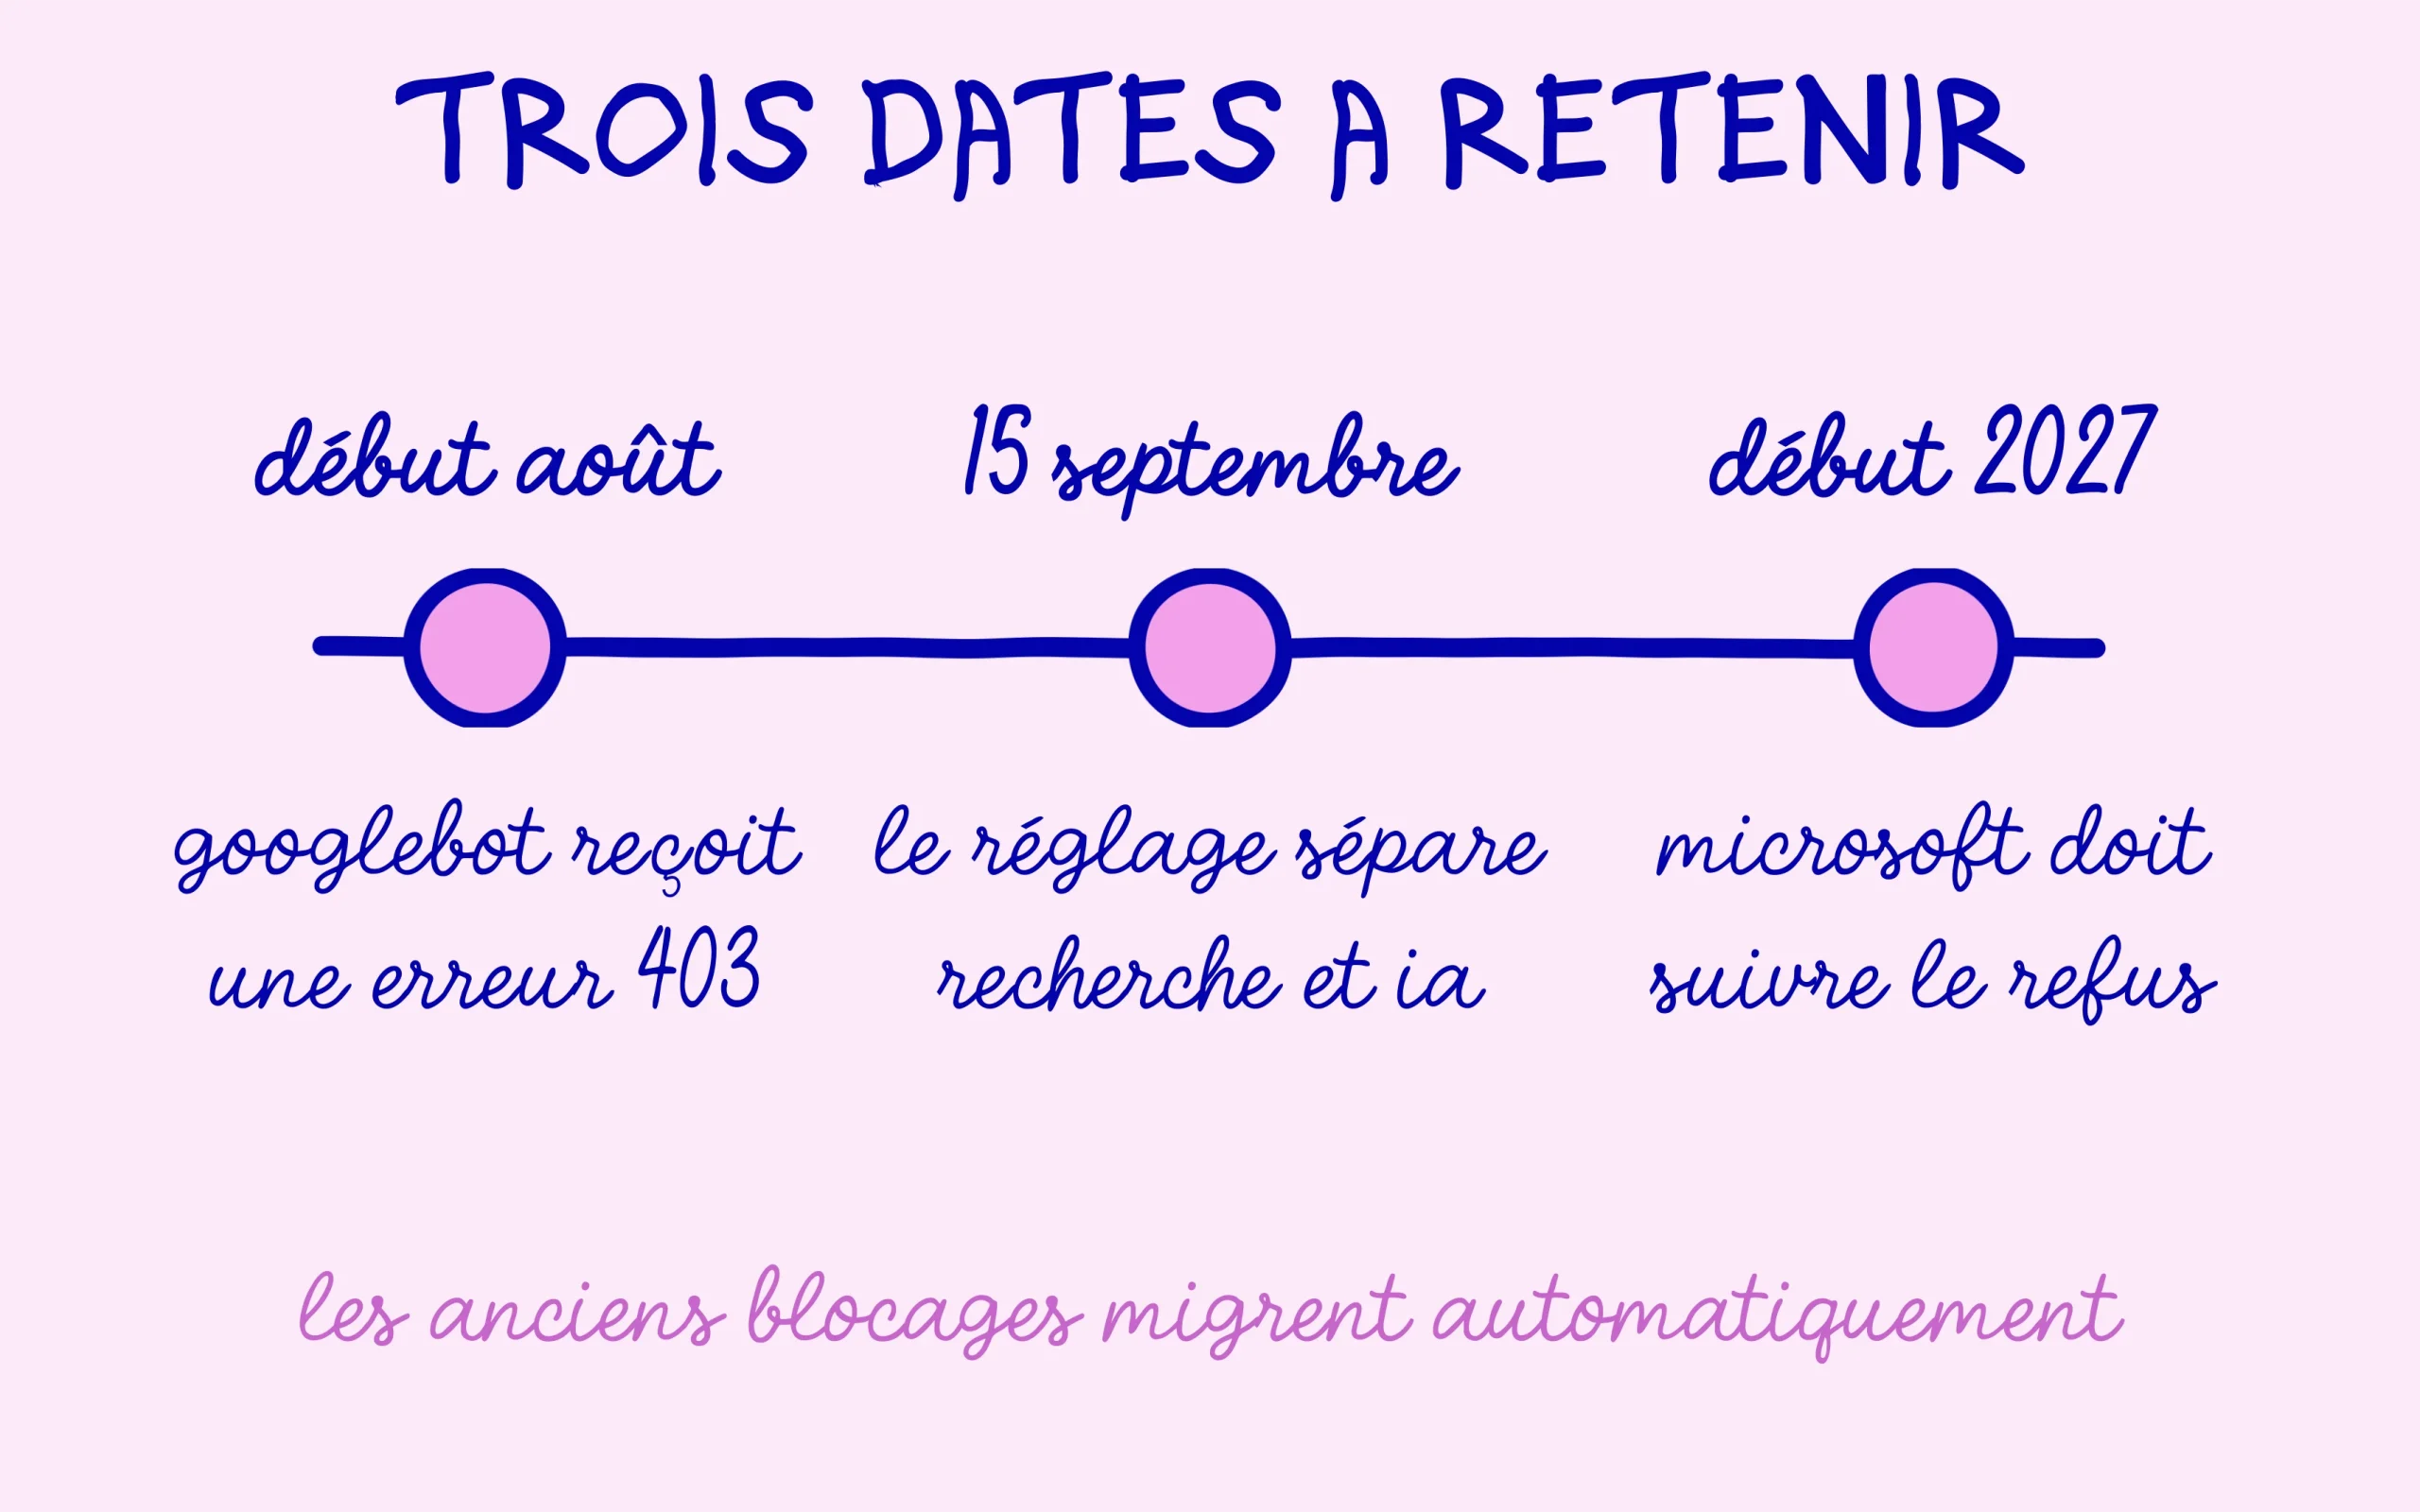
Pour mesurer ce que ça change, il faut revenir à la situation de l’été. Nous avions décrit début août comment Cloudflare renvoyait une erreur 403 à Googlebot quand le blocage de l’IA était actif. La raison tenait au fonctionnement des robots dits à double usage. Googlebot, Applebot et Bingbot explorent vos pages pour les classer dans la recherche, et une partie de ce qu’ils collectent peut aussi servir à des systèmes génératifs. En refusant l’entraînement, on refusait mécaniquement l’indexation.
Cloudflare le reconnaît noir sur blanc dans son billet. Les options Block et Block on pages with ads ne s’appliquaient pas aux robots mixtes, parce que les bloquer pouvait nuire à la visibilité dans la recherche. Autrement dit, la protection promise ne couvrait pas les robots qui comptent le plus pour un petit site, ou alors elle les couvrait au prix de son trafic.
Le nouveau réglage traite les deux familles de robots différemment. Les robots dédiés uniquement à l’entraînement IA, ceux d’Amazon, d’Anthropic, de Meta et d’OpenAI cités par Cloudflare, peuvent être bloqués directement. Les robots mixtes, eux, restent autorisés à explorer, et ils reçoivent un refus d’entraînement écrit dans le robots.txt qu’ils se sont engagés à respecter. Une préférence écrite remplace désormais le blocage réseau.
Un détail compte pour les sites déjà clients. Cloudflare précise que les anciennes sélections Block et Block on pages with ads migrent automatiquement vers Disallow AI Training. Si vous aviez coché l’une de ces deux options, vous n’avez donc rien à refaire pour sortir de la situation décrite en août. Le réglage est disponible pour tous les clients, sur toutes les formules, dans les paramètres de sécurité de chaque domaine.
Découvrir l’agence SEO Noobies
Google-Extended et Applebot-Extended, les deux jetons qui font le tri
Techniquement, tout repose sur un mécanisme que Google et Apple proposaient déjà. Chacun des deux a créé un jeton spécial à viser dans le robots.txt, distinct de son robot de recherche. Chez Google, ce jeton s’appelle Google-Extended. Chez Apple, c’est Applebot-Extended. Le réglage de Cloudflare se contente d’écrire une règle Disallow pour ces jetons, et de la maintenir à jour à votre place.
La question qui inquiète le plus un propriétaire de site trouve sa réponse côté Google. La documentation officielle des robots de Google explique que Google-Extended sert à décider si le contenu exploré peut entraîner les futures générations de modèles Gemini. Elle ajoute que ce jeton n’a aucun effet sur l’inclusion d’un site dans la recherche Google, et qu’il ne sert pas de signal de classement. Refuser l’entraînement Gemini ne vous coûte donc aucune position.
Il faut toutefois lire ce que la page ne dit pas. Elle parle de l’entraînement de Gemini et des applications qui s’en servent, sans jamais mentionner les AI Overviews ni le mode IA de la recherche. Rien ne permet d’écrire que ce réglage vous retire des résumés générés en haut de Google, et rien ne permet d’écrire le contraire non plus. Mieux vaut considérer ces deux sujets comme séparés tant que Google n’a rien publié de plus précis.
Le cas de Microsoft est différent. Cloudflare indique que Microsoft construit actuellement le mécanisme pour respecter un refus d’entraînement déclaré au niveau du site dans le robots.txt, avec un objectif fixé à début 2027. D’ici là, le réglage n’a pas d’effet équivalent sur les usages d’entraînement liés à Bingbot, même si le robot continue d’explorer pour la recherche.
Ce jeu de jetons ne concerne pas non plus les robots conversationnels qui vont chercher une page en direct pendant une question posée par un utilisateur. Ceux-là obéissent à leurs propres noms dans le robots.txt, et les confondre avec les robots d’entraînement reste l’erreur la plus fréquente. Nous avions détaillé ce piège à propos du robot de ChatGPT à ne pas bloquer par erreur dans le robots.txt.
Cloudflare ajoute une notion qu’il faut connaître pour lire la suite des annonces. L’entreprise qualifie de responsables les opérateurs de robots mixtes qui remplissent quatre conditions : proposer un refus par robots.txt, proposer un refus pour les résumés générés, donner de la visibilité sur l’usage des pages à l’entraînement, et garantir que ce refus ne touche pas au classement dans la recherche. Apple, Google et Microsoft sont présentés comme remplissant ces conditions ou s’étant engagés à les remplir dans un délai précis.
Ce qu’il reste à vérifier sur un site déjà chez Cloudflare
Commencez par ouvrir les paramètres de sécurité de votre domaine dans le tableau de bord Cloudflare et regardez la ligne consacrée à l’entraînement IA. Si elle affiche Disallow AI Training, la migration a bien eu lieu. Si elle affiche encore une autre valeur alors que vous pensiez avoir bloqué l’entraînement, c’est le moment de la corriger plutôt que d’attendre qu’un problème d’exploration le révèle.
Ensuite, ouvrez votre robots.txt dans un navigateur, en tapant simplement votre domaine suivi de /robots.txt. Les règles écrites par Cloudflare doivent y apparaître à côté des vôtres. Vérifiez qu’aucune ligne ne vise Googlebot tout court, parce qu’un Disallow sur le robot de recherche aurait un effet bien réel sur votre présence dans Google, sans rapport avec l’entraînement.
Troisième contrôle, le plus important si votre site a connu une baisse de trafic cet été. Regardez dans la Search Console si l’exploration est repartie normalement depuis la mi-septembre, et si des pages restent marquées comme bloquées ou en erreur. La marche à suivre complète se trouve dans notre guide pour vérifier l’indexation de votre site dans Google. Un réglage corrigé ne réindexe aucune page tout seul.
Un mot enfin sur les domaines qui arrivent sur la plateforme à partir de maintenant, puisque les réglages par défaut changent aussi. Sur un nouveau domaine qui affiche de la publicité, la catégorie entraînement IA démarre directement sur Disallow AI Training, alors qu’un site sans publicité reste sur Allow. La catégorie des agents, ces robots qui agissent en direct pour le compte d’une personne, démarre sur Block on pages with ads pour les sites financés par la publicité. Si vous créez un site dans les prochaines semaines, ouvrez donc ces deux lignes avant la mise en ligne, pour que le réglage corresponde à ce que vous voulez vraiment plutôt qu’à la valeur choisie pour vous.
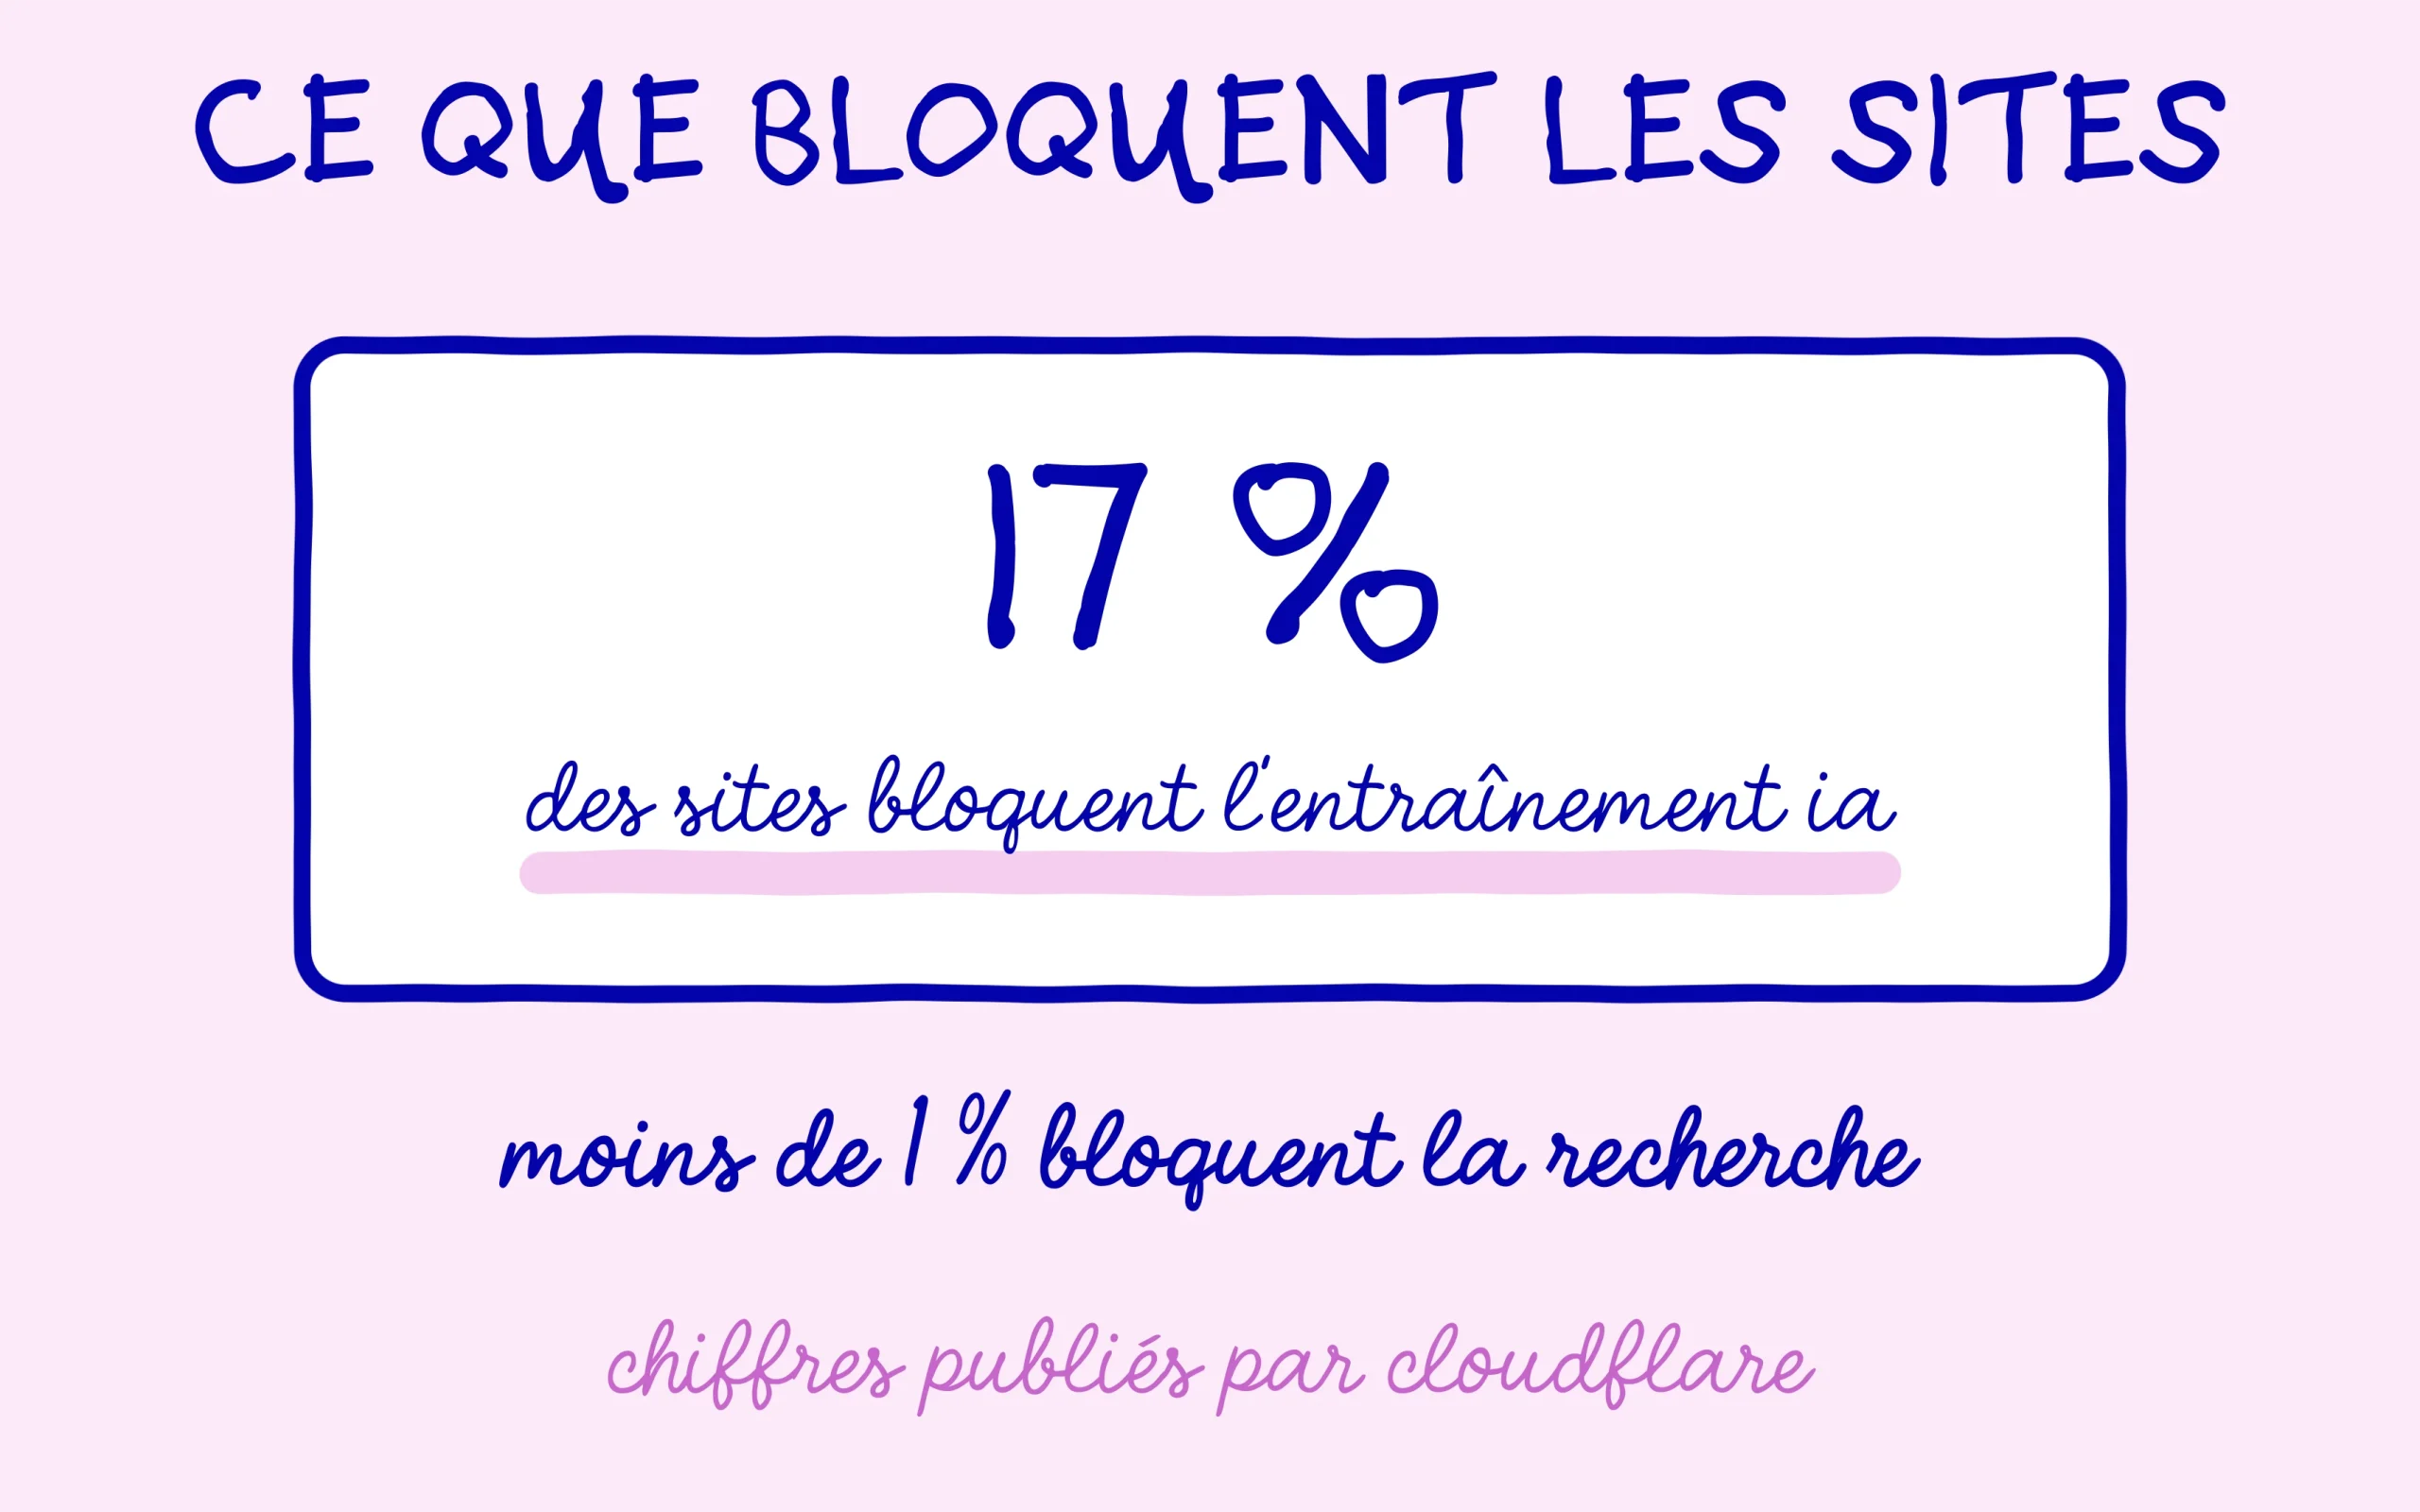
Il faut aussi remettre ce sujet à sa juste place. Cloudflare indique que 17 % des sites de son réseau activent un mécanisme de blocage de l’entraînement, et que moins de 1 % bloquent les robots de recherche. Pour la grande majorité des petits sites, ce réglage ne changera rien au quotidien. Il concerne d’abord ceux qui avaient pris une décision défensive sans en mesurer les conséquences sur leur visibilité.
Reste la question de fond, que chaque site doit trancher pour lui-même. Refuser l’entraînement IA protège votre contenu d’un usage sans contrepartie, et ce réglage le permet désormais sans sacrifier la recherche chez Google et Apple. Cela dit, la visibilité dans les réponses générées dépend d’autres robots et d’autres règles. Si votre objectif est d’être cité par les assistants, relisez vos directives robot par robot avant de tout fermer par principe.
Continuez de progresser sur SEO Noobies.