Vous ouvrez le robots.txt de votre site passé derrière Cloudflare, et vous découvrez des lignes que vous n’avez jamais écrites : une directive Content Signals, ajoutée automatiquement par votre fournisseur d’infrastructure. Premier réflexe de débutant : paniquer et se demander si le référencement du site est en danger. La bonne nouvelle, c’est que ce fichier fait peur pour rien : quelques lignes de texte dans un document que vous pouvez ouvrir avec le Bloc-notes, et une mécanique de lecture très simple à comprendre. Google vient d’ailleurs de confirmer que cette directive Cloudflare n’a aucun effet sur ses robots. On va regarder ce que Cloudflare a ajouté exactement, ce que Google en dit, puis relire ensemble ce que le robots.txt fait vraiment et ne fait pas.
En bref
Cloudflare insère une directive Content Signals dans le robots.txt des sites qu’il gère, censée encadrer l’usage du contenu par les crawlers et les IA.
John Mueller confirme que cette directive n’a aucun effet : Google ne la reconnaît pas, pas plus que llms.txt ou llms-author.txt.
La mécanique à retenir : un crawler n’applique que les directives qu’il reconnaît explicitement et ignore silencieusement tout le reste du fichier.
L’action du jour : ouvrir votre robots.txt, vérifier ce qu’il contient, et le garder court avec des directives standards uniquement.
Résumer cet article avec une IA
ChatGPTCe que Cloudflare ajoute exactement dans vos fichiers robots.txt
Le diagnostic commence par les faits. La directive s’appelle Content Signals et son intention se comprend : donner aux éditeurs un moyen d’exprimer ce que les robots peuvent faire de leur contenu, à l’heure où les crawlers IA aspirent le web pour entraîner des modèles. Elle distingue trois catégories d’usage : Training pour l’entraînement des modèles, Agent pour les agents IA qui naviguent, et Search pour la recherche classique. Cloudflare a fixé une échéance au 15 septembre 2026 pour ses nouveaux réglages par défaut : sur les nouveaux domaines, Training et Agent seront bloqués d’office sur les pages contenant de la publicité, tandis que Search restera autorisé.
Le piège technique classique se situe exactement là : une directive n’a de valeur que si le robot qui lit le fichier la reconnaît. Or aucun moteur de recherche ni crawler majeur n’a adopté ce standard, que Cloudflare a lancé sans accord préalable des acteurs qui lisent réellement les fichiers robots.txt. La démarche rejoint la vague des signaux inventés pour les bots IA, comme ce fameux fichier llms.txt dont l’étude Ahrefs sur 137 000 sites avait déjà montré l’adoption sans effet mesurable. Concrètement, ces lignes vivent maintenant dans un fichier que vous pensiez contrôler, ajoutées par votre infrastructure et non par vous, et elles intrigueront le prochain audit qui passera dessus.
La réponse de John Mueller : aucun effet, du poids en plus
La réaction de Google est venue par John Mueller, sur Reddit. La directive Content Signals n’a aucun effet sur les crawlers ni sur les LLM, et elle ajoute du poids inutile au fichier robots.txt. Mueller précise au passage que Google ne reconnaît ni llms.txt, ni llms-author.txt, ni les directives content-signal insérées dans le robots.txt. La liste des règles que Google lit est courte, publique et documentée, tout le reste est ignoré.
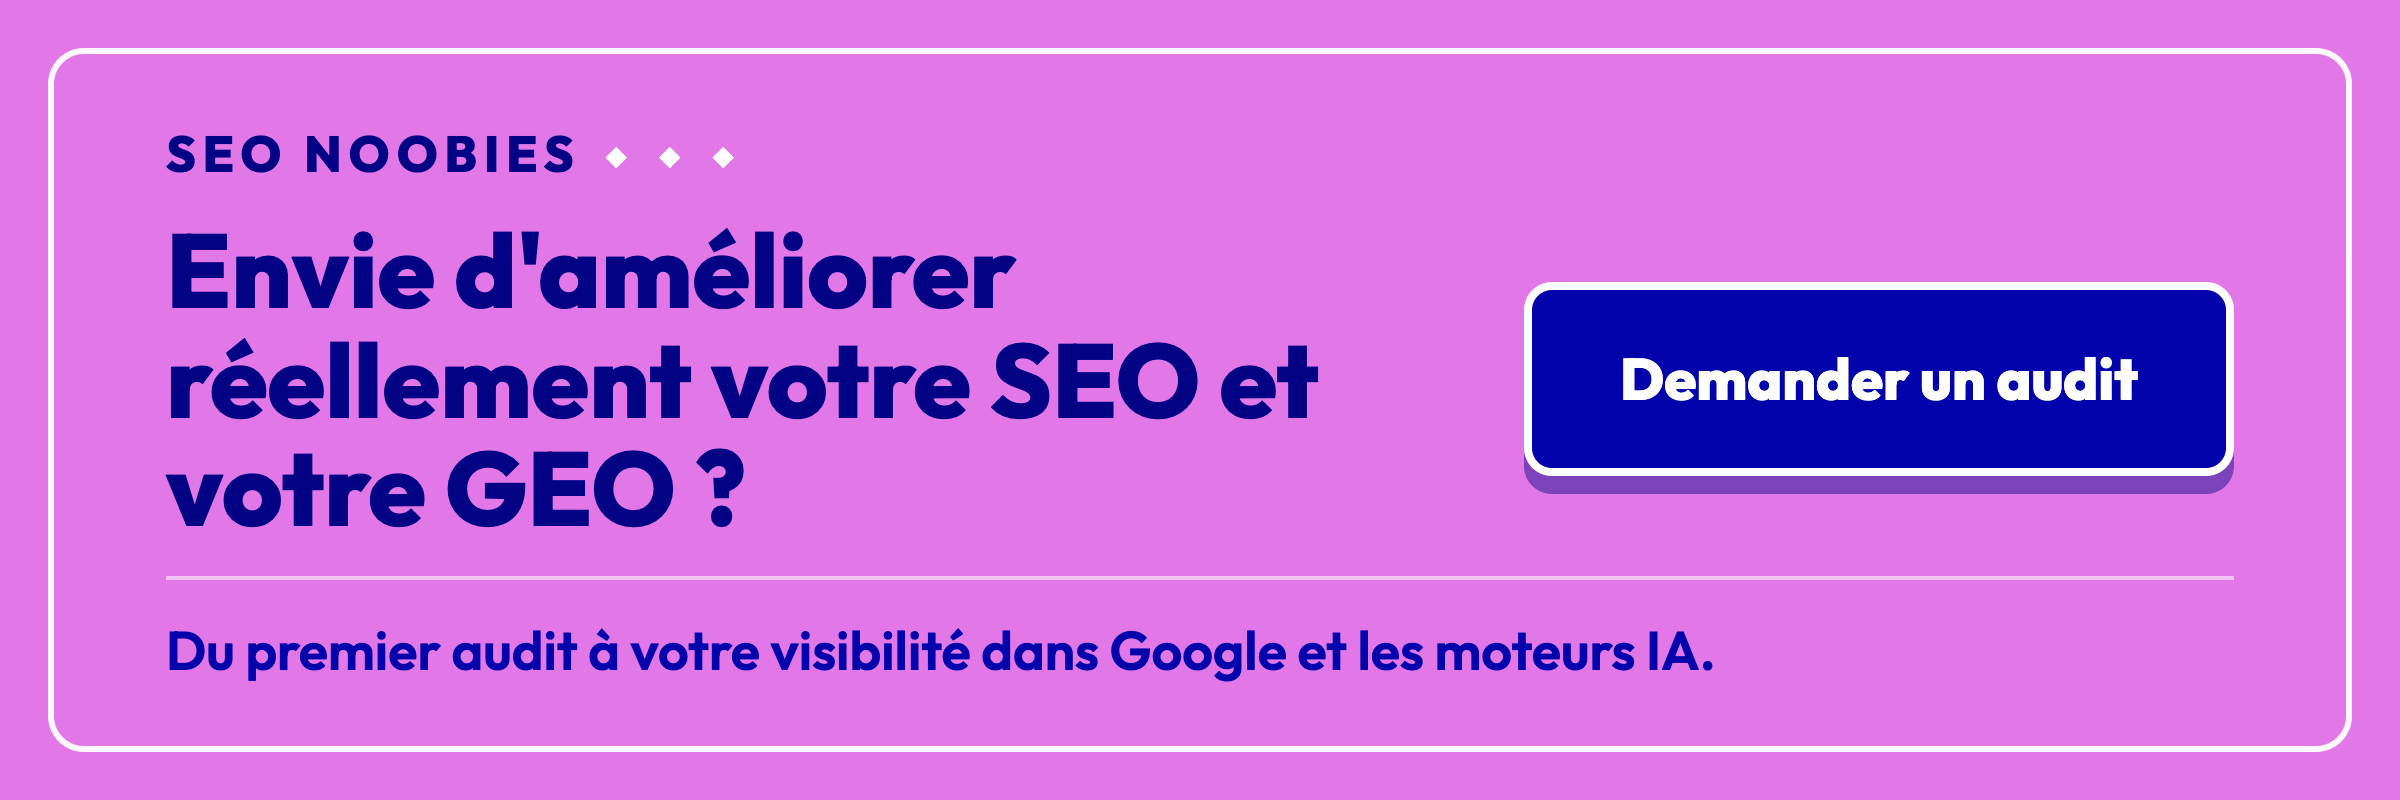
La mécanique sous-jacente explique tout, et elle tient en une règle : un crawler n’applique que les directives qu’il reconnaît explicitement. Tout ce qui ne fait pas partie de son vocabulaire est ignoré en silence, sans erreur, sans avertissement. Vous pouvez écrire ce que vous voulez dans un robots.txt, y compris des demandes polies aux IA, le robot qui passe n’en tiendra compte que si sa spécification le prévoit. C’est le même Mueller qui, quelques jours plus tôt, rappelait qu’un site séparé pour les IA ne sert à rien : les moteurs travaillent avec leurs standards publics, jamais avec les inventions unilatérales.
Toutefois, l’initiative de Cloudflare documente une vraie demande du marché : les éditeurs veulent un levier de contrôle sur l’usage IA de leur contenu, et les standards existants ne le leur donnent pas complètement. La directive ne produit rien aujourd’hui, mais la pression qu’elle exprime finira probablement par déboucher sur un standard négocié avec les moteurs. En attendant, elle ne change rien à votre référencement, ni en bien ni en mal, et aucune manipulation n’est requise de votre côté.
Relire son robots.txt : ce qu’il fait, ce qu’il ne fera jamais
Avant de toucher quoi que ce soit, il faut repartir de la définition officielle, qui tient en une ligne : le robots.txt indique aux robots d’exploration quelles URL ils peuvent visiter sur votre site. Son rôle premier est de gérer le trafic de crawl, éviter qu’un robot ne surcharge le serveur ou ne perde son temps sur des pages sans intérêt ou des doublons. Un outil d’aiguillage pour le trafic des robots, comparable à la signalétique à l’entrée d’un bâtiment : utile pour orienter les visiteurs légitimes, inutilisable comme verrou. Cette logique d’exploration à standards stricts est la même que celle qui régit les délais de réévaluation des canonicals par Google : des règles précises, des délais réels, zéro place pour l’improvisation.
Le symptôme qui trahit l’erreur la plus répandue : une page que vous avez bloquée dans le robots.txt continue d’apparaître dans les résultats Google, sans description. Le diagnostic est documenté noir sur blanc : ce fichier n’est pas un mécanisme pour garder une page hors de Google. Une URL bloquée au crawl peut parfaitement rester indexée si d’autres pages pointent vers elle. Google détaille les usages corrects dans son introduction officielle au fichier robots.txt. La correction est à votre portée : pour retirer réellement une page de l’index, utilisez une balise noindex ou une protection par mot de passe, jamais un blocage robots.txt.
Point de vigilance pour finir : tous les robots n’obéissent pas au robots.txt. Les moteurs sérieux le respectent, les crawlers douteux s’assoient dessus, et les différents robots peuvent interpréter la syntaxe différemment, ce qui rend les combinaisons de règles complexes risquées quand on débute. Le réflexe à prendre est simple et se vérifie en deux minutes : ouvrir votredomaine.com/robots.txt dans un navigateur, lire ce qui s’y trouve, et s’assurer que chaque ligne correspond à une directive documentée par les moteurs. Un fichier court, des directives standards, zéro fantaisie. L’affaire Cloudflare le confirme à l’échelle industrielle : même un géant de l’infrastructure ne peut pas inventer un standard tout seul.