On imagine généralement que les recommandations ChatGPT sortent d’une exploration du web, comme si le modèle partait comparer les options disponibles avant de répondre. Une analyse du trafic réseau de l’application montre un déroulé assez différent, où le choix se dessine une étape plus tôt, au moment où le modèle rédige lui-même sa requête de recherche. Cette requête contient déjà, très souvent, des noms de marques que personne n’a tapés. Pour un site qui cherche à être cité par les IA, ce détail technique change complètement l’endroit où se joue la partie.
En bref
Sur 27 conversations observées, la première requête écrite par ChatGPT contenait dans 21 cas des marques que l’utilisateur n’avait jamais mentionnées.
Une marque nommée dans cette requête ressort citée dans 68,9 % des réponses, contre 2,1 % pour une marque simplement trouvée pendant la recherche.
Sur environ 3 554 pages récupérées, 110 seulement ont été citées, soit 3,1 %.
Peser sur les recommandations ChatGPT demande d’être déjà connu du modèle, et cela se construit ailleurs que sur votre site.
Résumer cet article avec une IA
ChatGPTCe que l’analyse a repéré dans les requêtes écrites par ChatGPT
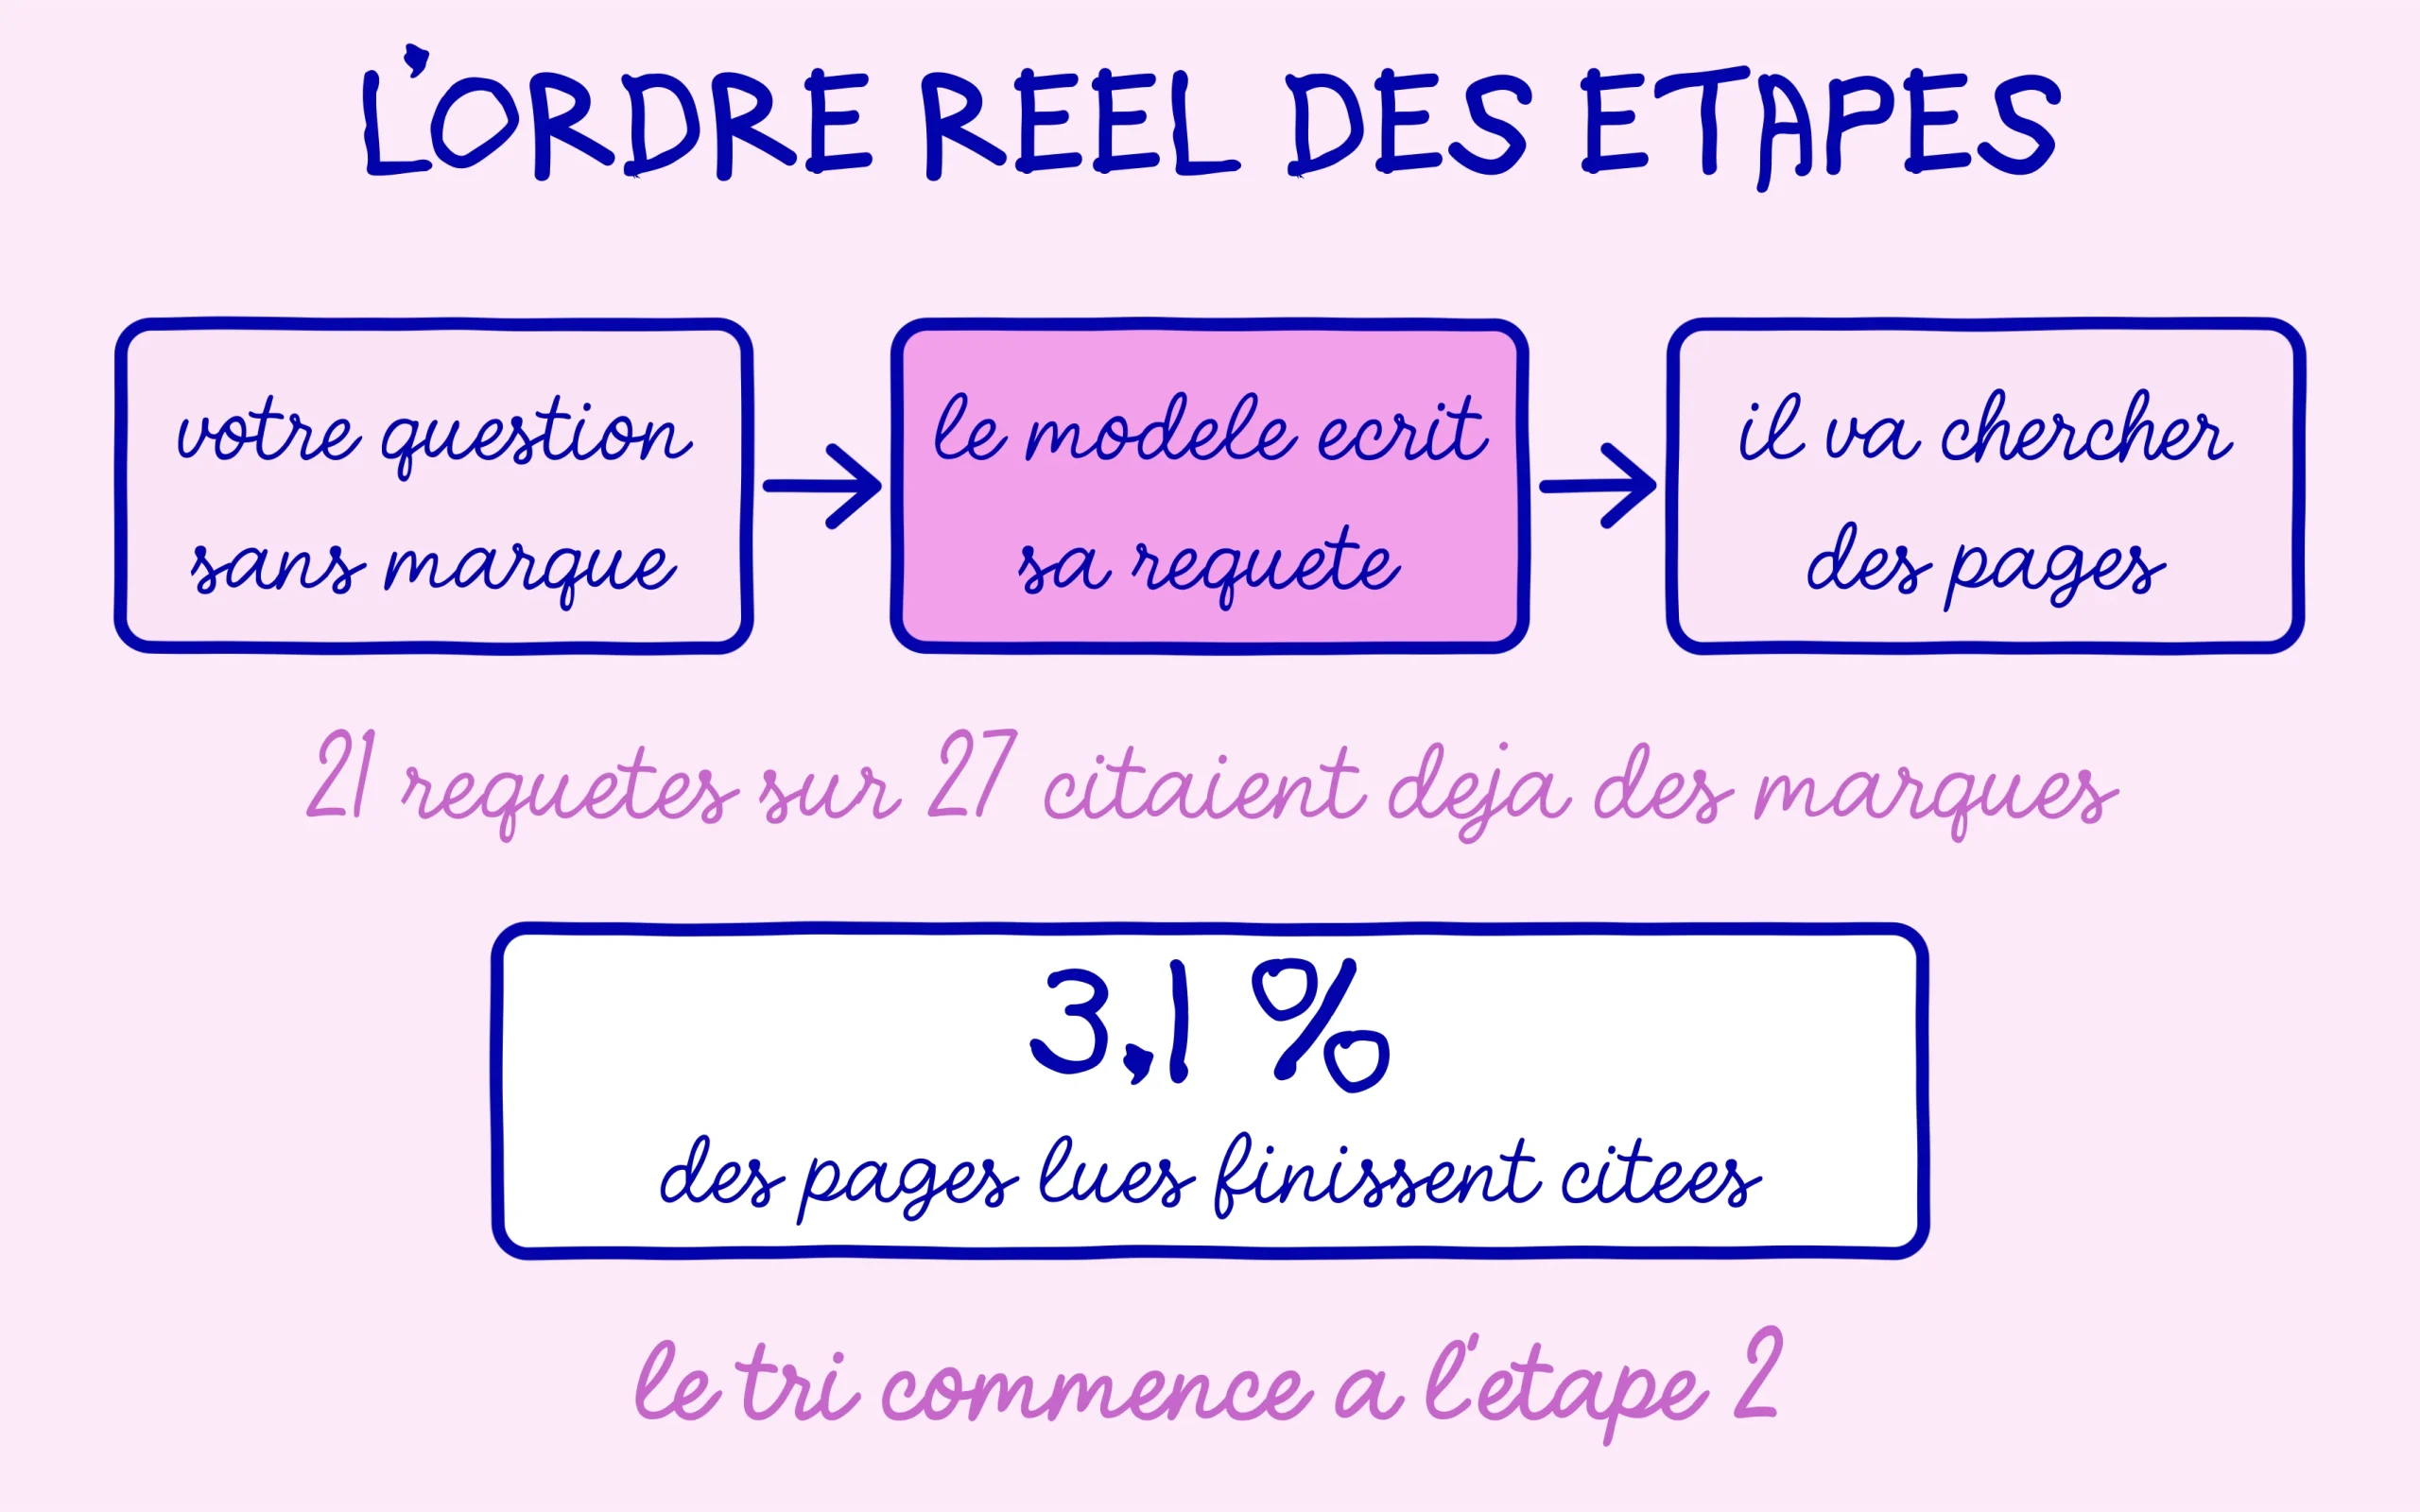
La méthode employée par le consultant SEO Suganthan Mohanadasan est simple à comprendre, et c’est ce qui la rend intéressante. En ouvrant les outils de développement du navigateur pendant une conversation, on voit passer les appels réseau que l’application envoie. Une clé de ce flux contient les requêtes de recherche que ChatGPT s’écrit à lui-même avant d’aller chercher quoi que ce soit. On y lit donc, en clair, ce que le modèle a décidé de chercher à partir de votre demande. C’est le même terrain d’observation que celui qui nous avait servi à comprendre pourquoi les citations ChatGPT varient autant d’un secteur à l’autre.
Le résultat est assez frappant. Sur 27 conversations testées avec des demandes de type « recommande-moi un outil pour faire X », la première requête contenait des marques dans 21 cas alors que l’utilisateur n’en avait cité aucune. Le modèle ne demande pas au web quelles sont les options du marché. Il pioche des noms dans ce qu’il a appris pendant son entraînement, les insère dans sa requête, puis va chercher des pages qui parlent de ces noms précis. Les recommandations ChatGPT arrivent donc déjà largement écrites au moment où la recherche démarre.
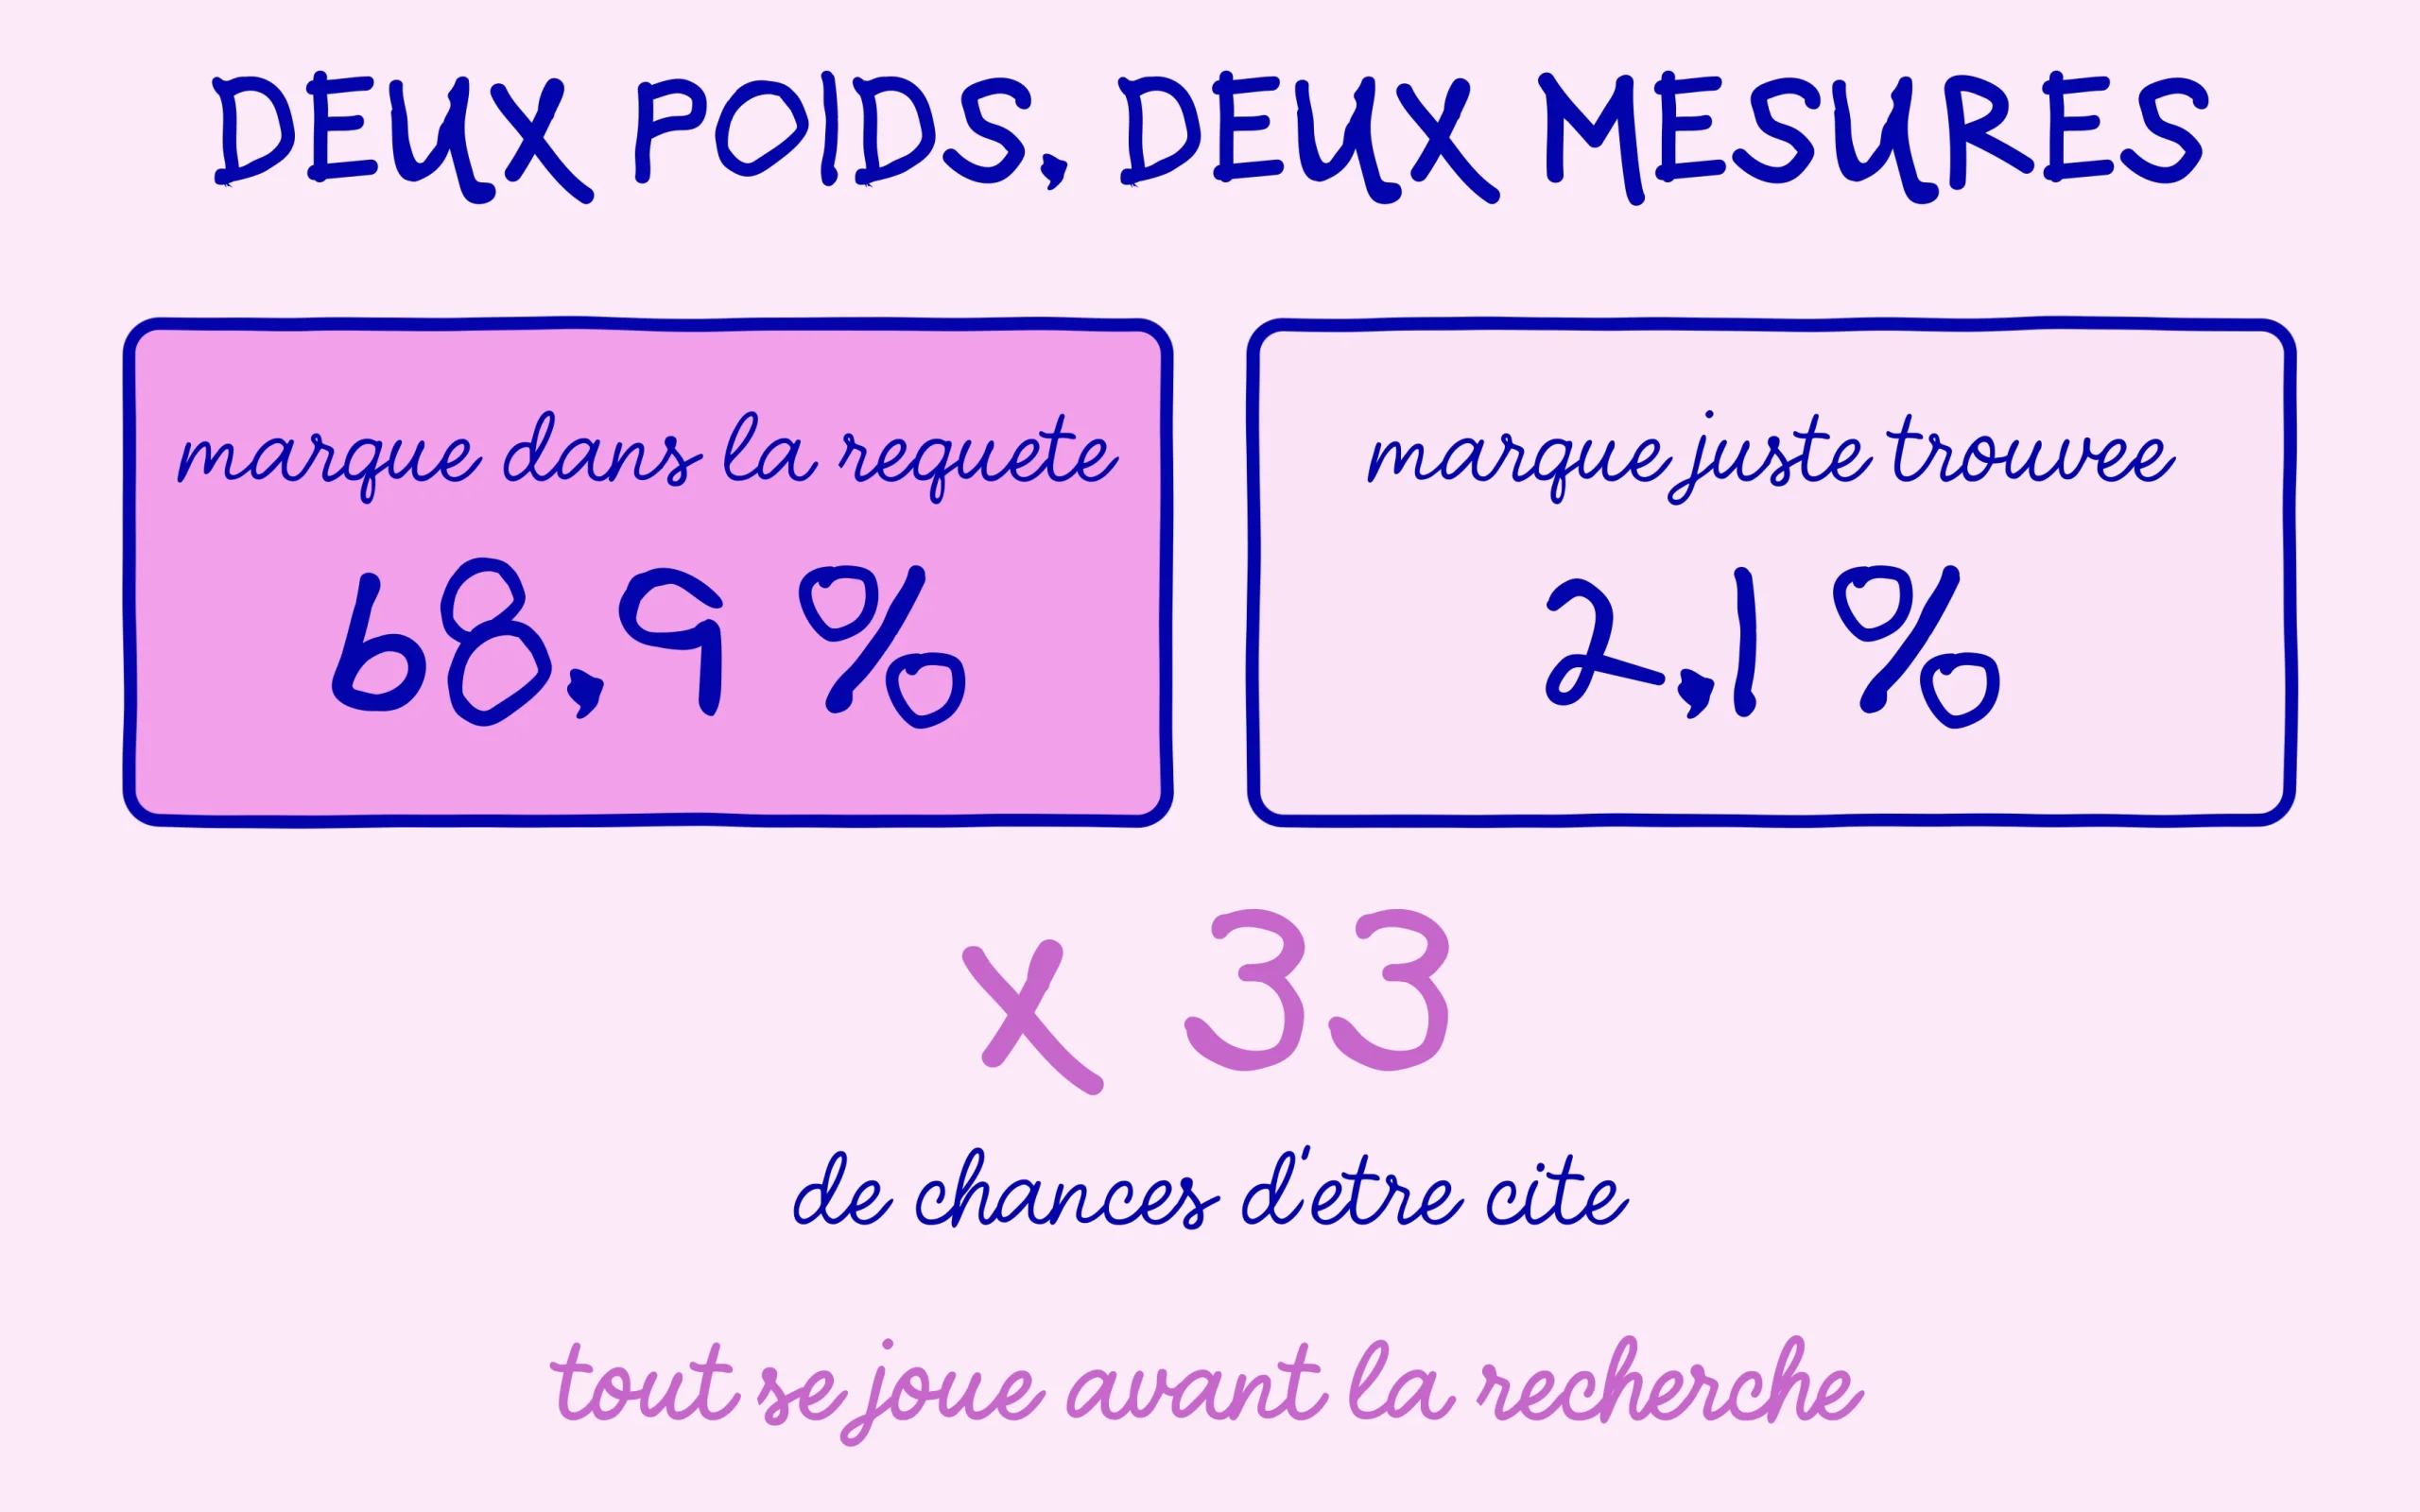
Là où ça devient vraiment parlant pour un débutant, c’est dans l’écart de traitement entre les deux populations de marques. Une marque présente dans la requête initiale finit citée dans 68,9 % des réponses. Une marque qui n’apparaît que parce qu’une page la mentionne, récupérée en cours de route, tombe à 2,1 %. Le rapport est d’environ 33 pour 1. C’est un ordre de grandeur qu’on retrouve rarement en SEO classique, où les écarts entre première et deuxième position se comptent en points de pourcentage.
Le reste des chiffres dessine un entonnoir très serré. Environ 3 554 pages ont été récupérées sur l’ensemble des conversations analysées, et 110 d’entre elles ont fini citées, soit 3,1 %. La position dans le groupe de résultats compte aussi : une page arrivée en première place est citée dans 5,2 % des cas, contre 0,3 % à partir de la sixième. Le même phénomène de tri qu’on observe sur une page de résultats classique se rejoue donc à l’intérieur du raisonnement du modèle, en plus brutal. Si ce mécanisme de sélection vous intéresse, il complète bien ce qu’on avait vu sur la manière dont l’index de ChatGPT choisit les pages qu’il cite.
Pourquoi les recommandations ChatGPT dépendent d’abord de la mémoire du modèle
Ce comportement s’explique assez bien quand on se rappelle comment ces systèmes sont construits. Un modèle de langage a digéré une quantité énorme de texte public avant d’être mis en ligne. Les marques qui revenaient souvent dans ce texte, associées à leur catégorie, sont devenues des réponses probables. Quand vous posez une question de recommandation sans nommer personne, le modèle produit ces noms-là par défaut, exactement comme il produirait n’importe quel mot attendu. Une étude publiée par Semrush sur plus de 50 000 marques et 1 094 catégories américaines, suivies pendant six mois, donne une idée de la solidité de ces positions : une marque en tête sur son sujet avec cinq points d’avance garde sa place d’un mois sur l’autre dans 90,4 % des cas, et seuls 15,2 % des sujets ont un propriétaire clair. Le détail figure dans l’analyse de la visibilité par sujet menée sur 50 000 marques.
La recherche web arrive après, et son rôle ressemble davantage à une vérification qu’à une exploration. Elle sert à confirmer, à dater, à sourcer ce que le modèle avait déjà en tête. Une page excellente sur un sujet donné peut donc être lue sans jamais peser sur les recommandations ChatGPT, simplement parce que la marque qu’elle défend n’était pas dans la requête de départ. Le tri se fait avant que votre serveur ne reçoive la moindre visite, ce qui explique pourquoi tant de sites bien optimisés ne voient jamais leur nom apparaître.
Un détail va à l’encontre de l’intuition et mérite qu’on s’y arrête. Multiplier les pages d’un même domaine dans les résultats ne multiplie pas les chances d’être cité. Deux pages du même site qui remontent ensemble atteignent 6,2 % de citation, ce qui est le meilleur score observé. À partir de six pages, le taux redescend à 1,7 %. Publier quinze articles quasi identiques sur une requête ne fait donc pas monter la probabilité de citation, elle la fait baisser. Le protocole complet et les relevés bruts figurent dans l’analyse publiée par Suganthan Mohanadasan sur son blog.
Autant poser les limites tout de suite, parce qu’elles sont réelles. Ces mesures viennent d’un seul compte ChatGPT Plus, relevées à Dubaï les 24 et 25 juillet 2026, avec un périmètre concentré sur les logiciels et les outils d’intelligence artificielle. Suganthan Mohanadasan le dit lui-même dans sa publication : ces pourcentages indiquent une direction, ils ne constituent pas une mesure de marché. Autre chose se remarque à la lecture de son analyse, elle ne s’appuie sur aucun travail extérieur au sien et ne cite aucune autre source que ses propres relevés. Ça n’enlève rien à la méthode, ça situe simplement ce qu’on tient : une observation à confirmer, pas un résultat établi. Sur une catégorie moins couverte par l’entraînement du modèle, comme un service local ou une niche récente, la mécanique de sélection pourrait très bien s’équilibrer autrement.
Ce qu’un site qui débute peut tirer de cette découverte
La première conclusion pratique n’est pas très agréable à entendre quand on part de zéro. Entrer dans la requête que le modèle s’écrit à lui-même se joue en dehors de votre site, dans les endroits où votre nom circule. votre nom circule avant que votre site n’existe pour le modèle. Les pages qui listent des outils, les discussions de forum, les comparatifs tenus par d’autres, les mentions dans des articles de niche. Ce sont ces textes-là que le modèle a lus, et c’est leur accumulation qui a rendu certains noms probables.
Cela dit, la partie « être trouvable » garde toute son utilité, et il serait dommage de la lâcher sur la foi d’un seul chiffre. Une marque déjà connue du modèle a encore besoin de pages propres, claires et à jour pour que la vérification confirme ce qu’il avance. Sans cela, le modèle cite un concurrent qui documente mieux la même chose. Ces deux couches se complètent, et négliger la seconde revient à gagner le casting pour rater l’audition.
Concrètement, il y a un test à faire ce soir et il ne coûte rien. Posez à ChatGPT trois questions de recommandation dans votre domaine, sans jamais nommer votre marque, puis regardez quels noms sortent. Vous obtenez la liste des concurrents qui occupent les recommandations ChatGPT par défaut sur votre catégorie. Refaites l’exercice dans un mois. C’est une mesure imparfaite, elle reste la plus accessible pour savoir si vous existez dans cette première étape.
Reste la question du tempo, et elle n’a pas de réponse tranchée aujourd’hui. Un modèle réentraîné intègre les mentions accumulées depuis sa dernière version, ce qui veut dire que le travail fait maintenant se paie plus tard, sans calendrier annoncé. Les sources que les IA reprennent le plus volontiers donnent une piste sur où concentrer ses efforts, comme le montrent les plateformes que les IA citent bien plus que les médias. Publier régulièrement et se faire mentionner ailleurs reste le seul levier stable sur cette couche.
Continuez de progresser sur SEO Noobies.
[…] Est-ce que ça veut dire qu’on saura enfin pourquoi ChatGPT cite un site plutôt qu’un autre ? Honnêtement, il ne faut rien en attendre à court terme. Les obligations portent sur les risques et la modération, pas sur la recette du classement. Ce qu’on peut espérer, c’est un peu plus de matière publique pour comprendre le fonctionnement, dans la lignée de ce qu’on observe déjà en creusant la façon dont ChatGPT construit ses recommandations. […]
[…] Le comportement dominant reste donc mixte, ce qui rejoint ce qu’on observait déjà quand les recommandations de ChatGPT se jouaient largement avant la recherche elle-même, dans ce que le modèle avait déjà […]